AI×法務
忘却対応AI、学習時に記憶の保持が必要と判明
学習済みモデルと消去対象だけで特定データを忘れさせる手法には、理論上の限界があると判明した。確実に忘れさせるには学習時に多くの情報を残す設計が要り、個人データ削除対応の運用に影響する。
学習済みモデルと消去対象だけで特定データを忘れさせる手法には、理論上の限界があると判明した。確実に忘れさせるには学習時に多くの情報を残す設計が要り、個人データ削除対応の運用に影響する。
GNNの知識をグラフ不要の軽量MLPへ移す蒸留で、教師の幾何構造を守る場所をOllivier-Ricci曲率で定める新手法G²MLPが提案された。高精度と高速推論の両立に道を開く成果である。
研究チームが、動画生成AIの内部表現を圧縮しつつ品質を保つ手法GRACEを発表した。トークン数を8分の1、遅延を11.1分の1に減らし、動画制作の計算コストを下げる道を開く。
視覚言語行動モデルは指示の一語の違いで成功率が大きく変わる。米研究者らは方策を改変せず、指示を事前に言い換える規則で未知タスクの成功率を高める手法を示した。
中央サーバーなしで複数拠点が協調学習する分散SGDに勾配クリッピングを加えるだけで、重い裾のノイズ下でも理論上最適な収束率と参加数に比例した高速化が得られると示された。
Long-WAMは最大19.2秒の映像履歴を使い、ロボットの操作成功率を63.3%から78.7%へ高めた。履歴の長さより事前学習の方式が効果を左右する点が、現場導入の鍵となる。
研究チームは、条件付きメモリを持つ大規模言語モデルで、本体を変えずに事実知識だけを書き換える手法EngramEditを提案した。再学習なしで規程や仕様の改定に追随できる可能性を示す成果である。
AIの推論訓練で、新しい解法を探す役と学習する役を分ける手法ExpDisが提案された。同一の計算時間で既存手法DAPOを上回り、多様な正解を出す力も高めた。
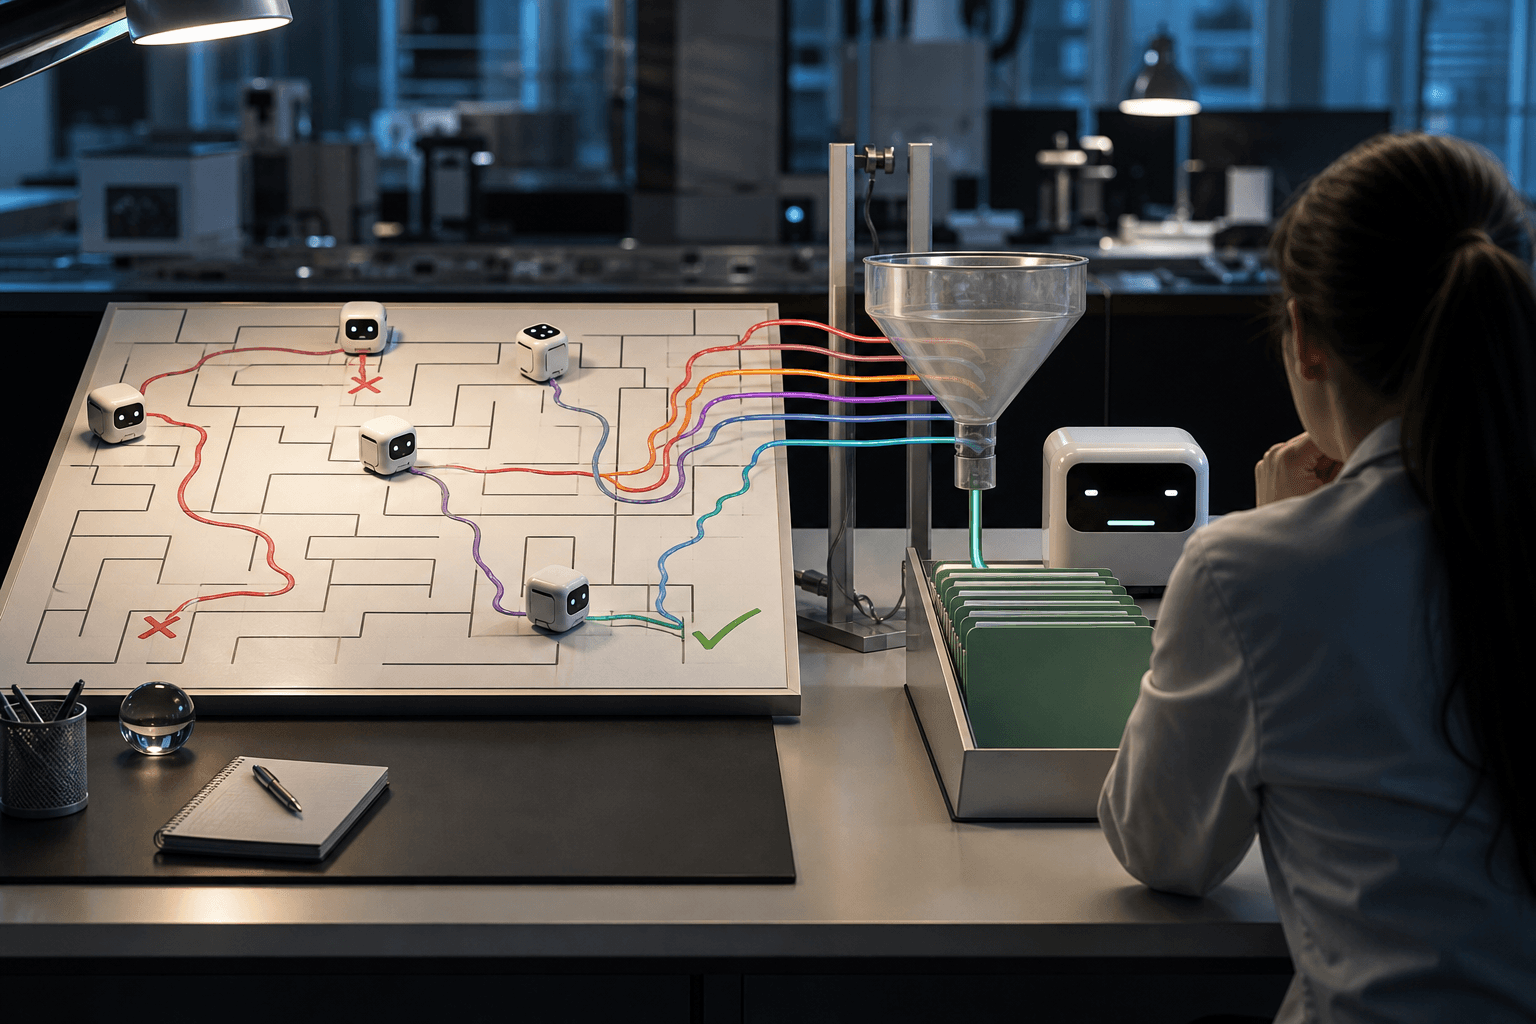
egocentric映像から物の位置・履歴・文脈を3D記憶に蓄える「Ledger」が登場した。元映像を再参照せず空間質問に答え、HD-EPICの精度を29.7%から42.6%へ高めた。
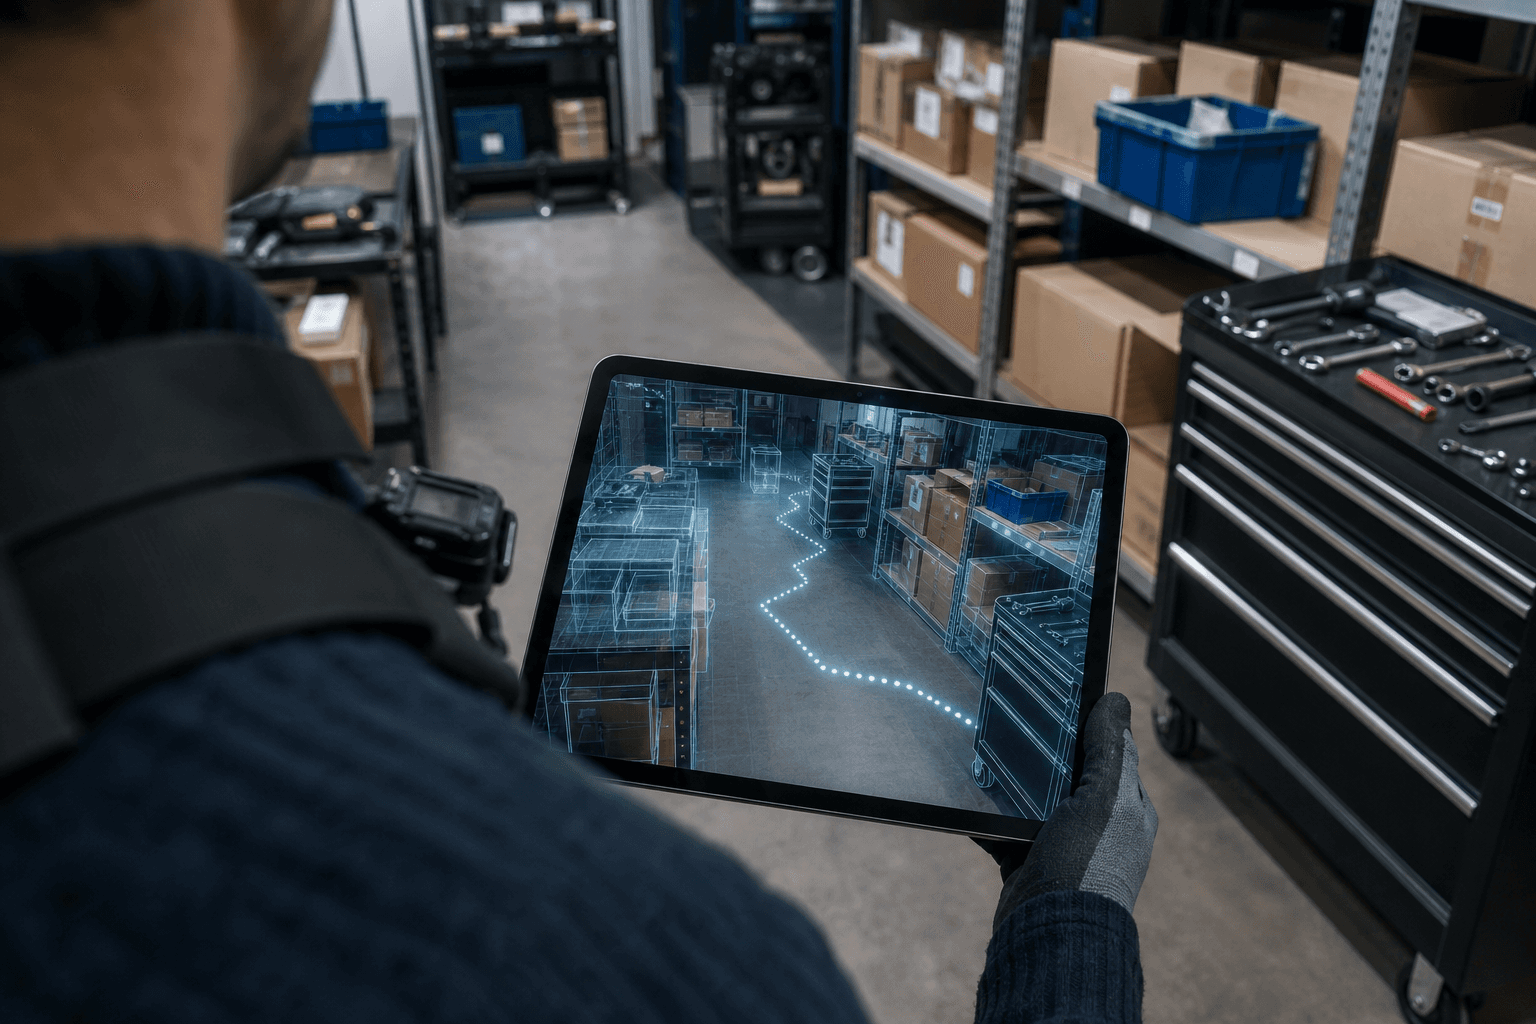
韓国の研究チームが、1枚の画像から周囲の物体との位置関係を踏まえて3D空間を再構築するTetris3Dを発表した。物理的に破綻しない配置を自動で得られ、設計や小売の現場での活用が見込まれる。
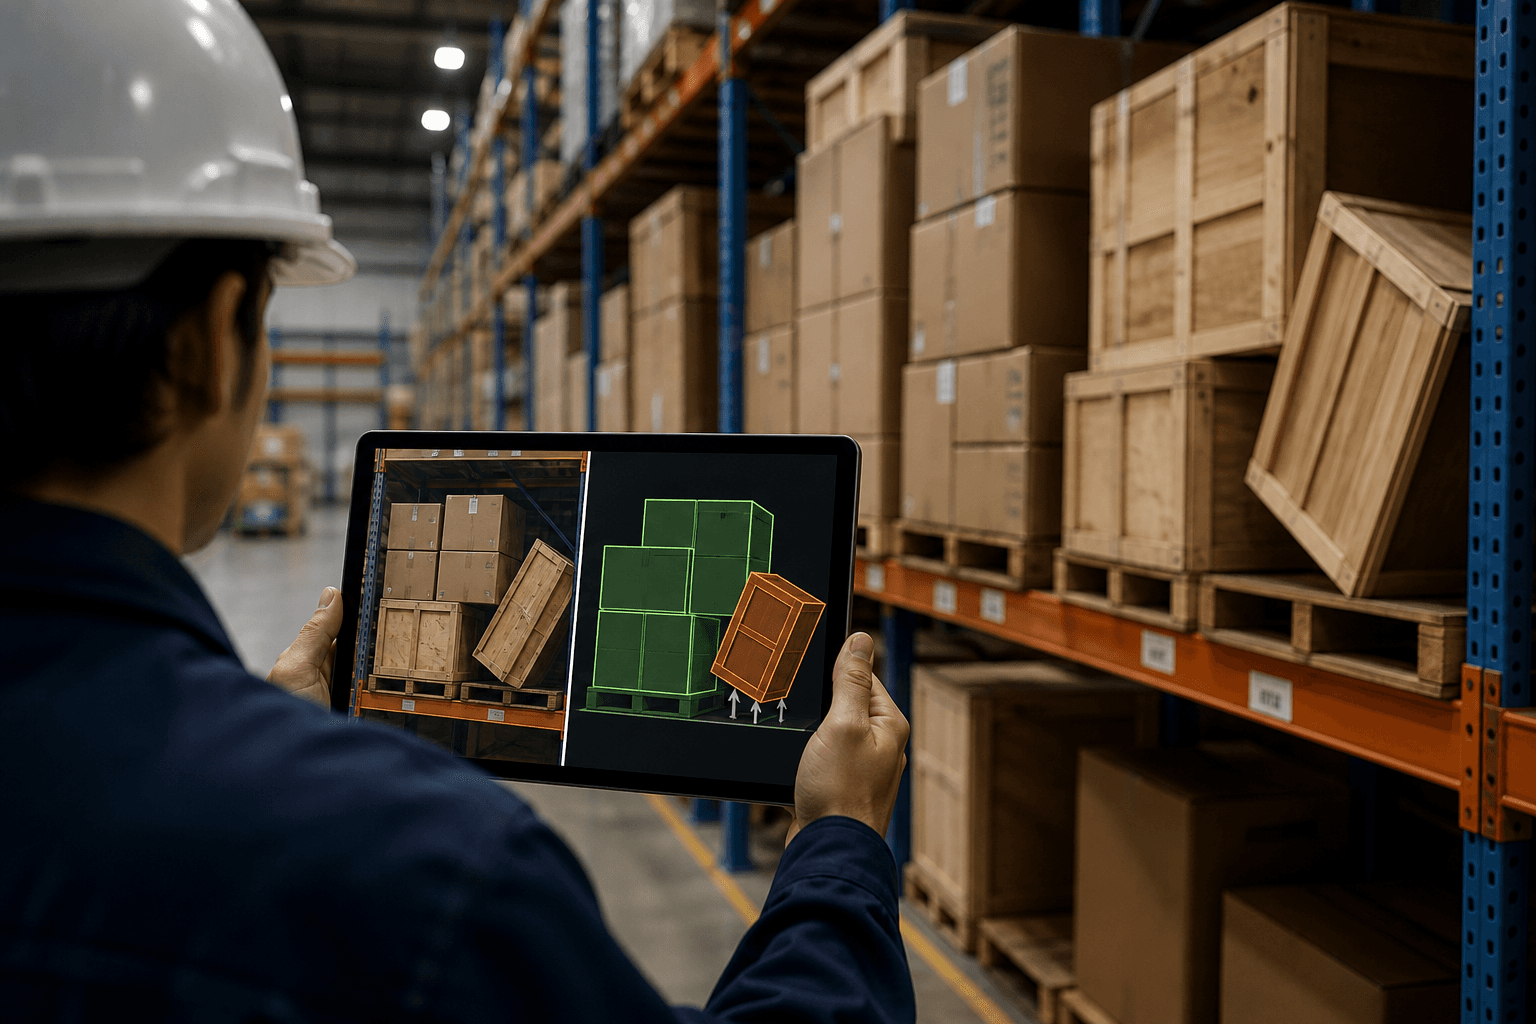
対話型の動画世界モデルで、ユーザー操作の変化に応じ計算を使い分ける手法CtrlCacheが提案された。再学習なしでDiT部の処理を1.21〜1.41倍に高速化し、品質評価も上回った。
学習者の成績向上を報酬に強化学習で訓練したAI講師「Sherpa」が、生徒タイプ別の指導を使い分け、全タイプで平均20.5ポイントの成績向上を示した。AI研修の個別最適化に道を開く成果である。
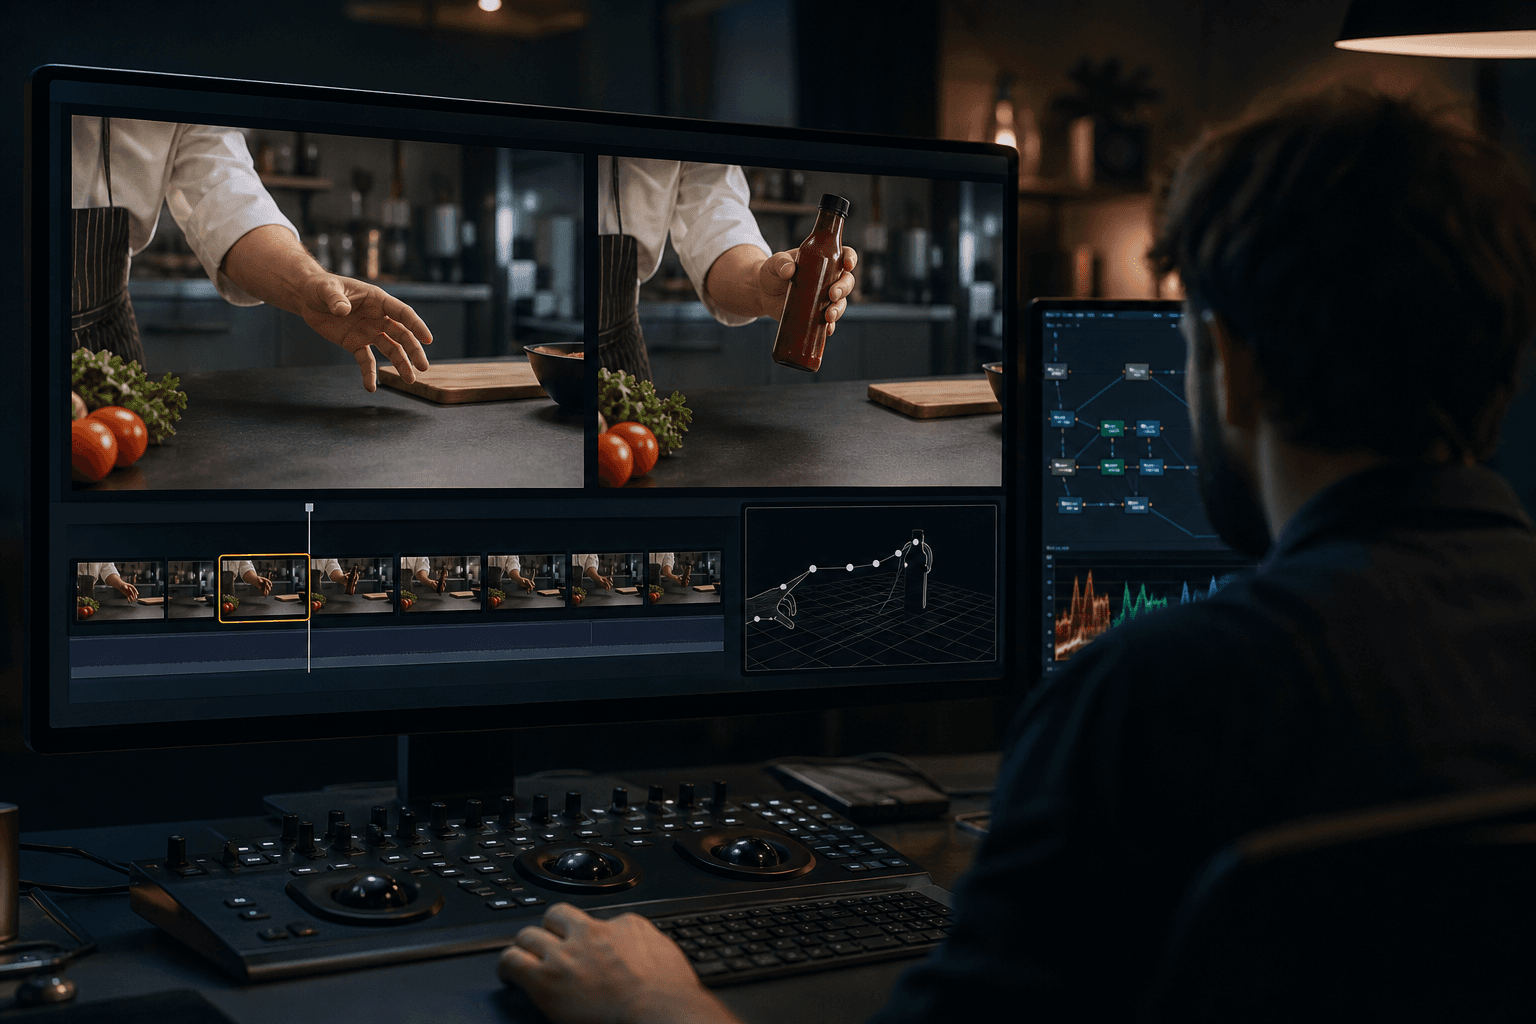
動画に後から加えた物体が、持ち上げられるなど元映像の動作と噛み合うよう編集するAI「ALIVE」が登場した。撮り直しに頼ってきた広告・研修動画の制作工程を変える可能性がある。
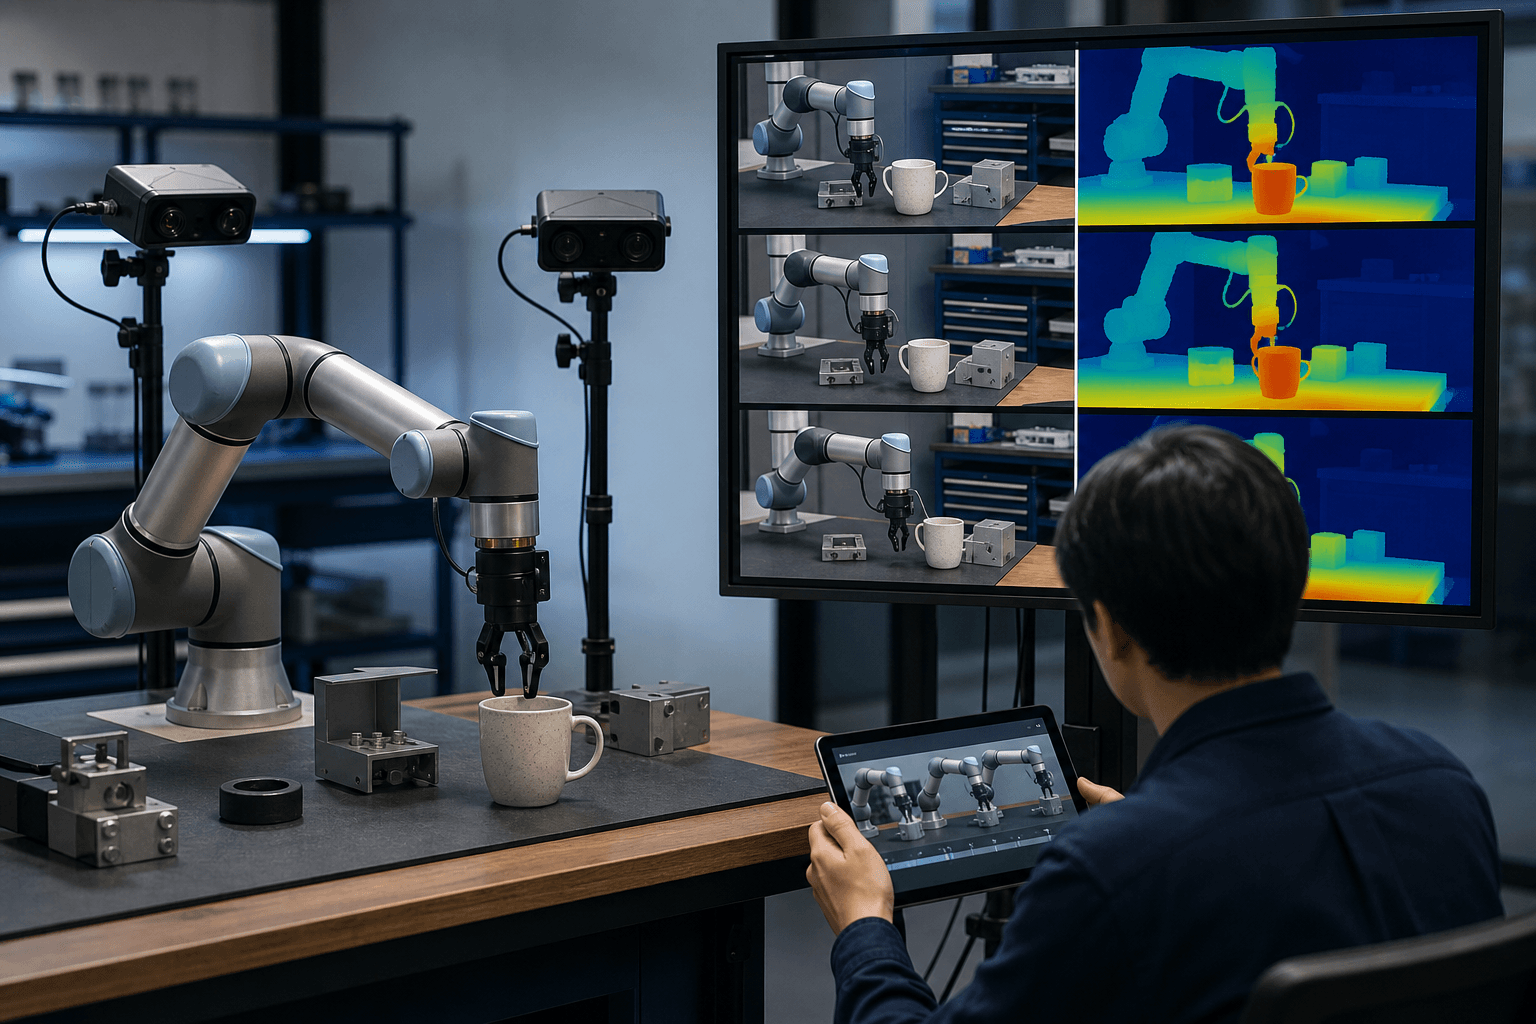
ロボット操作の予測映像に奥行き情報を加えた世界モデル「DepthWorld」が発表された。奥行きの学習が映像予測自体も改善し、実機を使わない動作評価の信頼性を高める可能性がある。
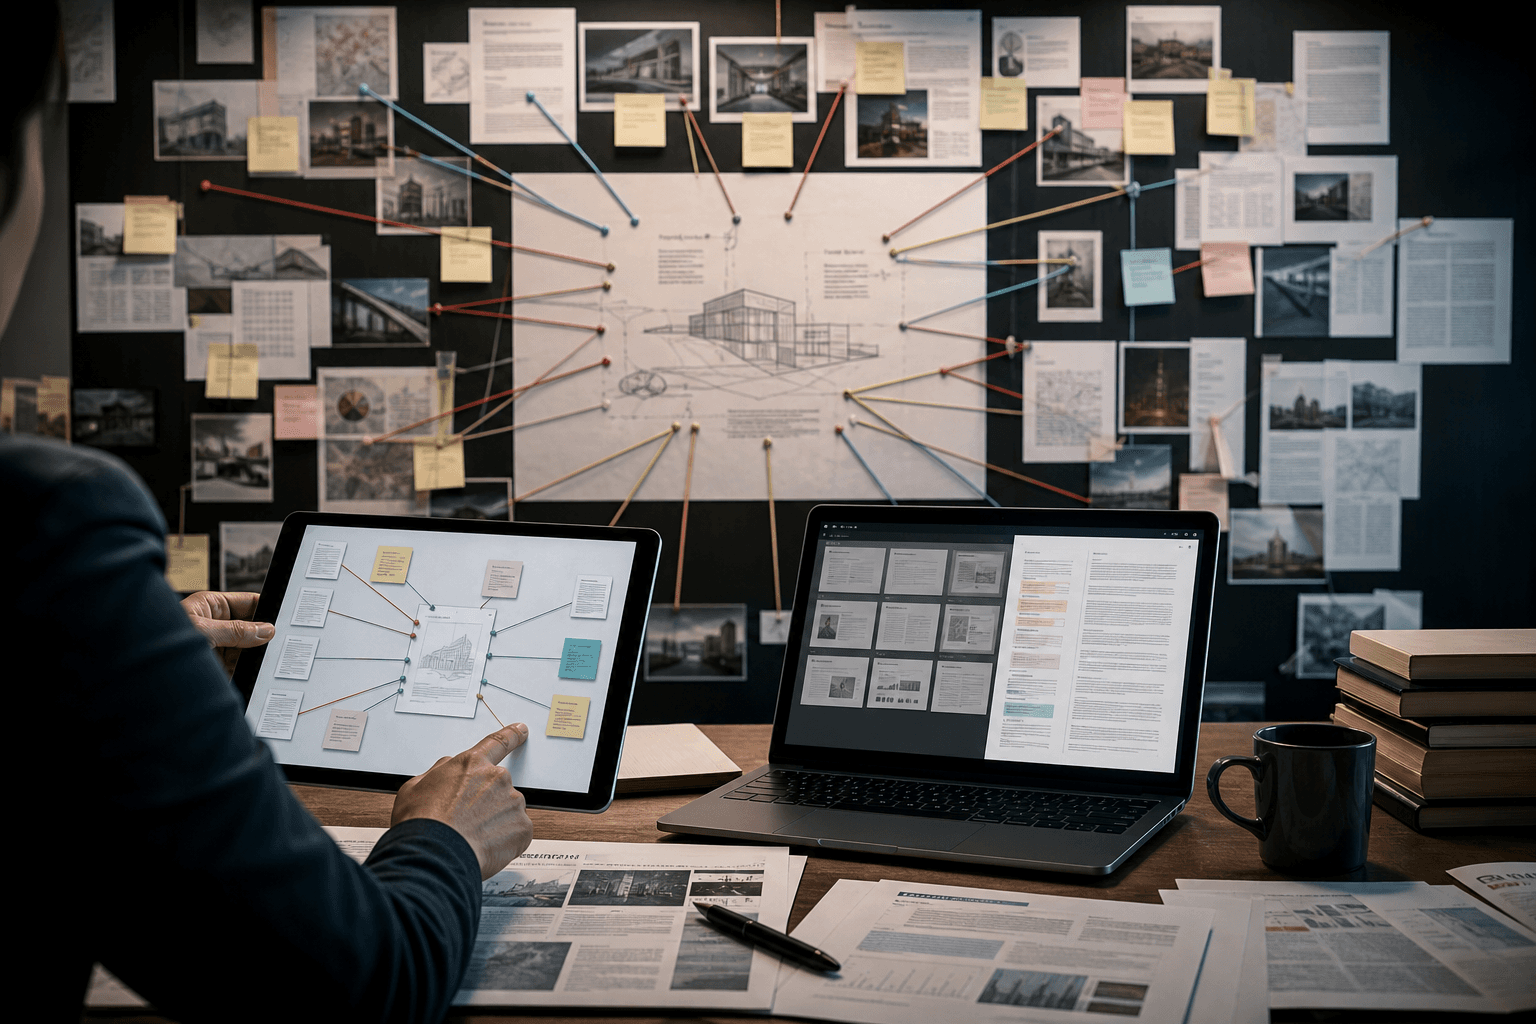
複数の先行論文を統合して新しい研究アイデアを出すLLMの訓練法「IdeaAnchor」が登場した。各論文の役割と合成基準を設計図として学習に使う。R&Dや企画の起案業務を変え得る手法である。
4D-HOFは、基盤モデルの粗い推定を生成モデルで補正し、手と物体の相互作用を単一パスで復元する。物理制約も組み込み、個別最適化を不要にする点が注目される。
コンフォーマル予測の「予測集合の縮み幅」が、情報理論上の情報量として理論的に裏付けられた。特徴量選定やデータ投資の判断基準を、保証付きで見直す契機となる。
米国の研究チームが、フローポリシーを高速に強化学習するQF3を開発した。人型ロボットの歩行を白紙から学習し実機へ直接移植でき、学習時間は従来手法の約10分の1になった。
米国などの研究チームが、1枚の画像から未撮影の裏側まで含む3Dシーンを屋内外とも生成する手法を発表した。現場写真を3D資産へ変える初期コストを下げ、建設や不動産、小売の業務を変える可能性がある。
動画生成AIの物理的な正しさを、光学や流体など40課題で定量測定するベンチマークが提案された。最高モデルでも100点中57.76点にとどまり、実務利用前の検証の必要性が浮かんだ。