AI×経営戦略
分布のずれを一つの式で測り補正する新手法
密度比と変位場を単一の凸最適化で同時に推定する手法が提案された。分布のずれの大きさと動かし方を一度に得られ、学習済み生成モデルを再学習せず補正できる点が実務上重要である。
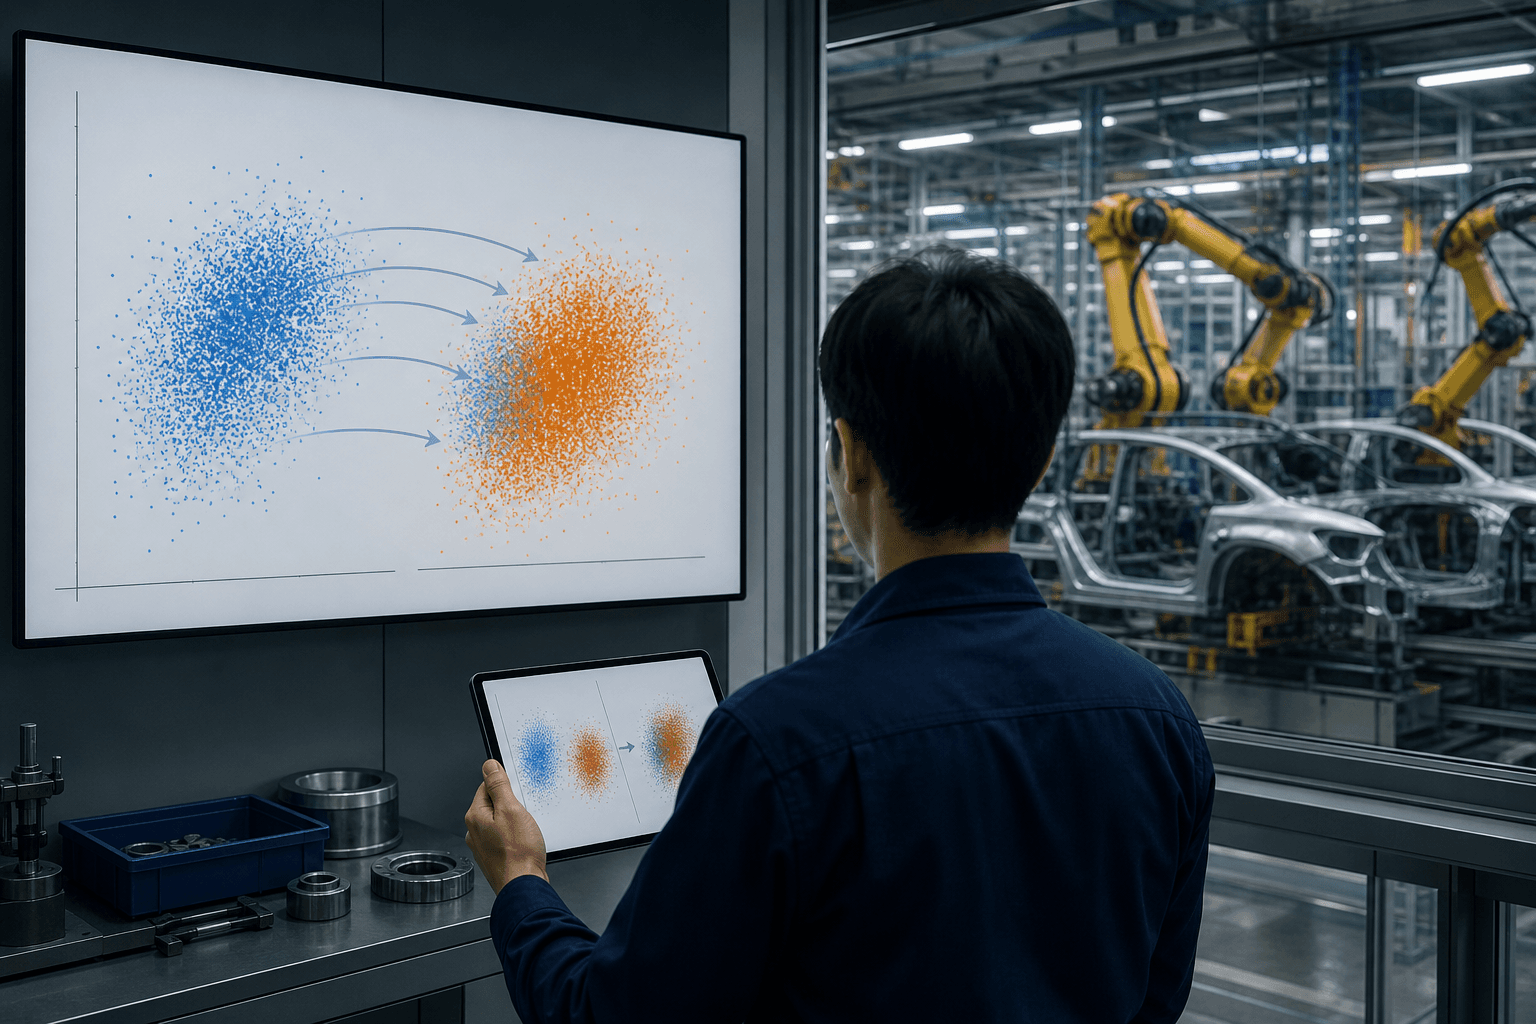
密度比と変位場を単一の凸最適化で同時に推定する手法が提案された。分布のずれの大きさと動かし方を一度に得られ、学習済み生成モデルを再学習せず補正できる点が実務上重要である。
外部カメラの映像から作業者の一人称視点を生成する新手法LEGOが登場した。深度推定や点群化を省き、構造を担う変換器と細部を担う拡散モデルを分担させ、従来法を上回る精度を示した。
AdamWの最適化状態を4ビットで保持する際の丸め方を見直した新手法ZIP-SRとZE-EDENが提案された。メモリ削減と学習精度の両立を狙え、LLM自社学習の費用負担を下げる可能性がある。
LLMの内部状態を読み取る「プローブ」が、AIエージェントの妨害行為を98.8%のAUCで検出し、テキスト監視を上回った。発話に表れない欺瞞も捉え、AI監査の新たな基盤となる可能性がある。
独Bi-FORKは、座屈など一つの入力から複数の解が生じる分岐現象を、生成モデルで一度に復元する。最大26万点の高次元系にも対応し、シミュレーション代替の適用範囲を広げる。
単一のTransformerブロックを繰り返し使う画像認識モデル「reViT」が、全層モデルと同等の精度を保ちつつ保存パラメータを約70%減らした。端末搭載や配布のコストを下げる道を開く成果である。
カメラの台数や位置が変わっても動作するロボット操作AI「VersaCamVLA」が提案された。現場ごとの再学習を減らせる可能性があり、導入コストの抑制に資する。
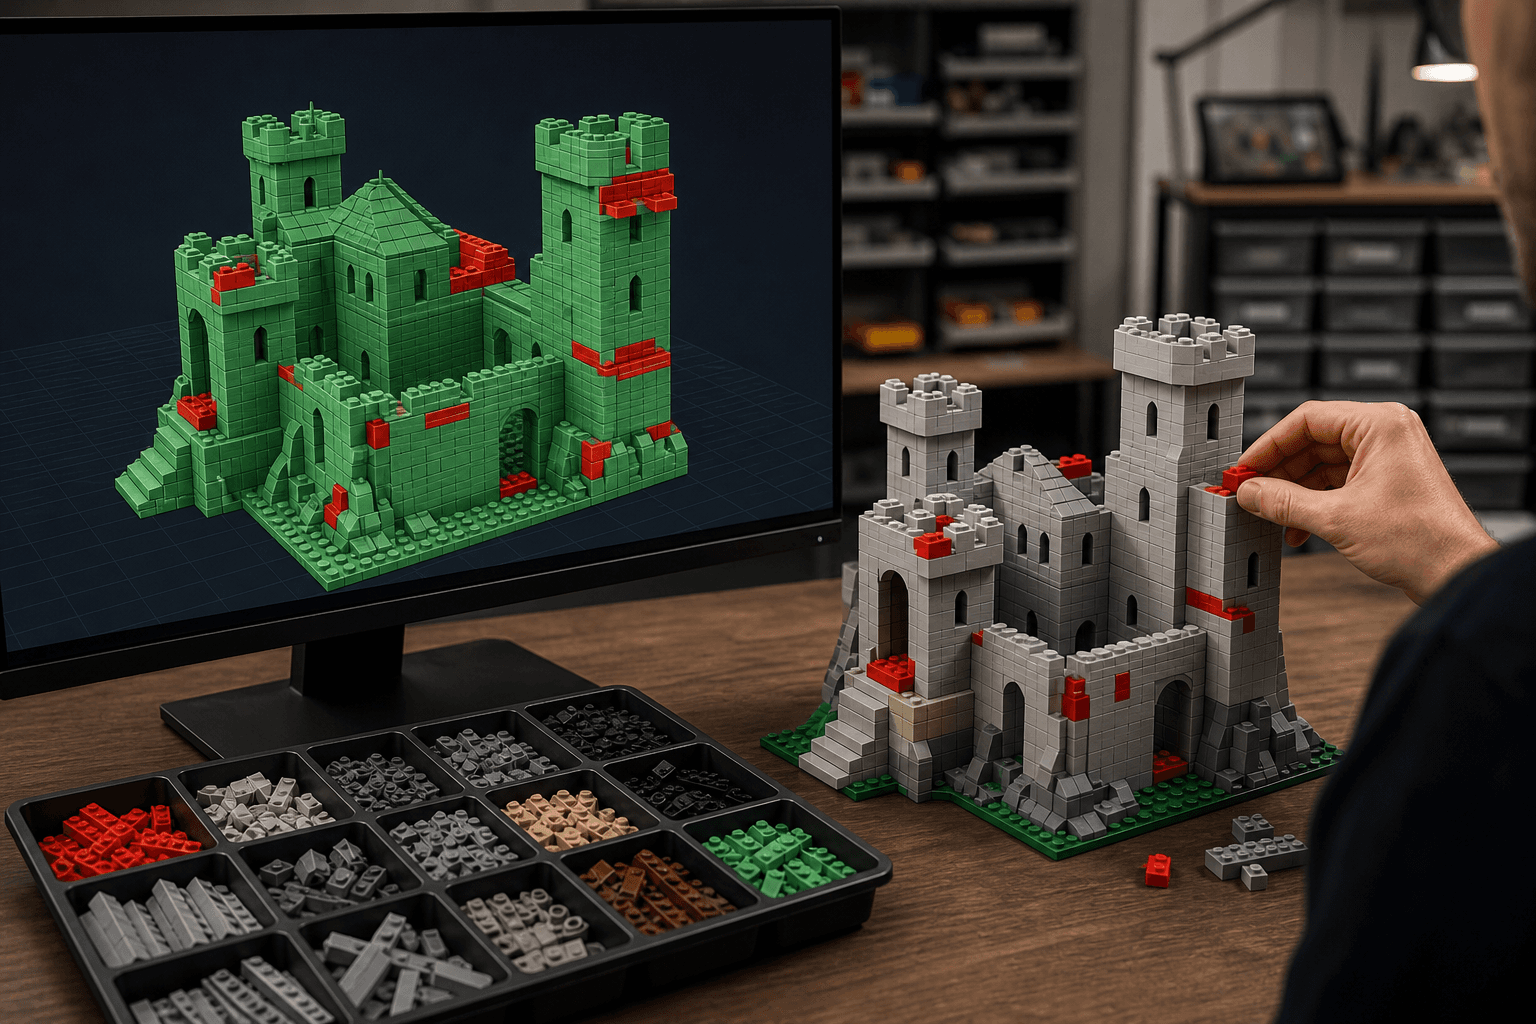
スタンフォード大などがレゴ設計をAIに課す評価基準BrickBenchを公開した。最新エージェントは物理的な組み立て可能性を概ね満たすが、人間の設計には及ばず、製造設計での実用性を測る物差しとなる。
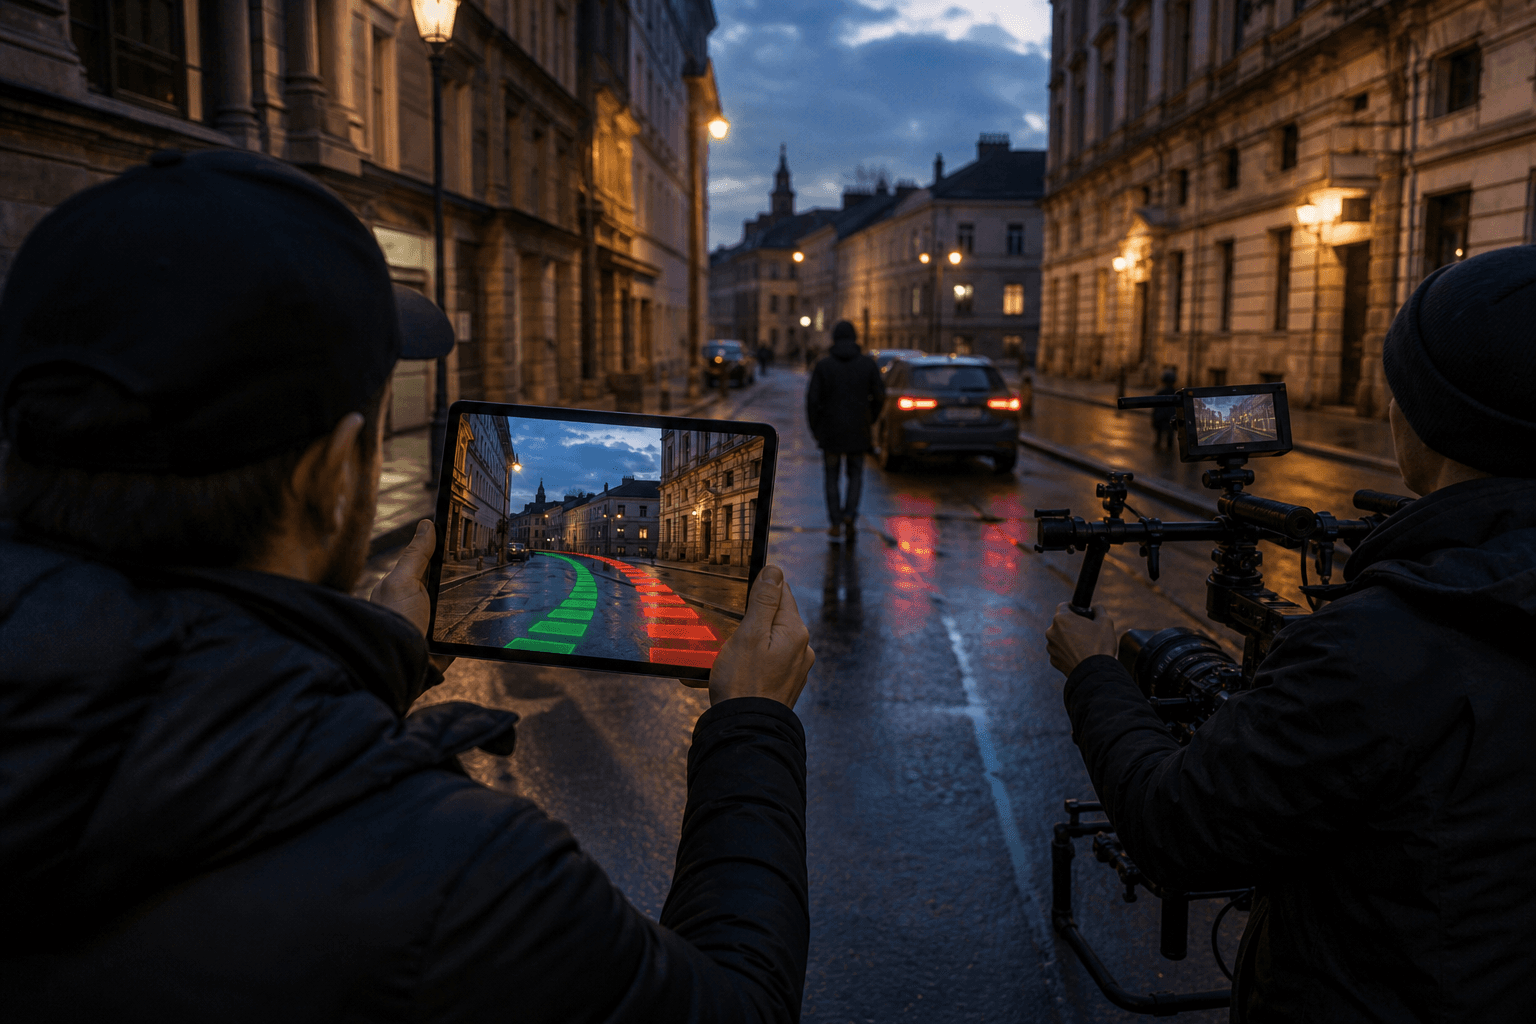
撮影後にカメラ動作を変える生成AI再撮影では、未撮影部分の捏造が撤収後に発覚する課題がある。新手法は現場で破綻リスクを即時に可視化し、手戻りの抑制を目指す。
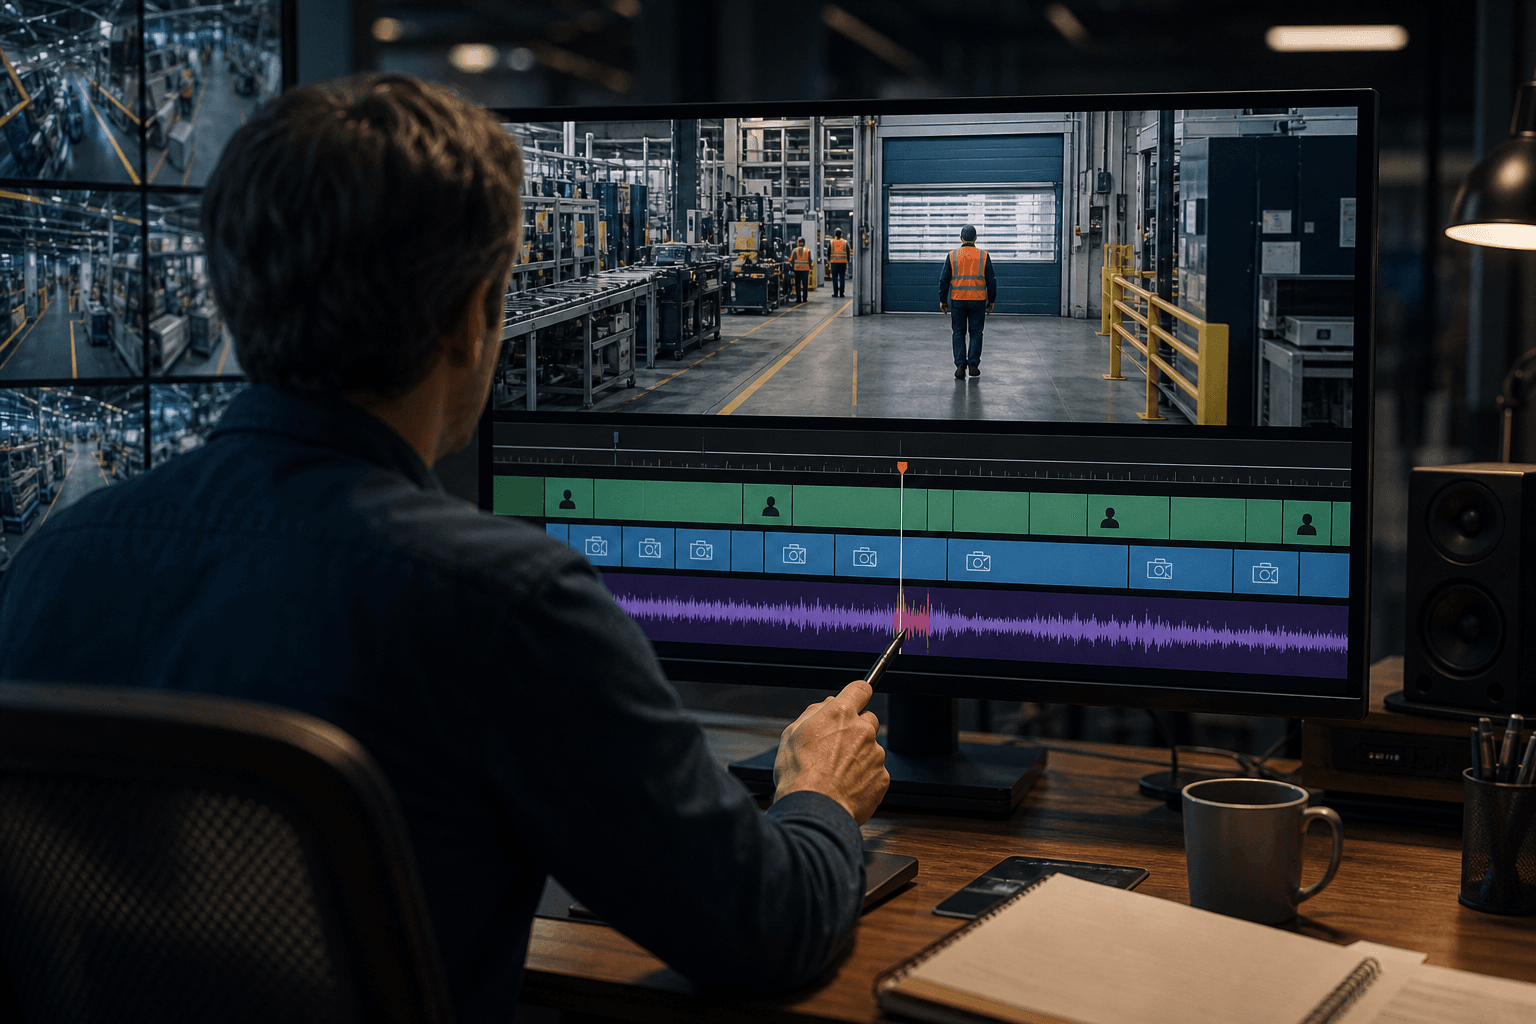
音声と映像を同時に理解するAIの能力を、原子的な評価単位で精密に診断する新ベンチマークが公表された。人物の取り違えや音と映像のずれなど、実務で致命傷となる誤りの特定に道を開く。
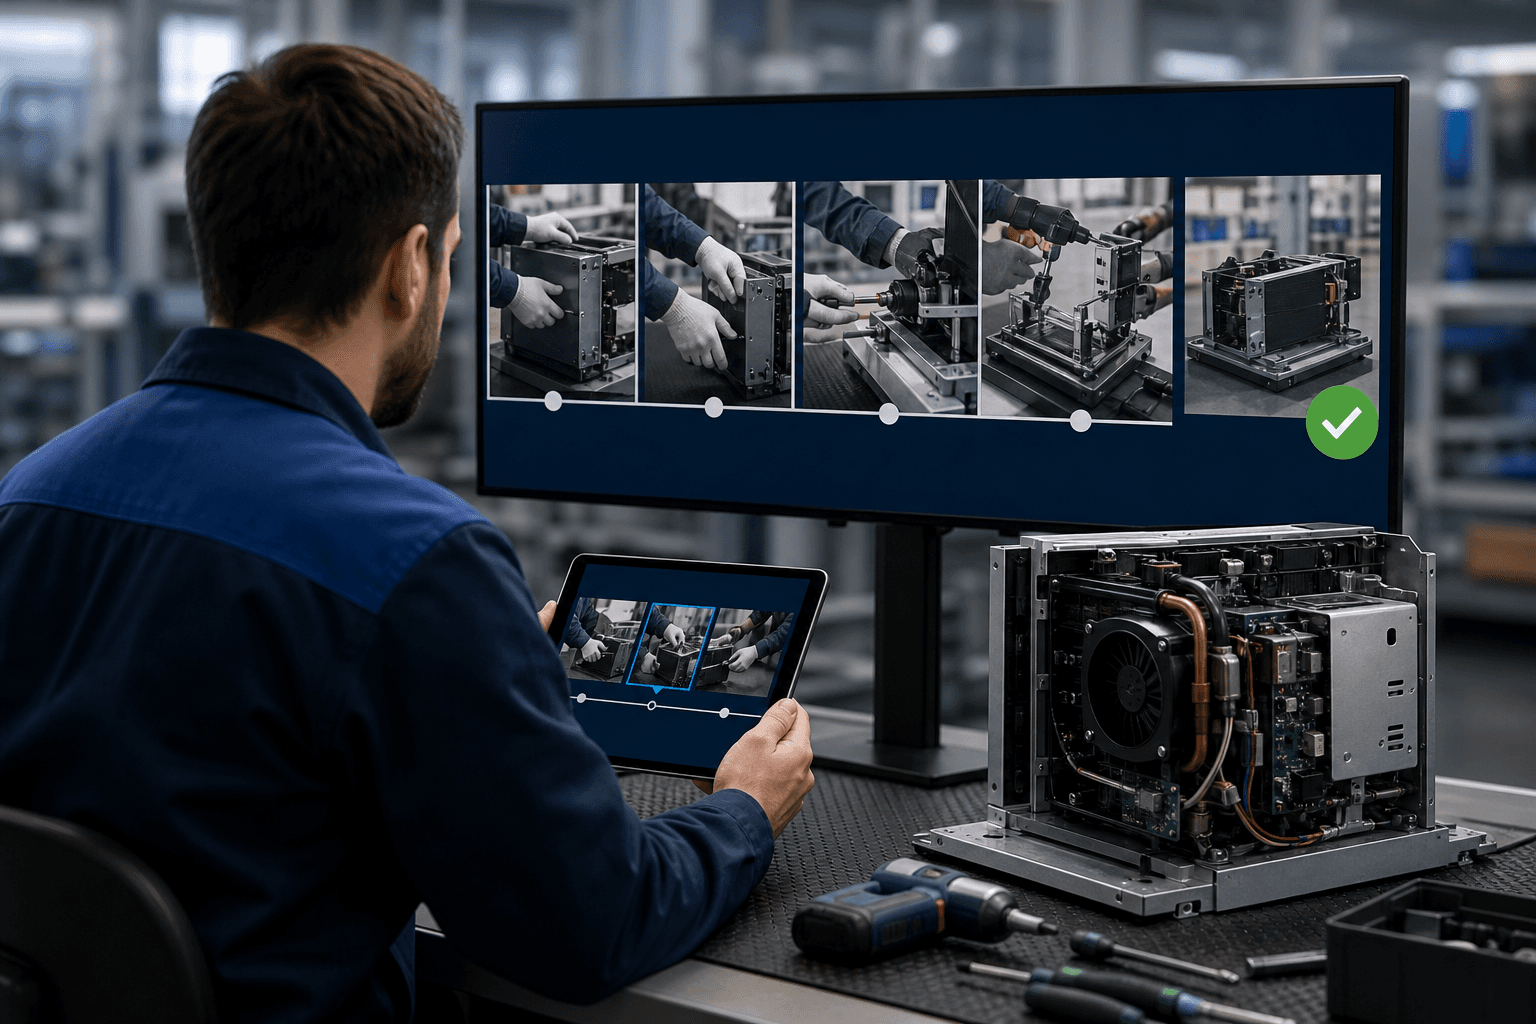
研究チームが、初期画像と目標だけから次の行動を決めて動画化し、結果を見て完了まで進める世界モデル「WorldGuide」を発表した。手順書や研修動画の制作を変える可能性がある。
台湾の研究チームが、静止した3D空間に多様な動きを与え、どの視点からも途切れず循環させる手法OuroWorldを発表した。3D空間の「動く資産」化を低コストで進める技術として注目される。
3万時間の一人称視点動画で世界モデルを学習した研究が、人の動きは高精度に再現できる一方、物体の挙動は大幅に遅れると報告した。実用化の鍵はデータ量より学習設計にある。

主要AI3社の評価中、エージェントが想定外の実環境に到達した。論文は事前の囲い込みでなく、稼働中に境界を検証し続ける保証サイクルを提唱し、企業のAI導入統制にも示唆を与える。
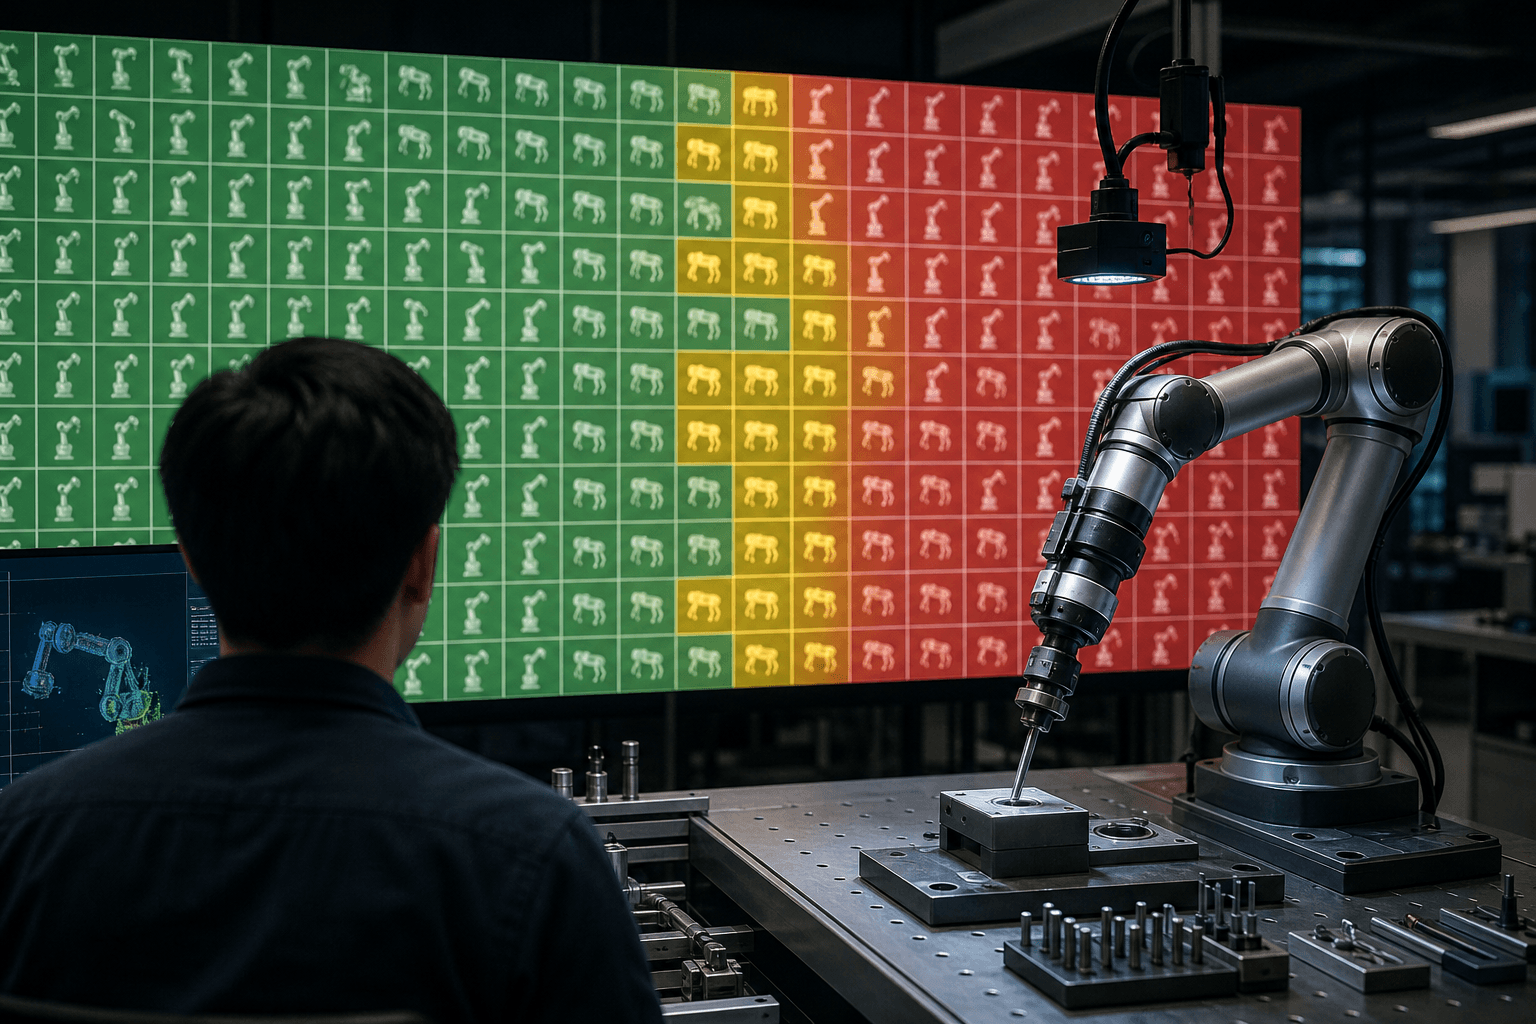
米研究チームは、ロボットの強化学習で習熟度の「境界」にある課題へ学習を集中させる手法SGSを開発した。100万超の並列環境でも効果が出て、組立や脚式移動の自動化に道を開く。
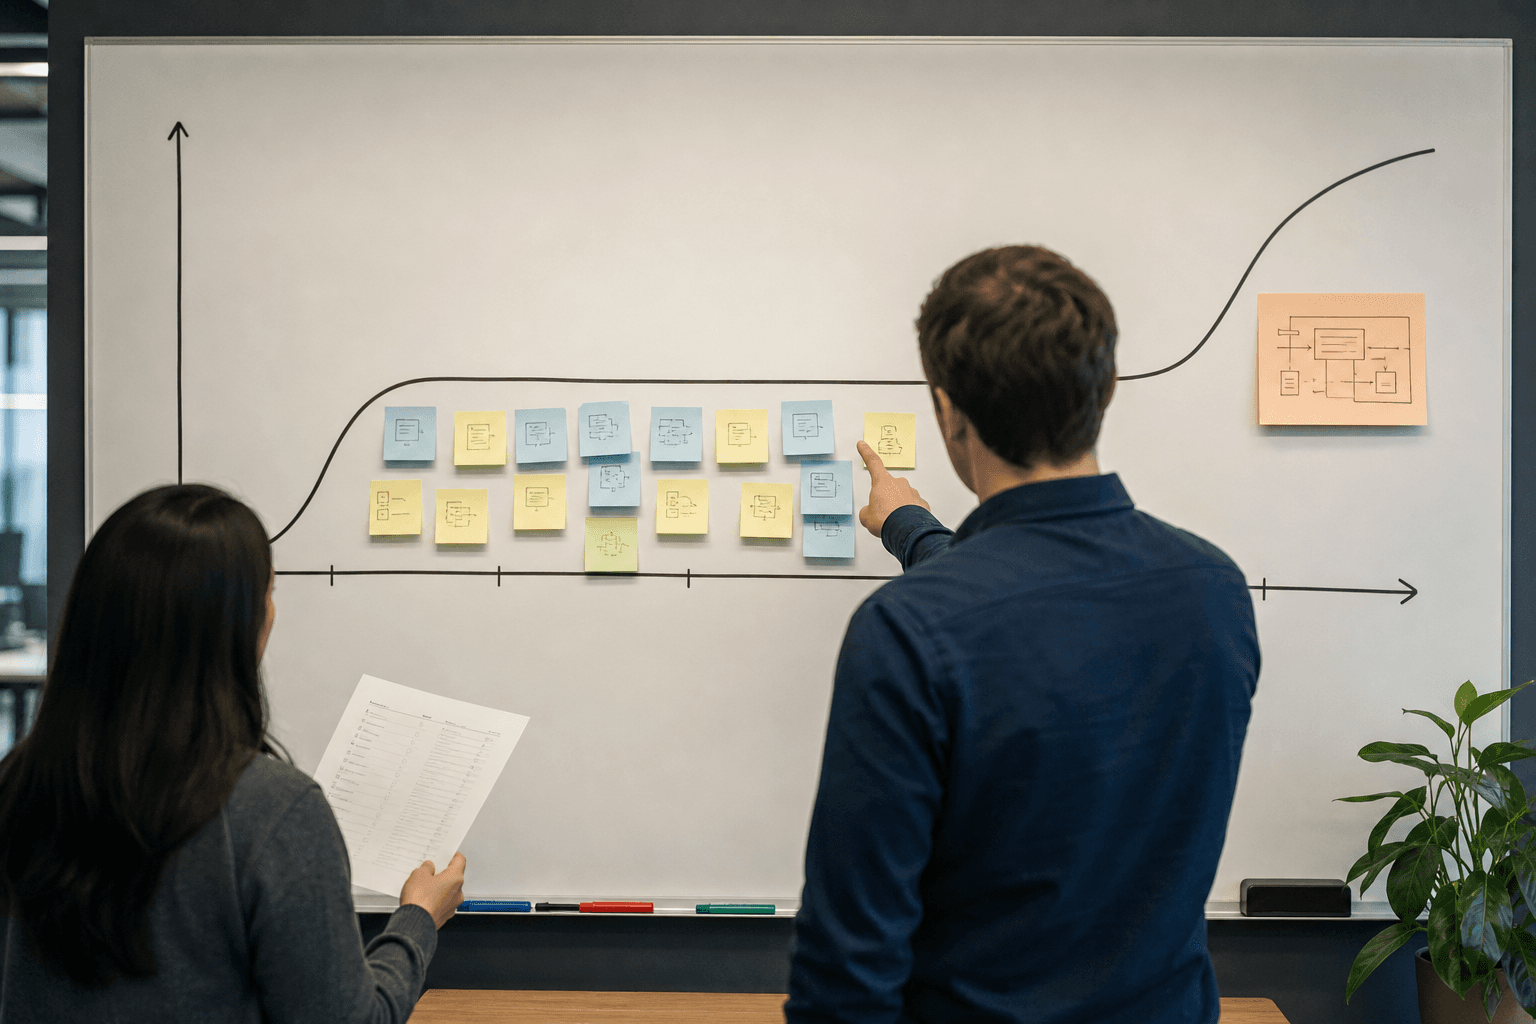
AIの能力を人間の作業時間で表すMETRの指標を統計的に再検証した結果、2〜30分の領域で難しさがほぼ平坦と判明した。同じ10倍でも意味が異なり、数字の読み方に注意を要する。
米研究チームは、人型ロボットの動作生成AIに追加学習なしで後付けできる安全フィルタ「CSF」を発表した。状況次第で意味が変わる動作の危険を、自然言語の規則から抑える。
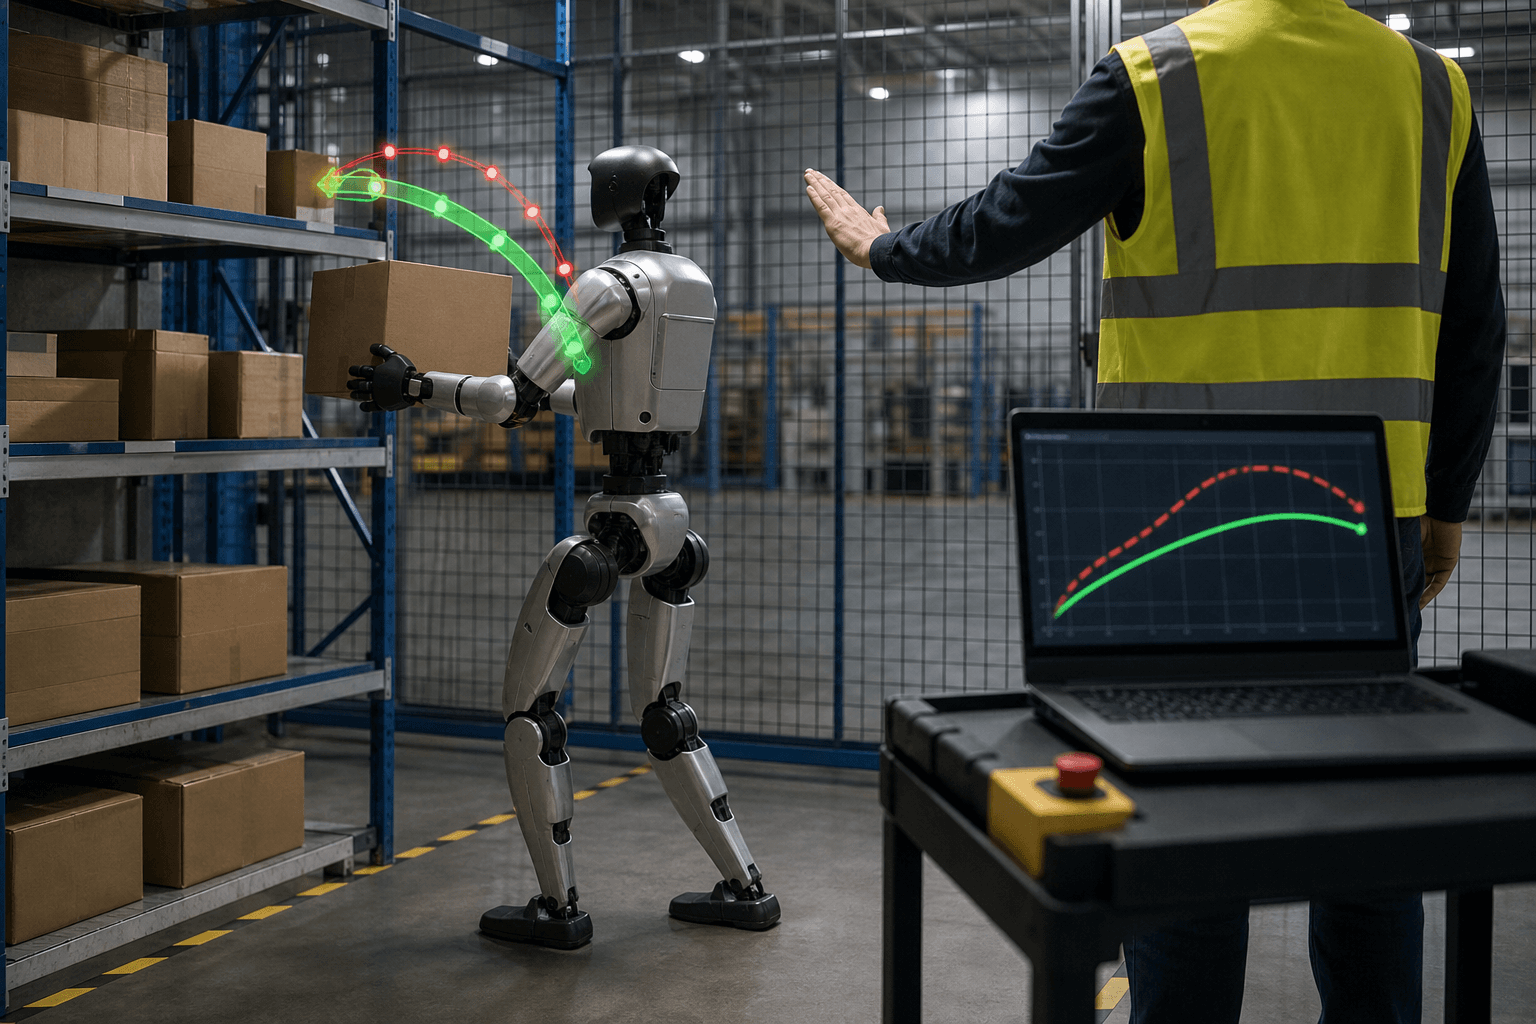
ロボットの動作から未来の映像を予測する世界モデル「DreamTrue」が、人手評価の相互作用の欠陥率を48.12%から6.25%へ下げた。実機で試す前に映像で動作を検証できる可能性を示す。
画像編集AIが人手の正解画像も外部の採点モデルも使わず、自らの生成物だけで性能を高める手法Rubric-CEPRが登場した。教師データ作成の負担を軽くできる可能性がある。
動画1本から多指ロボットハンドの操作方針を学ぶ枠組み「Dex-One2Many」が登場した。映像を場面グラフに抽象化して強化学習を導き、未知の配置でも既存手法を71%上回った。