AI×経営戦略
ループ型LLM、固定点活用で推論を軽量化
ループ型言語モデルで状態が固定点に近づく性質を利用し、学習・復号・RLを効率化する手法が提案された。KVキャッシュを3分の1にしても精度を保ち、運用コスト低減に道を開く。
ループ型言語モデルで状態が固定点に近づく性質を利用し、学習・復号・RLを効率化する手法が提案された。KVキャッシュを3分の1にしても精度を保ち、運用コスト低減に道を開く。
拡散モデルによる条件付き生成で、逐次モンテカルロ法を途中時点から開始する手法が提案された。同数の粒子で精度が約2倍に高まり、稀な事象の再現では桁違いの改善も確認された。
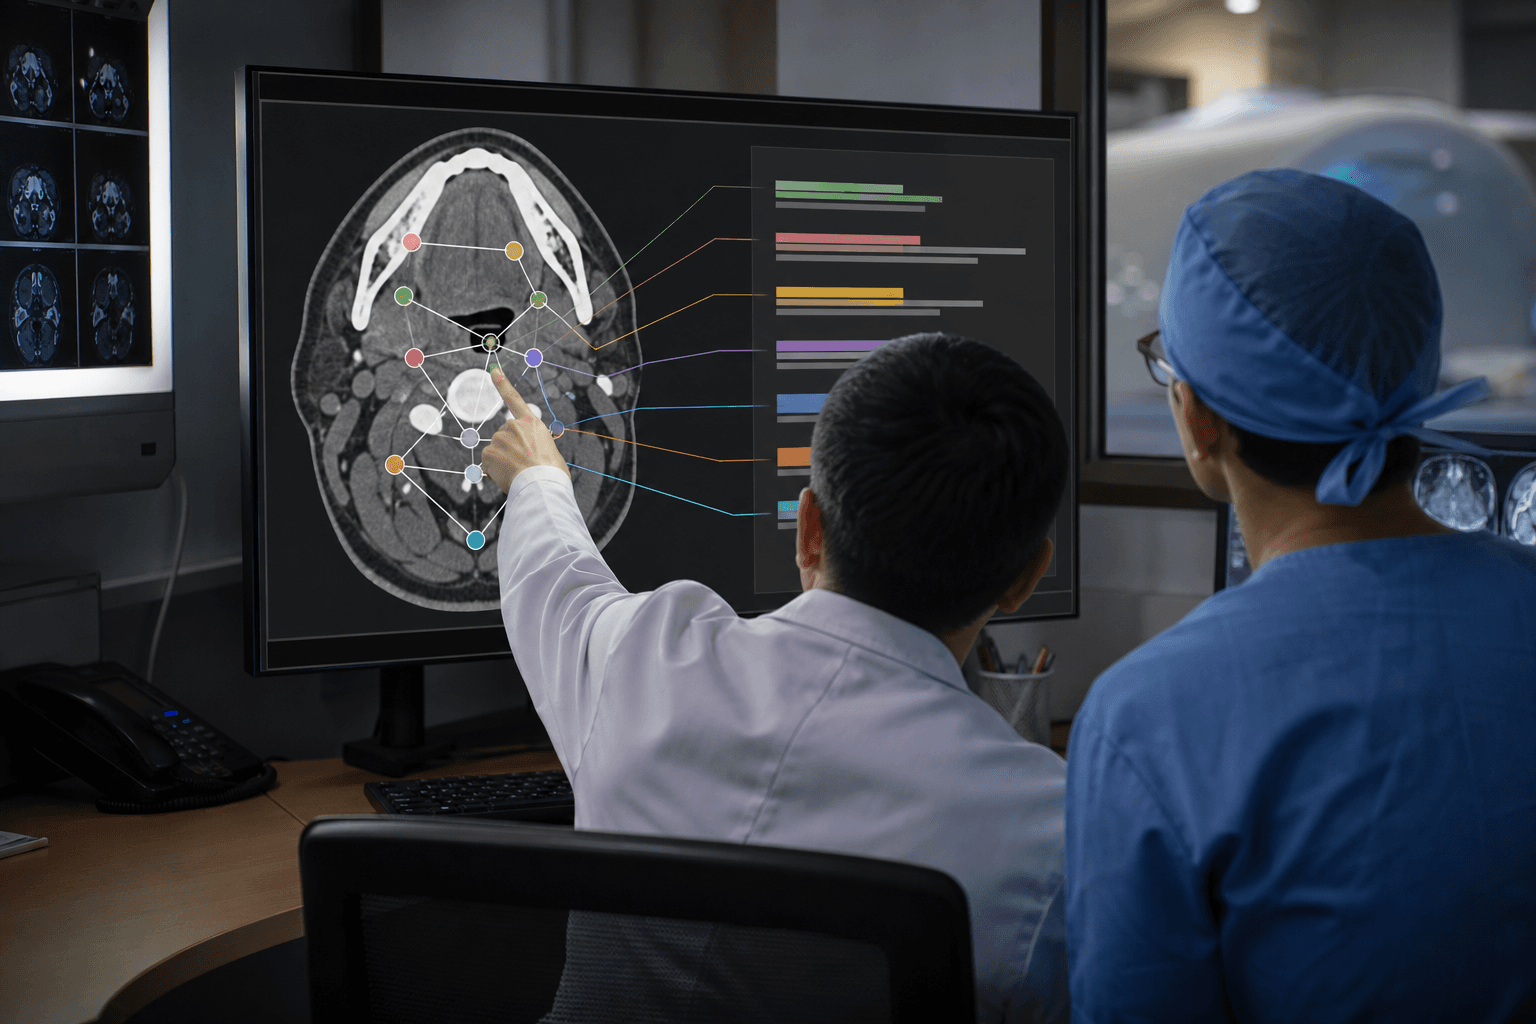
CT画像と読影レポートを臓器単位のグラフで結び付け、喉頭咽頭がんのT分類を予測する枠組みが提案された。腫瘍の手作業での切り出しを要さず、生検に頼る診断の補完を狙う。
LLMが動かすロボットが、手本動画を階層に整理して必要な場面だけ参照する手法が登場した。1本の動画で追加学習なしに成功率を高め、現場導入の負担を下げる点で注目される。
画像生成AIの内部状態に自然言語で質問し、生成途中の絵の中身を読み取る手法が提案された。内部情報を品質改善にも使えると示した点で、制作現場の品質管理に影響しうる。
画像AIが背景など見かけの手がかりに頼る度合いを幾何学的に監視し、抑える手法BiasFlowが登場した。凍結した基盤部分に偏ったデータで新たな出力層を学習させても、最悪グループ精度が40.7%から64.1%に改善した。
動画生成AIが物理法則や単純な規則を破る問題に対し、高ノイズ段階で順次生成し低ノイズ段階で一括精緻化するS2PDが提案された。生成映像の信頼性向上に道を開く手法である。
人の動作データを人型ロボットの実行可能な動作へ変換し、成功した変種だけを再学習に回す枠組み「InterMimicGen」が提案された。少量の実演から作業の網羅範囲を広げる道筋を示す。
基盤モデルの応答冒頭に特定の語を固定するだけで、強化学習済みモデルに迫る数学・コード性能が得られると判明した。再学習なしで性能を引き出す手法として、AI運用コストの見直しにつながる。
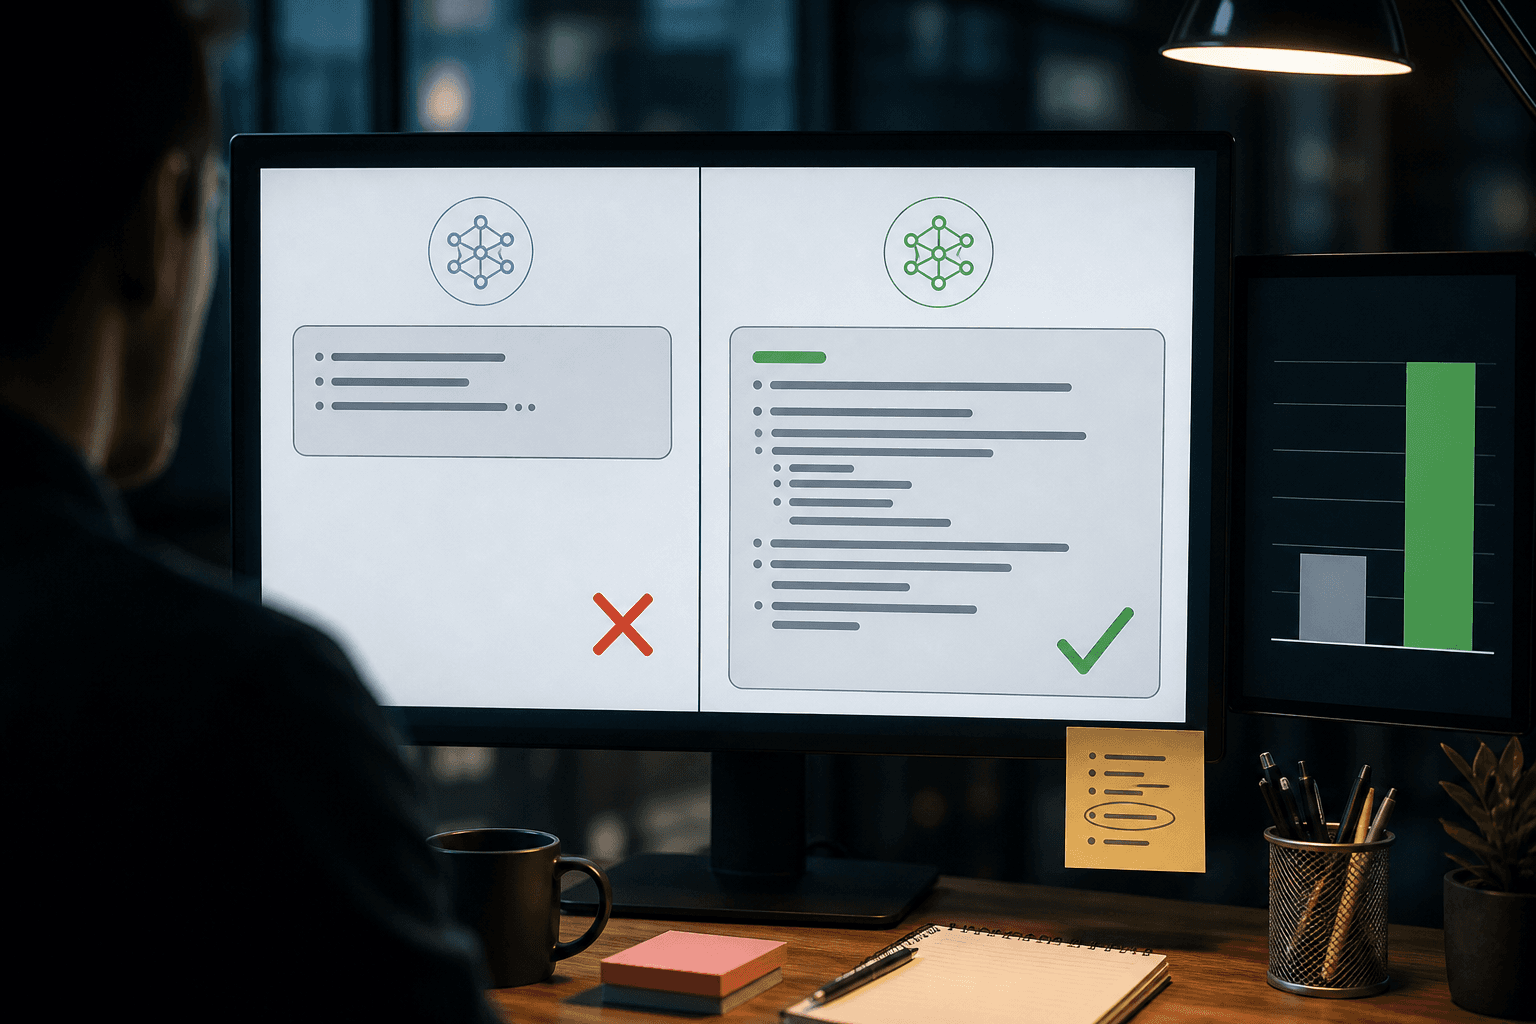
台湾の研究チームが、フローチャート画像を任意の縦横比へ接続を壊さず再配置し、編集可能な形式で出力するAIパイプラインを発表した。資料作成の転用工数を減らす技術として注目される。
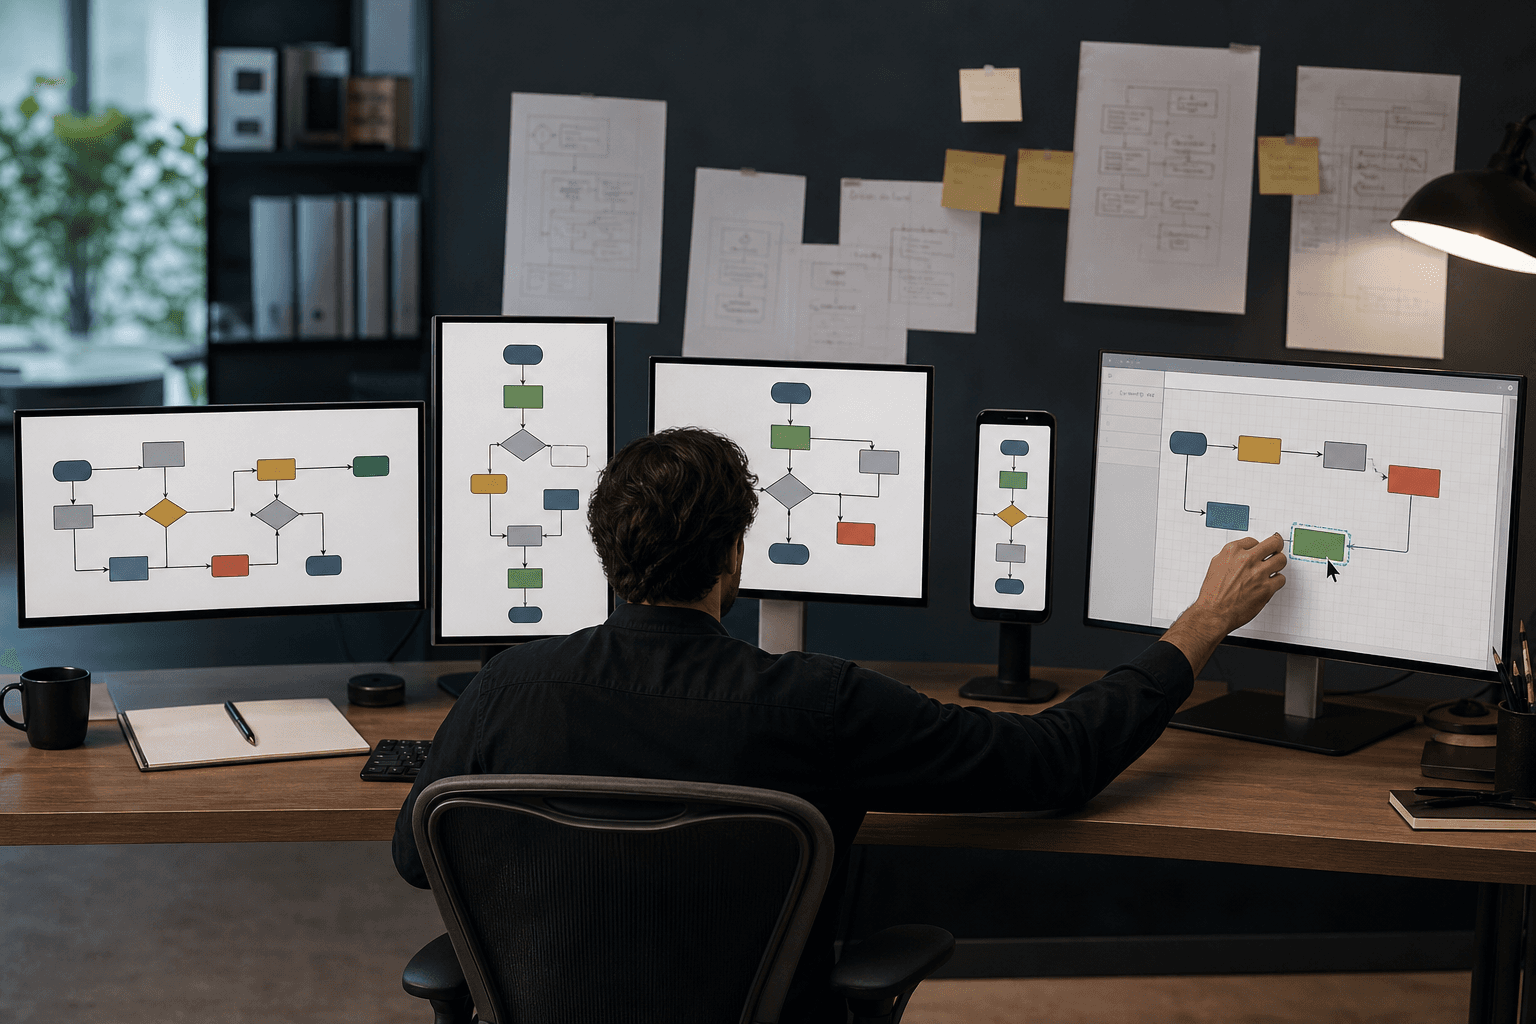
研究チームが、40億パラメータで一般的なグランドマスター級に指し、手と計画を自然言語で説明するチェスLM「Queen」を発表した。専門エンジンと言語モデルを融合する手法で、業務AIの説明可能性向上に道を開く。
DINOv2の内部トークンを分析した研究で、レジスタ由来の特徴を壊すと表現が48.17%変化し、外れ値由来では0.31%にとどまった。画像AIの解釈性と軽量化に資する知見である。
大規模言語モデルの追加学習用データを選ぶ際、出力層の勾配だけで全勾配に近い性能を保てることが判明した。特徴抽出の演算量はSFTで9.7分の1に減り、AI開発費の抑制に直結し得る。
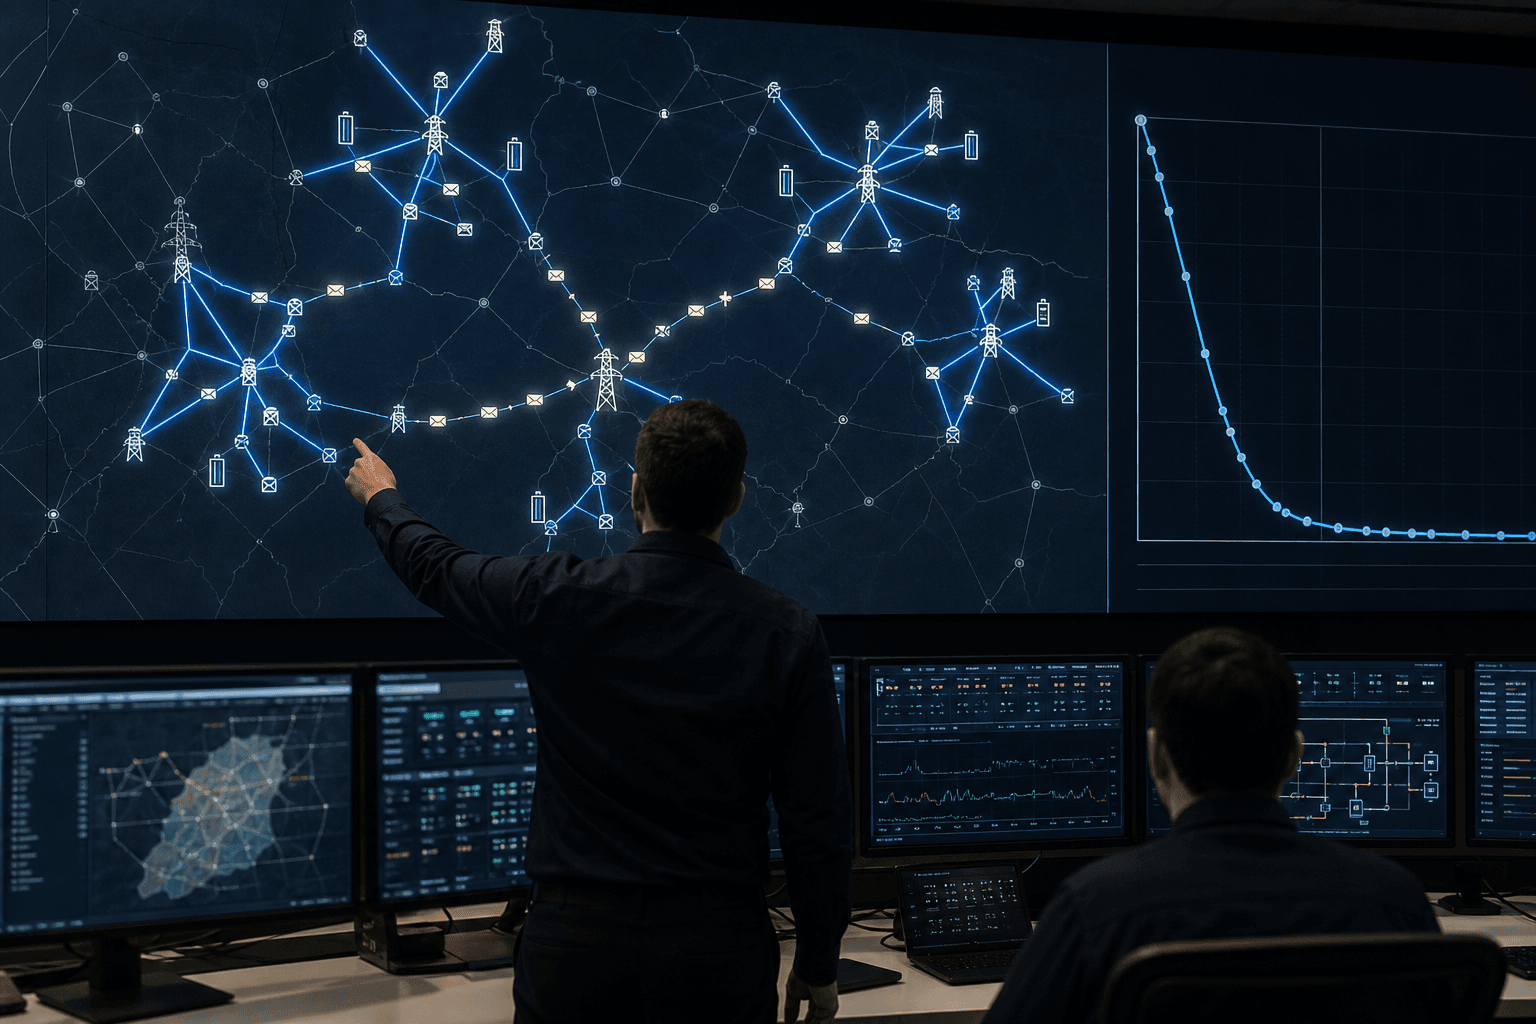
中央サーバーなしで各拠点が協調し最適解を求める分散最適化で、通信網の構造から計算の分担まで一体設計する新手法GATEが提案された。線形収束も理論的に保証され、設計指針となる。
米研究チームは人間の視覚に倣い、単一のステレオカメラの視線を能動制御して両手作業を行うロボット手法を発表した。手首カメラを省きつつ成功率を維持し、ロボットの低コスト化に道を開く。
RNADynBenchとRNADynNetが公開された。2585本の全原子MD軌道を整備し、軌道生成と動態理解を単一モデルで扱う。RNA創薬の探索工程を効率化する基盤として注目される。
環境変化に適応する世界モデルでは、古い知識の破棄は欠陥ではなく必須動作だとする論文が公表された。物理法則など不変知識と更新すべき事実を分けて評価する枠組みを示し、AIの品質保証の見直しを迫る。
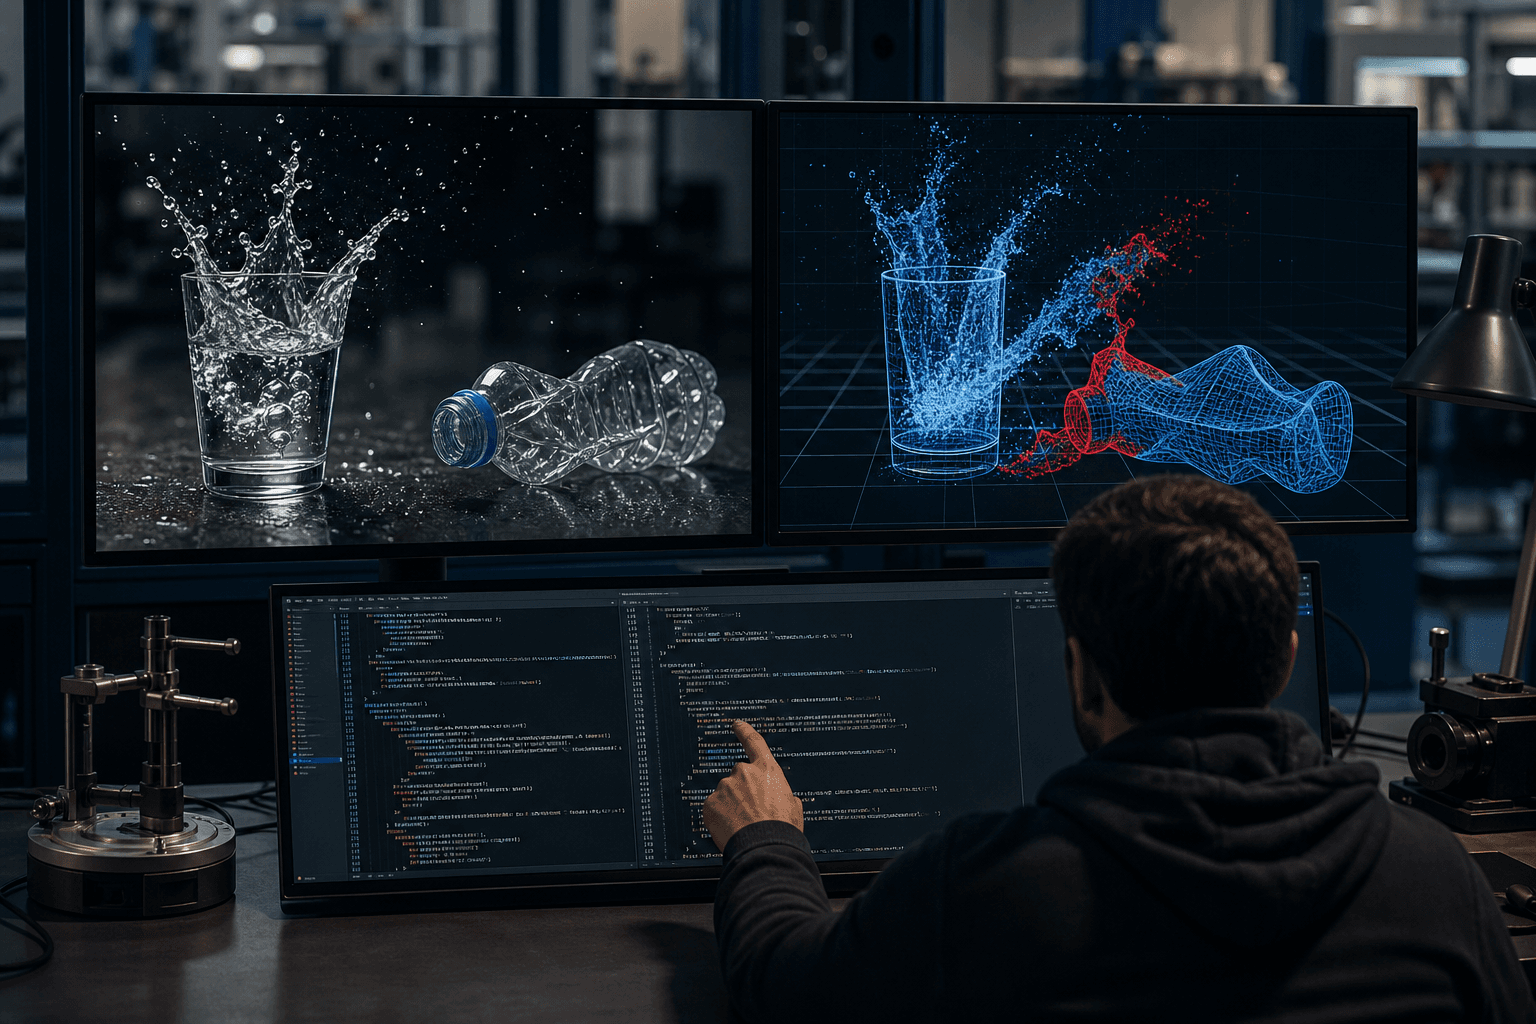
動画から物理現象を再現するグラフィックスコードをAIに書かせる新指標「4DCodeBench」が公表された。静的再現に強い先端モデルも、変形や流体の動的再現は不安定と判明した。
研究チームが単眼動画から全画素の回転と並進を世界座標系で直接推定するAIモデル「MoSE3」を発表した。点追跡では得られなかった部位の回転や剛体のまとまりを捉え、ロボットや映像制作への応用が見込まれる。
新規視点合成を用いた自己教師あり手法SNAPが、デコーダーの表現力を抑える設計で幾何学的特徴を獲得した。少ない計算資源で教師あり手法に迫り、ロボットや測位分野の導入コストを下げる可能性がある。