Tetris3D、物体が噛み合う3D空間を1枚の写真から生成
韓国の研究チームが、1枚の画像から周囲の物体との位置関係を踏まえて3D空間を再構築するTetris3Dを発表した。物理的に破綻しない配置を自動で得られ、設計や小売の現場での活用が見込まれる。
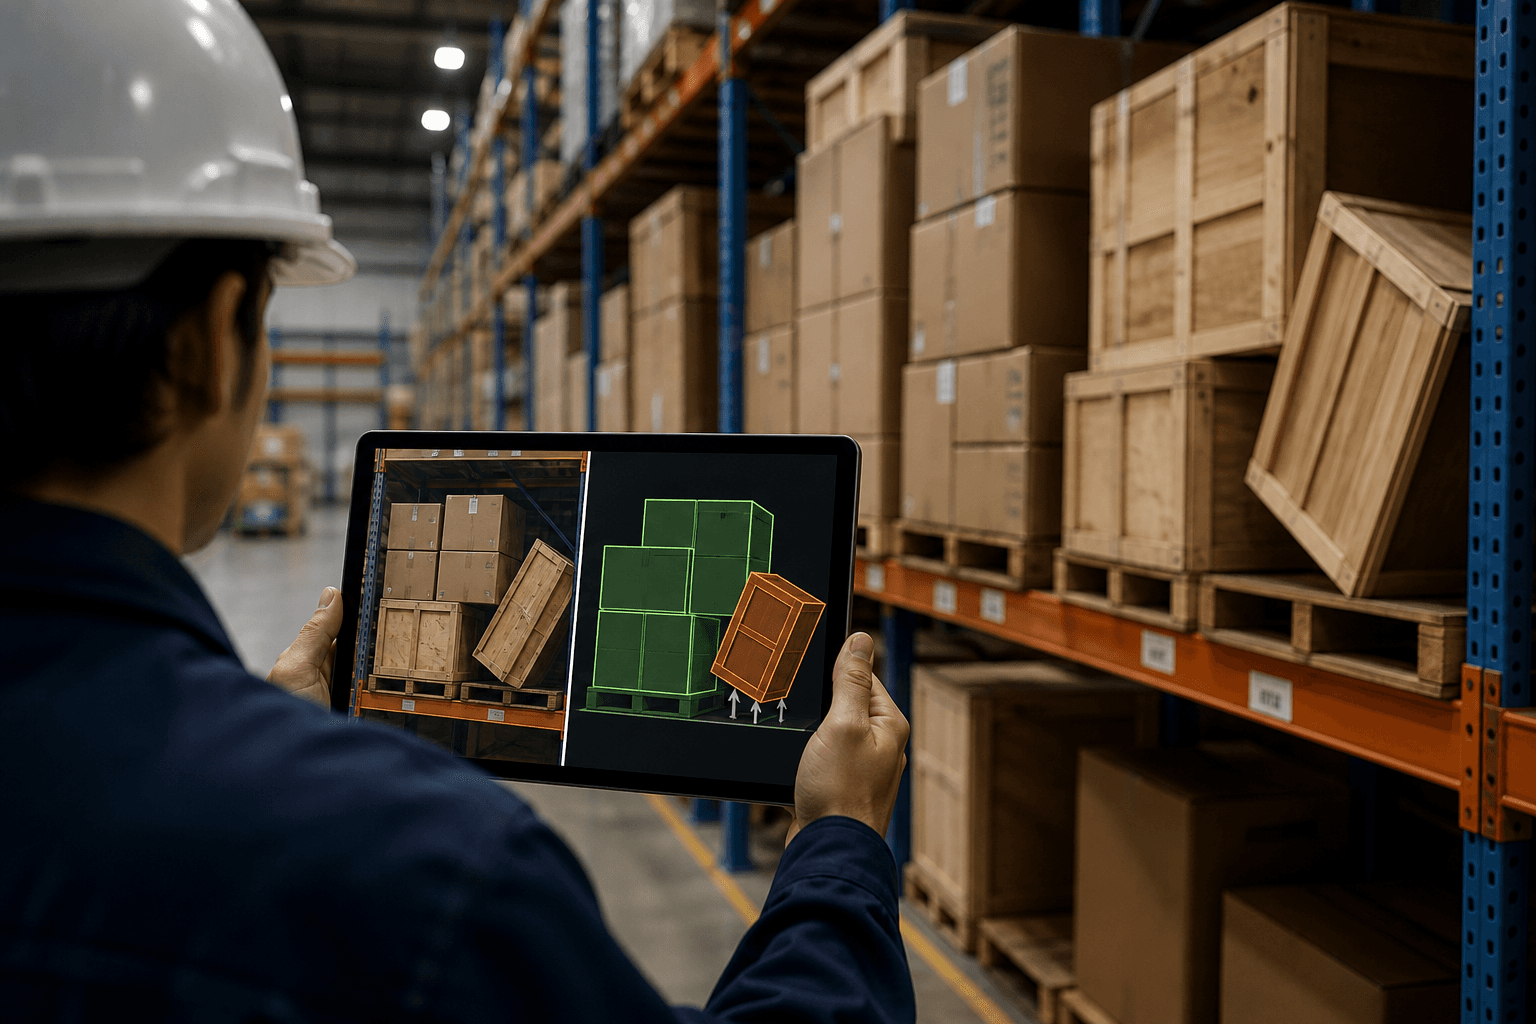
研究の概要
Tetris3Dは、1枚の画像から室内などの3Dシーンを再構築する生成フレームワークである。従来手法は、シーン内の物体を一つずつ独立に生成するか、物体同士を暗黙的に結びつけるにとどまっていた。そのため、隣り合って接触したり支え合ったりする物体の間で、細かな空間的整合性が保たれにくいという課題があった。
研究チームは、各物体を生成する際に、周囲の物体の形状と物理的な関係を明示的な条件として与える方式を採用した。これにより、物体の形と姿勢が、シーンの中で幾何学的にも物理的にも無理のないものに誘導される。あわせて、物理シミュレーションに基づくComObというデータセットも構築した。120万シーンから成り、多様なカテゴリーの物体が物理的に相互作用する様子を収め、物体ごとのメッシュ(3D形状データ)と、物体の組ごとの物理的関係の注釈を備えている。
合成シーンと実世界シーンの双方での実験では、接触部分が他の物体に隠れて見えない場合でも、整合した形状と姿勢を復元できたと報告されている。生成品質と物理的な安定性の両面で、最先端の性能を達成したという。
しくみをやさしく
従来の方式は、机の上のカップと机を別々に作ってから並べるようなものである。それぞれは立派でも、いざ組み合わせるとカップが宙に浮いたり、机にめり込んだりする。Tetris3Dは、名前のとおりテトリスのブロックを噛み合わせるように、物体を作る際に隣の物体の形を見ながら作る。
具体的には、ある物体を生成するとき、すでに分かっている周囲の物体の3D形状と、「上に載っている」「立てかけてある」といった物理的な関係を入力として与える。生成モデルはこの情報を手がかりに、接触面で自然に噛み合う形と向きを選ぶ。写真では物体の下側や裏側が隠れていることが多いが、周囲の形状と関係から、隠れた接触部分を理にかなった形で補える点が要である。
これを可能にしたのがComObである。物理シミュレーションで物体を実際に落下・積載させ、安定した状態になったシーンだけを集めているため、「現実に成立する配置」を大量に学習できる。さらに、どの物体がどの物体を支えているかという関係の注釈が付いているため、関係を条件とする学習が成り立つ。
ビジネスへの示唆
最も恩恵が大きいのは、写真から空間を起こし、その上で何かを置く・動かす・検証する業務である。たとえば小売の店舗開発部門では、棚の陳列写真から陳列状態を3D化し、商品の積み方や見え方を検討する。物流の倉庫運営部門では、荷物が積まれた現場写真から積載状態を復元し、崩れやすさを事前に点検する。建築・不動産の設計部門では、内覧写真から家具配置の3Dモデルを作り、レイアウト提案に使える。
ここで読者に問いたいのは、自部署で「現場の写真を見ながら、人が頭の中で配置や干渉を考えている業務」は何か、という点である。その作業にいま誰がどれだけ手をかけているかを書き出すと、適用候補が見えてくる。
動く可能性のある指標は次のとおりである。
- 設計・提案部門:3Dモデル作成の工数、提案から合意までのリードタイム
- 物流・製造の現場:積載の再作業や破損の件数、点検にかかる手間
- ロボット・自動化部門:ピッキング計画の失敗率、シミュレーション用データの準備負荷
とりわけロボットの分野では、物理的に成立するシーンを大量に生成できることが、学習用・検証用データの整備コストを下げる可能性がある。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:写真を撮っては人が配置や干渉を判断している業務を洗い出し、どこで時間や手戻りが生じているかを可視化する。目指す到達点は、効果が出やすい業務を二つか三つに絞り込み、関係者の共通認識にすることである。
-
差し込み先の設計:新しい専用ツールを増やさず、既存の現場写真の撮影・保管の流れや、使用中の設計・在庫管理の画面に、3D復元の結果を参照情報として添える形を優先する。目指す到達点は、担当者が普段の画面から離れずに結果を確認できる状態である。
-
小さく試す(PoC):一つの部署、数週間の範囲で、実際の現場写真を使って試す。評価は数値の厳密さよりも、担当者が「配置の見落としが減った」「確認の手間が減った」と実感できるかを軸にする。目指す到達点は、現場の納得感と、うまくいかない条件(隠れが多い、物が密集しているなど)の把握である。
-
運用と横展開:判断基準と写真の撮り方の目安を整え、他部署へ広げる。目指す到達点は、属人的だった空間判断が、誰でも一定水準で行える標準業務になることである。
全体として目指す姿は、現場写真から物理的に成立する3D空間が手軽に得られ、設計・点検・自動化の検討が写真一枚から始められる状態である。
今後の展望
本研究は論文段階であり、実運用にあたっては、自社の対象物が学習した物体カテゴリーに含まれるかの確認が欠かせない。また、生成結果はあくまで推定であり、安全に関わる判断では人による確認が前提となる。一方で、物理的整合性を明示的に扱う方向性は、デジタルツインやロボット学習の基盤技術として重みを増すとみられる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
分散学習、勾配クリッピングで最適収束を実証
中央サーバーなしで複数拠点が協調学習する分散SGDに勾配クリッピングを加えるだけで、重い裾のノイズ下でも理論上最適な収束率と参加数に比例した高速化が得られると示された。
LLMの知識を本体不変で更新、EngramEditを提案
研究チームは、条件付きメモリを持つ大規模言語モデルで、本体を変えずに事実知識だけを書き換える手法EngramEditを提案した。再学習なしで規程や仕様の改定に追随できる可能性を示す成果である。
探索と学習を分離しAIの推論力を高める新手法
AIの推論訓練で、新しい解法を探す役と学習する役を分ける手法ExpDisが提案された。同一の計算時間で既存手法DAPOを上回り、多様な正解を出す力も高めた。