動画AIの物理整合性を測る試験が登場
動画生成AIの物理的な正しさを、光学や流体など40課題で定量測定するベンチマークが提案された。最高モデルでも100点中57.76点にとどまり、実務利用前の検証の必要性が浮かんだ。
研究の概要
動画生成AIは、見た目に説得力のある映像を作れる一方、物理的にはあり得ない動きを含むことがある。ロボットや自動運転など、動画モデルを「世界モデル」として予測や計画に使う用途では、この不整合が信頼性の問題となる。
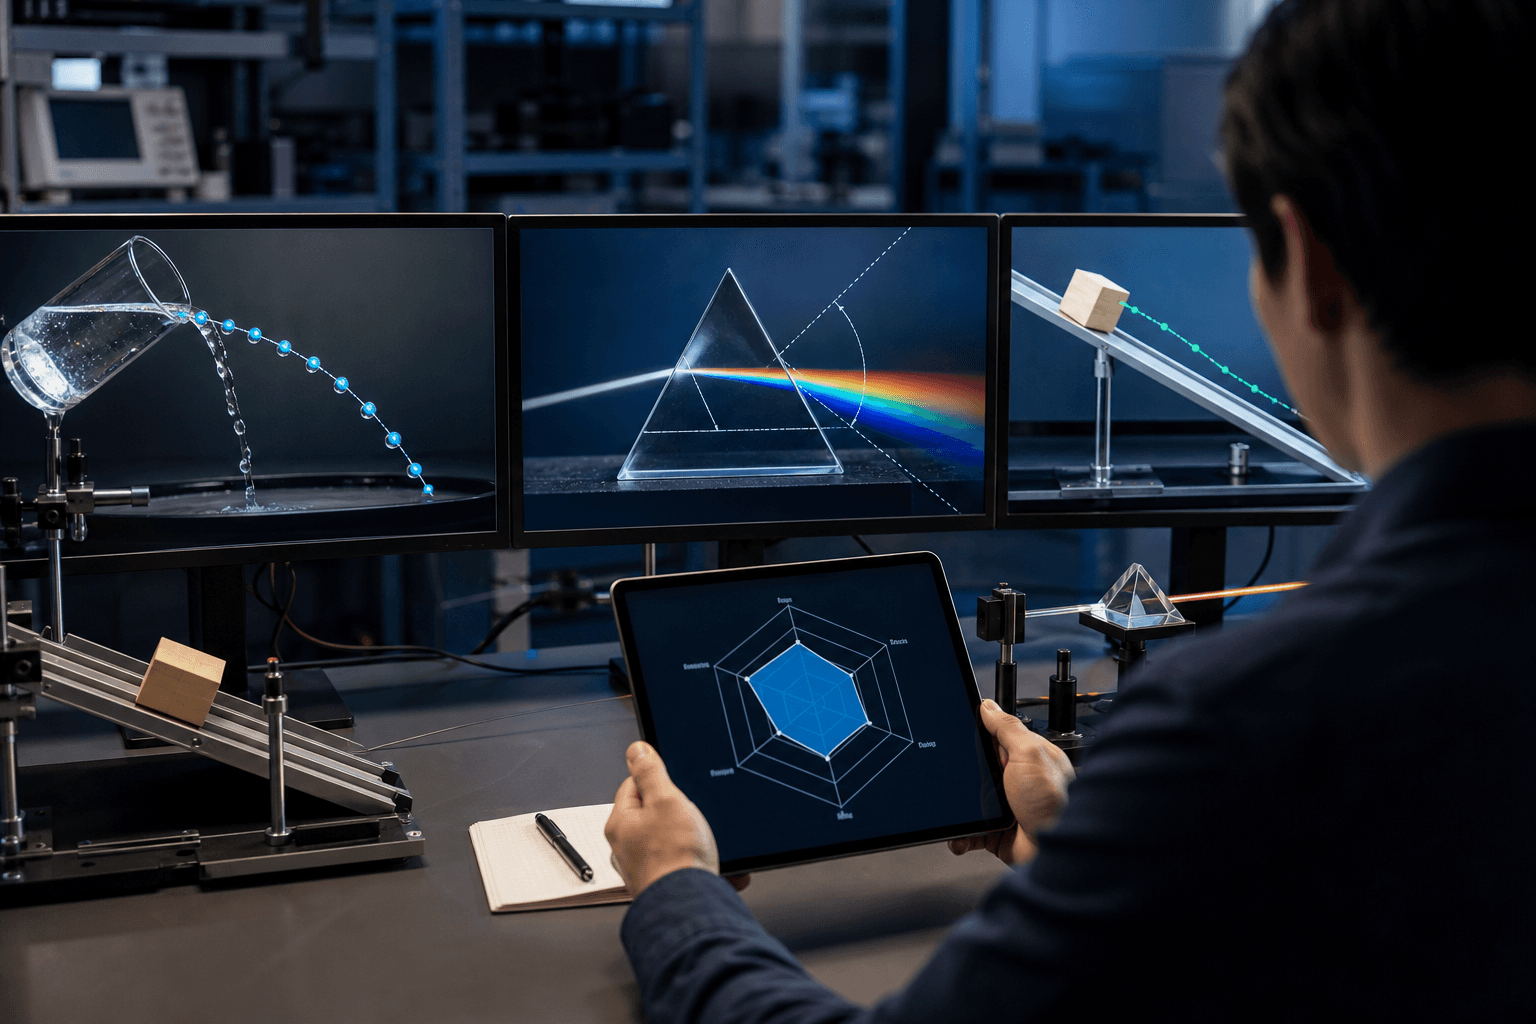
研究チームは、動画世界モデルの物理的整合性を測るWorld Models' Last Exam in Physicsを提案した。課題は40種類で、力学、光学、流体、熱・相変化、電磁気、表面張力の6領域にまたがる。従来の評価は、別のAIによる採点や正解動画との比較に頼る例が多く、直接の物理テストも力学に偏っていた。
8種類の動画生成モデルで計1,280本の動画を評価した結果、物理的な不整合は広く残り、課題ごとの得点差も大きかった。最も高い総合スコアは100点満点中57.76点であった。
しくみをやさしく
各課題は、初期画像と生成指示文、そして事前に定めた物理基準の組で構成される。たとえば「水面に物体を落とす」という課題なら、波の広がり方など、映像から観察できる物理関係が基準になる。正解動画は不要である。
評価器は二段構えである。第一段で「その課題の判定に必要な現象が映像に映っているか」を確認する。物体が画面外に出たり、そもそも現象が起きなかったりした動画は、測定の対象外とする。第二段で、課題ごとに定めた定量測定を行う。物体の軌跡や位置関係など、映像から数値として取り出せる量を測り、物理的な期待値と照合する。
AIに「この動画は自然か」と直接尋ねる方式と違い、点数の根拠が測定値として残る。そのため、どの物理関係が崩れたかを後から追える。
妥当性の確認として、物理関係が既知の合成動画で測定モジュールを検証し、制御条件下での妥当性を示す証拠を得ている。また、人間の判断との一致度では、視覚言語モデルによる直接判定より、課題内の順位付けと一対比較の両方で高い値を示した。測定の限界も明示されている。
ビジネスへの示唆
恩恵を受けるのは、動画生成AIを業務に組み込む部門である。
- 製造業の生産技術部門:工程シミュレーションや作業手順動画の生成。KPIは試作回数、立ち上げ期間
- ロボティクス・物流の研究開発部門:動画モデルによる動作計画。KPIは動作失敗率、手戻り工数
- 広告・EC・映像制作のクリエイティブ部門:商品動画の制作。KPIは修正依頼の回数、制作リードタイム
- 教育・研修部門:実験や安全教育の教材動画。KPIは教材の差し戻し率
自部署で動画生成AIを使う、または使う予定があるなら、まず次の問いを立てるとよい。その業務で「物理的に誤った映像」が出たとき、誰がどれだけ手をかけて見つけ、直しているのか。たとえば飲料の注ぎ動画で液面の挙動が不自然なとき、現状は担当者が目視で気づく以外に手段がない場合が多い。目視確認の工数は、品質管理や法務確認の負担としても表れる。
本研究が示すのは、モデルの選定段階で「どの物理現象に弱いか」を事前に把握できる可能性である。総合点が同程度でも、流体に強いモデルと光学に強いモデルがあり得るため、自社の用途に近い領域の得点で選ぶ判断材料となる。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:動画生成AIを使う、または使いたい業務を洗い出し、物理的な誤りが問題になる場面と、現在の確認の手間を可視化する。目指す到達点は、「どの物理領域の誤りが自社で最も痛いか」を部署が共通認識として持つことである。
-
差し込み先の設計:新しい評価ツールを増やさず、既存の動画制作フローやモデル選定の稟議プロセスに、物理チェックの観点を一項目として加える。自社用途に近い課題だけをベンチマークから選び、小さく始める。目指す到達点は、確認が既存業務の延長で回る状態である。
-
小さく試す(PoC):一部署、数週間の範囲で、候補モデルの出力を課題単位で比較する。現場担当者の実感と測定結果が合うかを確かめる。目指す到達点は、「この指標なら信頼できる」と担当者が納得できることである。
-
運用と横展開:合格基準と、測定の限界(映像に現象が映らない場合は判定できない等)を文書化し、他部署やモデル更新時の再評価へ広げる。目指す到達点は、モデルを入れ替えても品質判断が属人化しない状態である。
全体として目指すのは、動画生成AIの出力を目視頼みで確認する運用から、根拠のある測定値で選び、監視できる運用への移行である。
今後の展望
本ベンチマークは40課題という限られた範囲であり、実際の業務映像すべてを覆うものではない。測定が成立する条件にも制約がある。それでも、見た目の良さではなく物理的整合性を数値で追跡できる基盤は、動画世界モデルを予測や計画に用いる産業にとって、導入判断の土台となり得る。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボ世界モデルDepthWorld、奥行きで精度向上
ロボット操作の予測映像に奥行き情報を加えた世界モデル「DepthWorld」が発表された。奥行きの学習が映像予測自体も改善し、実機を使わない動作評価の信頼性を高める可能性がある。
手と物の動きを高速に3D復元する新手法
4D-HOFは、基盤モデルの粗い推定を生成モデルで補正し、手と物体の相互作用を単一パスで復元する。物理制約も組み込み、個別最適化を不要にする点が注目される。
QF3、人型ロボの歩行学習を10倍速に
米国の研究チームが、フローポリシーを高速に強化学習するQF3を開発した。人型ロボットの歩行を白紙から学習し実機へ直接移植でき、学習時間は従来手法の約10分の1になった。