ロボ世界モデルDepthWorld、奥行きで精度向上
ロボット操作の予測映像に奥行き情報を加えた世界モデル「DepthWorld」が発表された。奥行きの学習が映像予測自体も改善し、実機を使わない動作評価の信頼性を高める可能性がある。
研究の概要
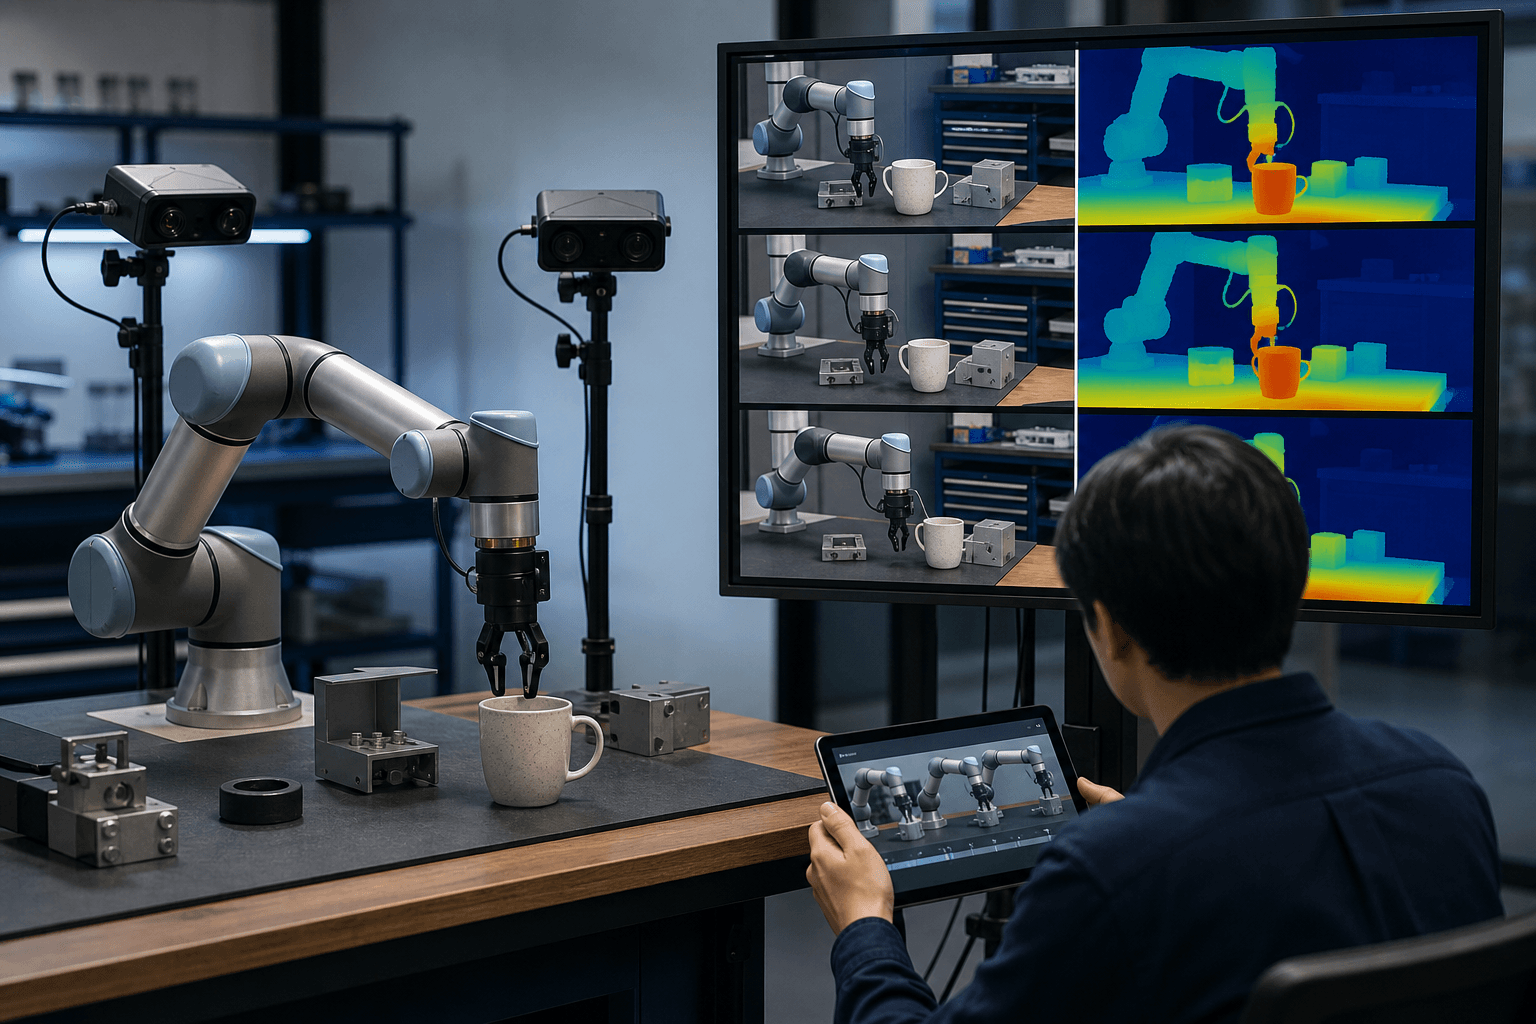
ロボットの動作を実機で試す代わりに、映像生成AIで「この動きをすれば次に何が起きるか」を予測する世界モデルが注目されている。動作方針の評価、改善、計画立案に使えるためである。ただし従来の映像ベースの世界モデルはRGB(通常のカラー映像)だけで学習している。1コマずつは自然に見えても、時間を追うと物体の位置や大きさが食い違い、3次元として整合しない問題があった。
Bardhanらの研究チームは二つの課題に取り組んだ。第一は大規模な3次元教師データの整備である。ロボット操作の公開データセットDROIDに、学習済みのステレオ深度推定と共同ファクターグラフを組み合わせた較正手法を適用し、DROID-3Dを構築した。密な実寸の深度と補正済みのカメラ外部パラメータを備え、外部カメラでは90%のエピソードで再投影誤差が0.7ピクセル未満となった。第二は、Stable Video Diffusionを基にした世界モデルDepthWorldである。複数視点のRGBと深度を同時に予測し、同じ学習量のRGBのみのモデルよりPSNRで1.48dB上回った。
しくみをやさしく
較正とは、カメラやロボットの関節が実際にどの位置・角度にあるかを正確に求める作業である。ファクターグラフは、多数の観測を「互いに矛盾しない答え」を探す一つの問題としてまとめて解く手法である。本研究は、同じ実機ロボットで集めた全記録を束ねて解く。ロボット固有の寸法や関節のずれは全記録に共通し、場面ごとのカメラ位置は記録ごとに違う。両者を同時に推定することで、個別の記録では曖昧な誤差を打ち消せる。
モデル側の工夫は空間潜在タイリングである。各視点のRGBと深度を、既存の画像圧縮器(VAE)で潜在表現に変換する。それをタイルのように並べて一枚の大きな画像とみなし、映像拡散モデルに予測させる。VAEを改変しないため、大量の映像で得た事前学習の知識を壊さずに深度という新しい情報を加えられる。深度を同時に学ぶことで物体の奥行きや前後関係の理解が深まり、RGB予測の質も上がったと解釈できる。
ビジネスへの示唆
恩恵を受けやすいのは、ロボットを使う製造業と物流業である。たとえば生産技術部門では、新製品の投入のたびにロボットの動作教示と干渉確認を現場で繰り返している。物流の倉庫運用部門でも、新しい形状の商品を扱う際にピッキング動作を実機で試行する手間が生じる。奥行きまで整合する世界モデルは、こうした試行の一部を計算機上で先に済ませる土台になり得る。
自部署に置き換えると、問いは次の二つになる。ロボットの動作確認に、いま誰が何日かけているか。実機試験で止めているラインや設備はどこか。影響を受けるのは以下の指標である。
- 生産技術:立ち上げ期間、実機試験の回数
- 品質管理:把持失敗や接触不良に起因する不良率
- 倉庫運用:新規商品の取り込みにかかる準備工数
- 設備保全:試験中の設備停止時間
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:ロボット作業のうち、試行錯誤に時間がかかる工程、失敗が多い工程、実機を止めて試している工程を一覧にする。目指す到達点は、効果を測るべき業務と指標を関係者が共通の言葉で言える状態である。
-
差し込み先の設計:新しいツールを増やさず、既存の動作計画の検証手順に「事前の予測確認」を一段加える形を優先する。カメラの較正記録や作業映像など、すでにある資産を使う。目指す到達点は、現場の作業手順を大きく変えずに使い始められる状態である。
-
小さく試す:一つの工程、一つの部署で数週間試す。世界モデルの予測と実機の結果を担当者が見比べ、「予測は当たっているか、どんな場面で外れるか」を実感で判断する。目指す到達点は、使える場面と使えない場面の線引きが現場の言葉で整理された状態である。
-
運用と横展開:較正の更新頻度、予測を信用する条件、実機確認に戻る基準を文書化し、他の工程や拠点へ広げる。目指す到達点は、予測の信頼度に応じて実機試験を減らす判断が、属人的でなく運用ルールとして回る状態である。
全体として目指すのは、実機での試行錯誤を、計算機上の事前確認で一部置き換えられる現場である。小さく・安く始められる点が利点で、自社の既存カメラ映像から始められる可能性もある。
今後の展望
DROID-3Dは研究用データであり、自社の設備や照明、対象物にそのまま通用するとは限らない。反射する金属部品や透明な物体など、深度推定が難しい対象も残る。それでも、較正済みの3次元データを大規模に整える手法と、既存の映像モデルを壊さずに奥行きを加える設計は、世界モデルを実務の検証手段へ近づける一歩である。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
手と物の動きを高速に3D復元する新手法
4D-HOFは、基盤モデルの粗い推定を生成モデルで補正し、手と物体の相互作用を単一パスで復元する。物理制約も組み込み、個別最適化を不要にする点が注目される。
QF3、人型ロボの歩行学習を10倍速に
米国の研究チームが、フローポリシーを高速に強化学習するQF3を開発した。人型ロボットの歩行を白紙から学習し実機へ直接移植でき、学習時間は従来手法の約10分の1になった。
動画AIの物理整合性を測る試験が登場
動画生成AIの物理的な正しさを、光学や流体など40課題で定量測定するベンチマークが提案された。最高モデルでも100点中57.76点にとどまり、実務利用前の検証の必要性が浮かんだ。