動画編集AI、挿入物を人の動作に連動させる
動画に後から加えた物体が、持ち上げられるなど元映像の動作と噛み合うよう編集するAI「ALIVE」が登場した。撮り直しに頼ってきた広告・研修動画の制作工程を変える可能性がある。
研究の概要
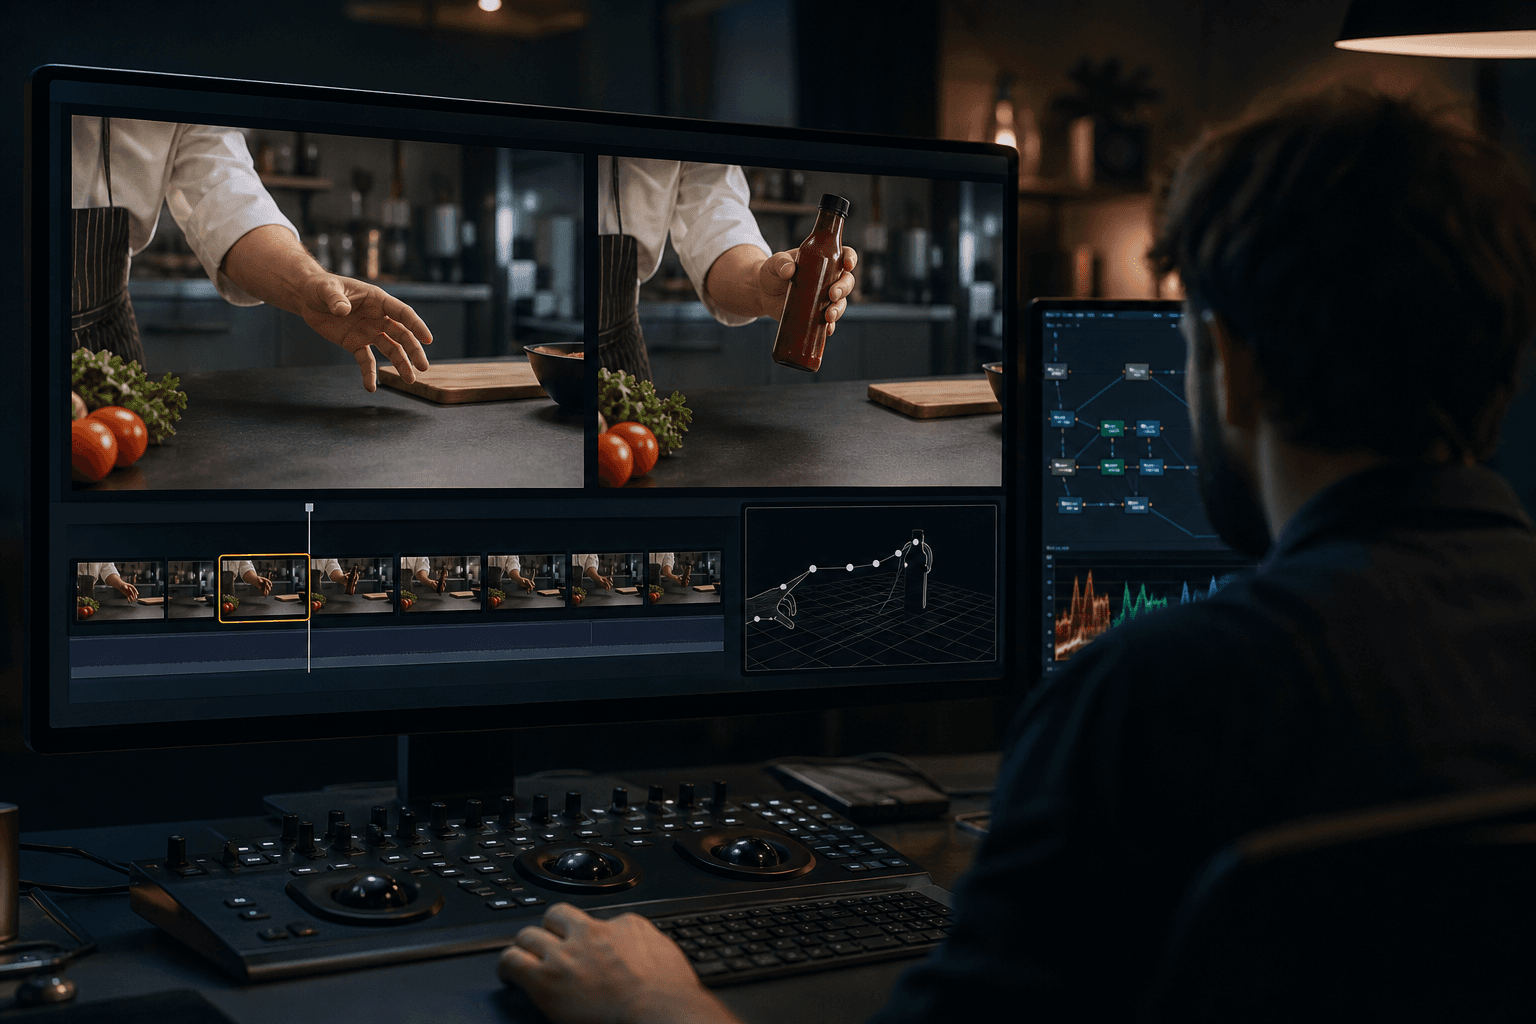
動画に新しい物体を後から加える「物体挿入」は、広告や映像制作の現場で需要が高い。しかし既存の動画編集AIは、挿入した物体が手に持ち上げられる、操作されるといった動きを伴う場面で破綻しやすい。物体が画面に貼り付いたように浮いたり、人物の手と無関係に静止したりする問題である。
Zhenghong Zhou氏らの研究チームは、この課題に対しALIVEを提案した。編集済みの最初のフレームと、追加する物体だけを名指しした指示文を入力すると、元動画の内容と整合した相互作用を持つ物体を動画全体に反映する枠組みである。学習用には、3Dレンダリング、生成モデル、実写の動画に、既存の汎用編集データROSEを加えた3万5800組の編集ペアを整備した。各ペアは対象物体の有無だけが異なり、周囲の動作は保たれている。
評価では、相互作用の忠実度、元映像の保存、視覚的な一貫性を、視覚言語モデル(VLM)による統一プロトコルで測る「ALIVE-interaction」ベンチマークを新設した。VLMの補助がなくても、評価対象の最強ベースラインに対し総合スコアが相互作用ベンチマークで43.9%、汎用の物体挿入ベンチマークで4.4%上回った。VLMが予測した相互作用ガイダンスを加えると、追加の利用者入力なしでスコアはさらに0.95ポイント向上した。
しくみをやさしく
しくみは三つの要素に分けると理解しやすい。第一に「最初のフレーム」による指定である。利用者は動画の1コマ目だけを画像編集で加工し、物体を置いた状態を示す。AIはその1コマを手本に、後続のフレームへ物体を反映させる。動画全体を手作業で直す必要がない。
第二に「対比ペア」による学習である。物体がある動画とない動画を、周囲の動作を同じにして並べて学ばせる。これにより、物体そのものの違いと、物体に合わせて変わるべき手の動きとを区別して身につける。元映像の保存と、物体の連動した振る舞いを両立させる狙いである。
第三にVLMによる案内役である。VLMは同じ入力から「この物体は手に取られる」といった相互作用の指針を言葉で予測し、編集モデルに渡す。人間が細かな動作指示を書く手間を省く役割を担う。
ビジネスへの示唆
効果が見込めるのは、人が物体に触れる動画の差し替え業務である。たとえばEC・食品メーカーのマーケティング部門では、調理や使用シーンの動画で、手に持つ商品がパッケージ改定や新商品のたびに変わる。従来は撮り直しが前提だった。製造業の人材育成部門でも、工具や部品が変わるたびに手順動画を撮影し直している。
自部署に当てはめるなら、次の問いが出発点になる。商品や小物だけが違う動画を、いま誰が何本、どれだけの手間で作っているか。その大半が撮り直しなら、ALIVEの系統の技術が効く余地がある。動きるものの種類が多い業務ほど、元映像を活かせる利点は大きい。
動く可能性のある指標は次のとおりである。
- マーケティング:動画の制作リードタイム、撮り直し回数、地域別・商品別バリエーションの本数
- 人材育成・品質管理:研修教材の更新工数、手順動画の改訂頻度
- 制作会社・広告代理店:案件あたりの制作単価、修正依頼の回数
ただし、実物と異なる見え方になる表現は、景品表示や権利処理の確認を要する。編集の自動化と、公開前の人の確認は切り分けて考える必要がある。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
- 棚卸し:過去の動画案件を洗い出し、「物体だけが違い、動作は同じ」撮り直しがどこで発生しているかを可視化する。目指す到達点は、効果が出やすい業務と、そうでない業務の線引きが関係者の共通認識になることである。
- 差し込み先の設計:新しい制作ツールを増やさず、既存の編集フローや素材管理の中に「1コマ目を画像編集で差し替え、AIが全体に反映する」工程を一つ足す形で設計する。目指す到達点は、現場が普段の手順を大きく変えずに使える状態である。
- 小さく試す(PoC):一つの部署、数週間の範囲で、数種類の商品差し替えに限って試す。担当者が「撮り直しより早いか」「手の動きに違和感がないか」を実感で評価する。目指す到達点は、使える場面と使えない場面の判断材料が手元に揃うことである。
- 運用と横展開:合格基準、公開前の確認者、権利・表示のチェック項目を文書にし、他部署へ広げる。目指す到達点は、品質を保ちながら担当者が替わっても回る運用である。
全体として目指すのは、撮影を「新規の動きを作る場面」に集中させ、物体の違いだけで済む動画は編集で賄う制作体制である。
今後の展望
今回の評価はVLMによる自動採点が中心であり、実際の視聴者の受け止めや、複雑な動作での安定性は現場での検証が欠かせない。それでも、物体を置くだけでなく「関わらせる」ところまで編集が進んだ意義は大きい。動画の量産と個別化が求められる業界にとって、撮影コストの考え方を見直す契機になるだろう。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
画像生成AIの内部を言葉で読み解く手法
画像生成AIの内部状態に自然言語で質問し、生成途中の絵の中身を読み取る手法が提案された。内部情報を品質改善にも使えると示した点で、制作現場の品質管理に影響しうる。
GenCine、3D上で撮影と動きを統合制御
米研究チームは、1枚の画像から3Dシーンを作り、カメラと被写体の動きを同時に指定できる動画生成システムGenCineを発表した。広告や映像制作の工程短縮に直結する技術である。
GALA、アバター動作を最大千分の一に削減
3Dガウシアンアバターの動作計算を線形近似へ蒸留する手法GALAが登場した。CPU負荷を最大3桁削減し、モバイルで60fpsを実現する。メタバースや接客分野の導入費用を左右し得る。