探索と学習を分離しAIの推論力を高める新手法
AIの推論訓練で、新しい解法を探す役と学習する役を分ける手法ExpDisが提案された。同一の計算時間で既存手法DAPOを上回り、多様な正解を出す力も高めた。
研究の概要
サイフ・プンジワニ氏とミカ・ゴールドブラム氏の研究チームは、言語モデルの推論能力を高める強化学習の新たな枠組みExpDis(Exploration-Distillation)を発表した。対象は、答えの正誤を自動判定できる課題を使う「検証可能な報酬による強化学習(RLVR)」である。数学の問題のように正解を機械的に確認できる場面で、訓練済みモデルをさらに鍛える手法として近年広く使われている。
RLVRには、モデルが訓練データにない新しい推論戦略を発見できるという期待がある。しかし実際には、新規性を強く促す報酬を加えると、モデルの品質がかえって低下することが多かった。検証可能な報酬が監督するのはモデルの知識や振る舞いのごく一部にすぎず、一度劣化すると回復が難しいためである。
研究チームは、探索と最適化を一つのモデルに背負わせること自体が問題だと捉えた。そこで両者を切り離した。7つの数学推論ベンチマークと2種類のモデルファミリーで評価した結果、同一の実時間予算において既存手法DAPOを上回った。さらに、pass@kと呼ばれる指標の伸びも改善し、多様な正解を生成できるモデルが得られたことが示された。
しくみをやさしく
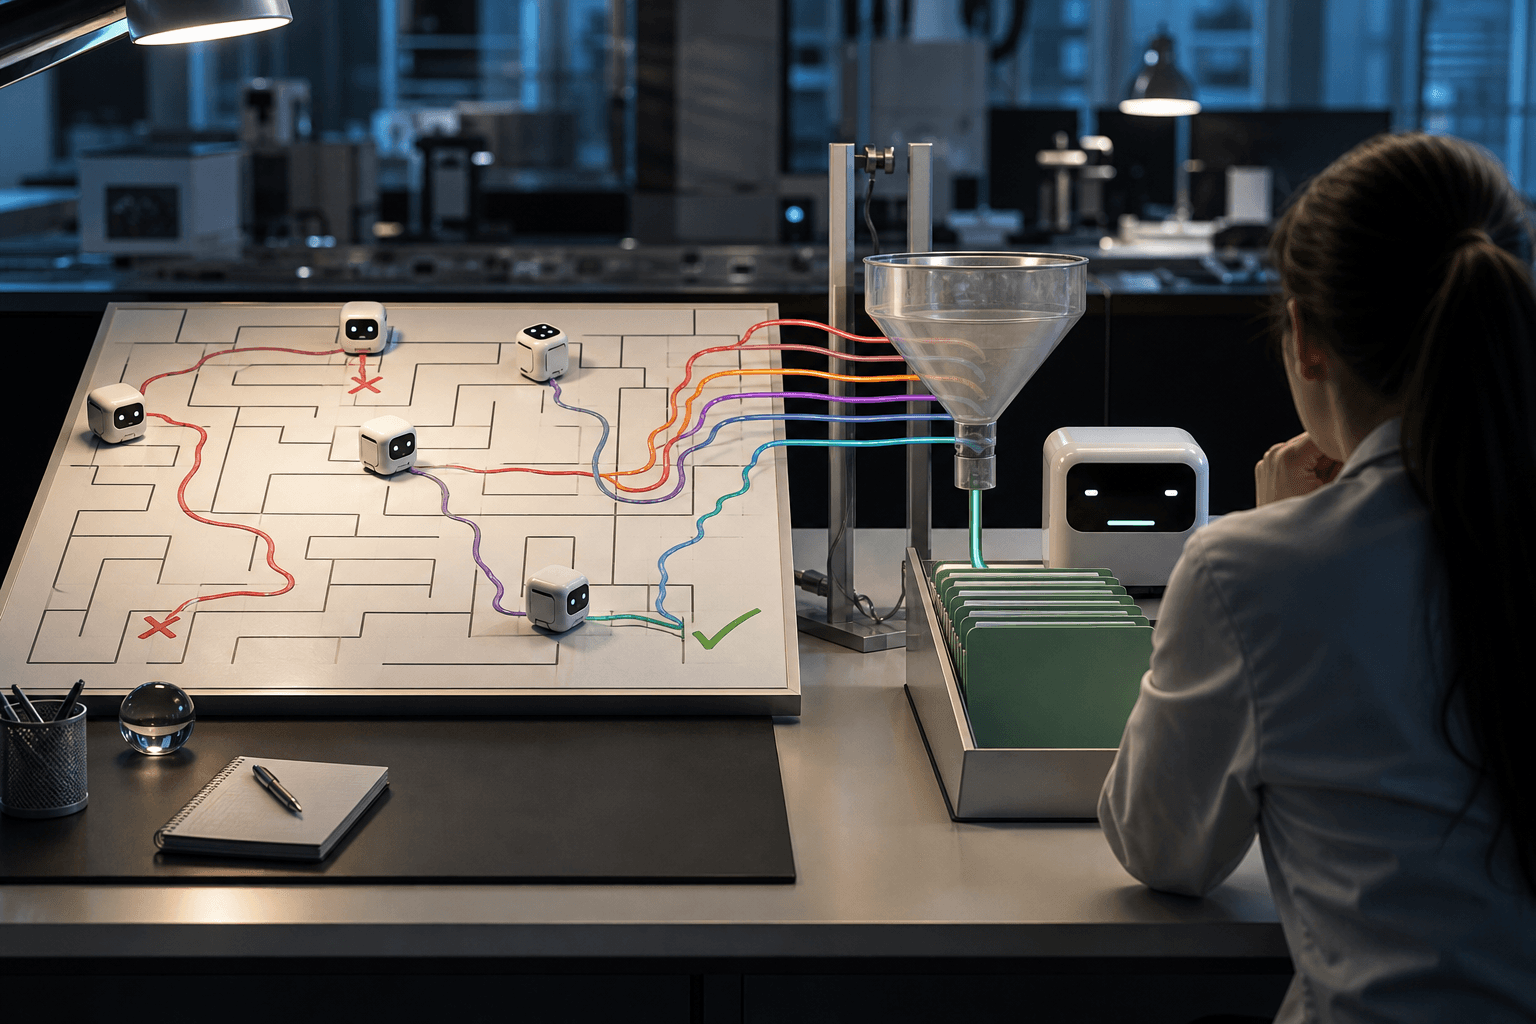
仕組みは、新人研修と先行調査班の関係に例えると理解しやすい。ExpDisでは、まず1つ以上の「探索役(explorer)」モデルを用意する。探索役には、正解に対する報酬に加えて「他と違う解き方をしたら加点する」新規性ボーナスを与える。探索役は品質を多少犠牲にしても、大胆に多様な解法を試す。
次に、探索役が生成した解答の過程(軌跡)を、正しさと品質の観点でふるいにかける。誤答や質の低い解き方は捨て、有望なものだけを残す。残った軌跡を教材として、別個の「生徒役(student)」モデルに蒸留する。蒸留とは、他のモデルの出力を手本として学ばせる手法である。
生徒役の訓練には新規性ボーナスを使わない。したがって、探索の副作用で品質が崩れる恐れがない。この「探索→選別→蒸留」を数ラウンド繰り返し、探索と最適化を交互に進める。探索役が荒れても生徒役は守られるため、探索を積極的に拡大できる点が要である。
pass@kは、k回解答を生成したうち少なくとも1回正解する確率を表す。この伸びが良いことは、1つの解法に偏らず、複数の筋道で正解にたどり着けることを意味する。
ビジネスへの示唆
中核となる考え方は、試行錯誤の担当と、成果を固める担当を分けるという設計である。これは社内のAI活用にも通じる。
例えば、カスタマーサポート部門の問い合わせ対応では、想定外の質問に多様な回答案を出す役と、品質基準を満たす回答だけを定着させる役を分けられる可能性がある。経理部門の仕訳チェックや、開発部門のコードレビュー、品質保証部門の不具合原因分析のように、正誤を検証できる業務は、本手法の考え方と相性が良い。
読者に問いたいのは、自部署で正誤を機械的に確かめられる反復業務は何か、そしていま誰がどれだけ手間をかけているか、である。テストを通るかどうか、突合が一致するかどうかといった判定基準が既にある業務ほど、候補になる。
影響を受けうる指標は次のとおりである。
- 開発部門:テスト通過率、レビュー指摘の手戻り件数
- サポート部門:初回解決率、対応品質のばらつき
- 経理・監査部門:突合作業の確認工数、見落とし率
多様な正解を出せるモデルは、1回で当てる精度だけでなく、複数案から選ぶ運用でも価値を発揮する。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。ただし本論文は数学推論での検証であり、業務への適用は別途の確認が必要である。
-
棚卸し:正誤を自動判定できる業務と、担当者が手を取られている箇所を洗い出す。目指す到達点は、効果が見込める業務の候補を一覧にし、判定基準の有無を可視化することである。
-
差し込み先の設計:新しいツールを増やさず、既存のテスト環境や検索拡張生成(RAG)、チェックリストに載せる方法を検討する。探索用と本番用を分ける発想は、検証用の環境と本番環境を分ける既存の運用に重ねやすい。目指す到達点は、現行のワークフローを大きく変えずに接続点を決めることである。
-
小さく試す(PoC):一部署で数週間、複数案を出す仕組みと選別の基準を試す。小さく・安く始められる範囲にとどめ、担当者の実感で「案の幅」と「手戻り」の変化を確かめる。目指す到達点は、現場が価値を実感できる判断材料を得ることである。
-
運用と横展開:選別基準を文書化し、良質な事例を蓄積して他部署へ広げる。目指す到達点は、基準が共有され、担当者に依存せず回る運用である。
全体として目指すのは、AIに大胆に試させつつ、品質は基準で守る体制の確立である。
今後の展望
ExpDisは数学推論に限った検証であり、判定基準が曖昧な文章作成などへの拡張は今後の課題である。また、探索役と生徒役を別に訓練するため、運用面では管理対象が増える点にも留意が必要である。それでも、探索を品質から切り離すという設計思想は、業務AIの改善サイクルを考える上での有力な参考になるといえる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
分散学習、勾配クリッピングで最適収束を実証
中央サーバーなしで複数拠点が協調学習する分散SGDに勾配クリッピングを加えるだけで、重い裾のノイズ下でも理論上最適な収束率と参加数に比例した高速化が得られると示された。
LLMの知識を本体不変で更新、EngramEditを提案
研究チームは、条件付きメモリを持つ大規模言語モデルで、本体を変えずに事実知識だけを書き換える手法EngramEditを提案した。再学習なしで規程や仕様の改定に追随できる可能性を示す成果である。
AIが持ち物の置き場所を記憶し質問に答える
egocentric映像から物の位置・履歴・文脈を3D記憶に蓄える「Ledger」が登場した。元映像を再参照せず空間質問に答え、HD-EPICの精度を29.7%から42.6%へ高めた。