QF3、人型ロボの歩行学習を10倍速に
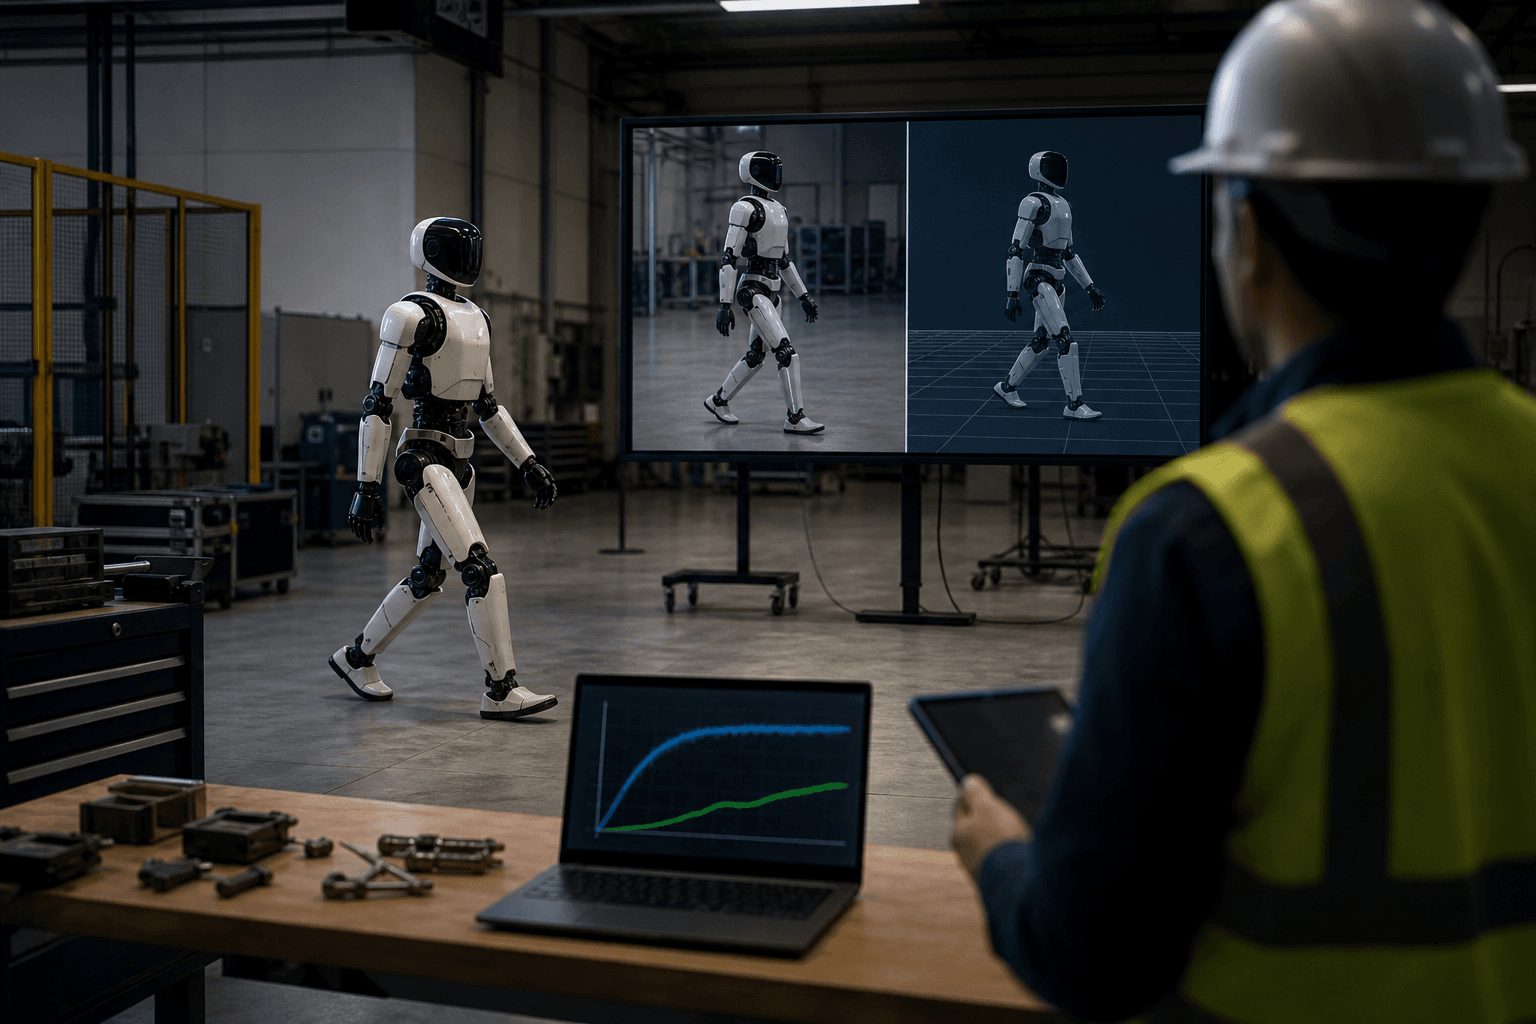
米国の研究チームが、フローポリシーを高速に強化学習するQF3を開発した。人型ロボットの歩行を白紙から学習し実機へ直接移植でき、学習時間は従来手法の約10分の1になった。
研究の概要
カリフォルニア大学バークレー校などの研究チームは、ロボットの動作を生成する「フローポリシー」を、試行錯誤で鍛える強化学習アルゴリズムQF3(Fast Flow RL with Filtered Q-Gradients)を発表した。フローポリシーとは、ノイズから行動を段階的に生成するモデルであり、人間の実演から動作を学ぶ手法として標準的な地位を築きつつある。ただし実演だけでは性能に限界があり、強化学習による改善が欠かせない。
QF3はオフポリシー型、すなわち過去の経験を蓄えたリプレイバッファから繰り返し学習する方式である。論文によれば、フローポリシーを用いたオフポリシー手法として初めて、人型ロボットの歩行方策をゼロから学習し、追加調整なしで実機へ移すことに成功した。高スループットな学習レシピと組み合わせると、人型ロボットの歩行とモーショントラッキングの学習で、最近のオンポリシー型手法FPO++に対し実時間で10倍の高速化を達成したという。さらに、実演で事前学習したマニピュレーション方策を、ABC-SimとRobomimicの課題で微調整できることも示した。
しくみをやさしく
従来、フローポリシーの強化学習は難しいとされてきた。行動の生成が複数ステップの計算を経るため、評価役である「クリティック」の判断を出発点まで逆伝播させると、計算が重く不安定になるからである。
QF3は二つの工夫でこれを解決する。第一に、フローマッチングによる通常の学習に加え、クリティックが示す「行動をどちらへ動かせば価値が上がるか」という勾配(Q勾配)を使う。このとき、フローが出力する行動を一段階の予測で近似し、そこへ勾配を逆伝播させる。多段の計算を一度に省略する発想である。
第二に、フィルタリングである。クリティックは、過去の経験から大きく外れた行動については、評価が不正確になりやすい。そこでQF3は、リプレイバッファ内の行動に近い次元にだけクリティックの勾配を適用する。たとえるなら、地図が整備された道の範囲でのみ新しい経路を試すようなものであり、信頼できない領域への暴走を防ぎつつ、着実に改善を進められる。
ビジネスへの示唆
この技術が効くのは、「シミュレーションで動作を学習させ、現場の実機に載せる」業務である。たとえば物流倉庫の自動化部門では、ピッキングロボットの動作調整に、技術者が現場で試行を重ねているはずである。製造業の生産技術部門では、組立ロボットの教示作業に熟練者の時間が割かれている。自部署で、ロボットの動作を調整する業務は何か、その作業にいま誰がどれだけ手をかけているかを、まず問うてみたい。
影響を受けやすい部門と、動きうるKPIは次のとおりである。
- 生産技術・ロボット導入部門:立ち上げリードタイム、教示工数
- 物流・倉庫運営部門:新規品目への対応期間、ライン停止時間
- 研究開発部門:モデル学習の計算コスト、試作サイクルの回転数
学習が速くなれば、同じ計算資源で試せる設計案が増える。実演データに頼る従来の導入では、データ収集の手間がボトルネックになりがちだった。QF3のように実演後の改善を効率化できれば、教示の手間を減らせる可能性がある。ただし論文の実験は研究環境での検証であり、個別の工場や倉庫での効果は別途確かめる必要がある。
現場での導入イメージ
仮に導入支援に入るなら、次の4段階で進めることになる。
-
棚卸し:ロボットの動作調整や教示に、どの工程でどれだけ人手がかかっているかを可視化する。実演データが既にあるか、シミュレーション環境を作れるかも確認する。目指す到達点は、「強化学習で改善する価値のある動作」の候補一覧が、現場の合意で絞り込まれた状態である。
-
差し込み先の設計:新しい基盤を丸ごと導入せず、既存のロボット制御や、すでに使っている模倣学習の方策に、微調整の工程として追加する形を優先する。目指す到達点は、現行の運用フローを変えずに「実演後の改善ステップ」だけが加わった構成である。
-
小さく試す(PoC):一つの部署、一つの動作を対象に、数週間規模で検証する。まずはシミュレーション上で改善を確認し、現場担当者が「調整の手間が減った」と実感できるかを基準に評価する。目指す到達点は、担当者の実感を伴った小さな成功事例である。
-
運用と横展開:安全確認の基準、学習結果の評価指標、実機への移行手順を文書化し、ほかのラインや拠点へ広げる。目指す到達点は、担当者が入れ替わっても再現できる標準手順である。
全体として目指すのは、実演で土台をつくり、強化学習で磨き込むサイクルが、特定の専門家に依存せず現場で回る状態である。
今後の展望
論文は、QF3がゼロからの学習と、実演で得た方策の改善の両方に使えると結論づけている。今後は、より多様な作業や実環境での検証が課題となる。ロボットの導入コストを左右するのは学習時間と調整工数であり、その短縮は、人手不足に直面する製造・物流分野での自動化の裾野を広げる一歩になりうる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボ世界モデルDepthWorld、奥行きで精度向上
ロボット操作の予測映像に奥行き情報を加えた世界モデル「DepthWorld」が発表された。奥行きの学習が映像予測自体も改善し、実機を使わない動作評価の信頼性を高める可能性がある。
手と物の動きを高速に3D復元する新手法
4D-HOFは、基盤モデルの粗い推定を生成モデルで補正し、手と物体の相互作用を単一パスで復元する。物理制約も組み込み、個別最適化を不要にする点が注目される。
動画AIの物理整合性を測る試験が登場
動画生成AIの物理的な正しさを、光学や流体など40課題で定量測定するベンチマークが提案された。最高モデルでも100点中57.76点にとどまり、実務利用前の検証の必要性が浮かんだ。