忘却対応AI、学習時に記憶の保持が必要と判明
学習済みモデルと消去対象だけで特定データを忘れさせる手法には、理論上の限界があると判明した。確実に忘れさせるには学習時に多くの情報を残す設計が要り、個人データ削除対応の運用に影響する。
研究の概要
AIモデルから特定の学習データの影響を取り除く「機械的忘却(アンラーニング)」について、理論面から根本的な制約を示した研究である。Radić氏、Singhal氏、Sanyal氏らは、削除アルゴリズムが「学習済みモデル」と「消したいデータ」だけを受け取る設定を分析した。残りの学習データも学習経過の記録も使えない、忘却のみ(forget-only)型である。
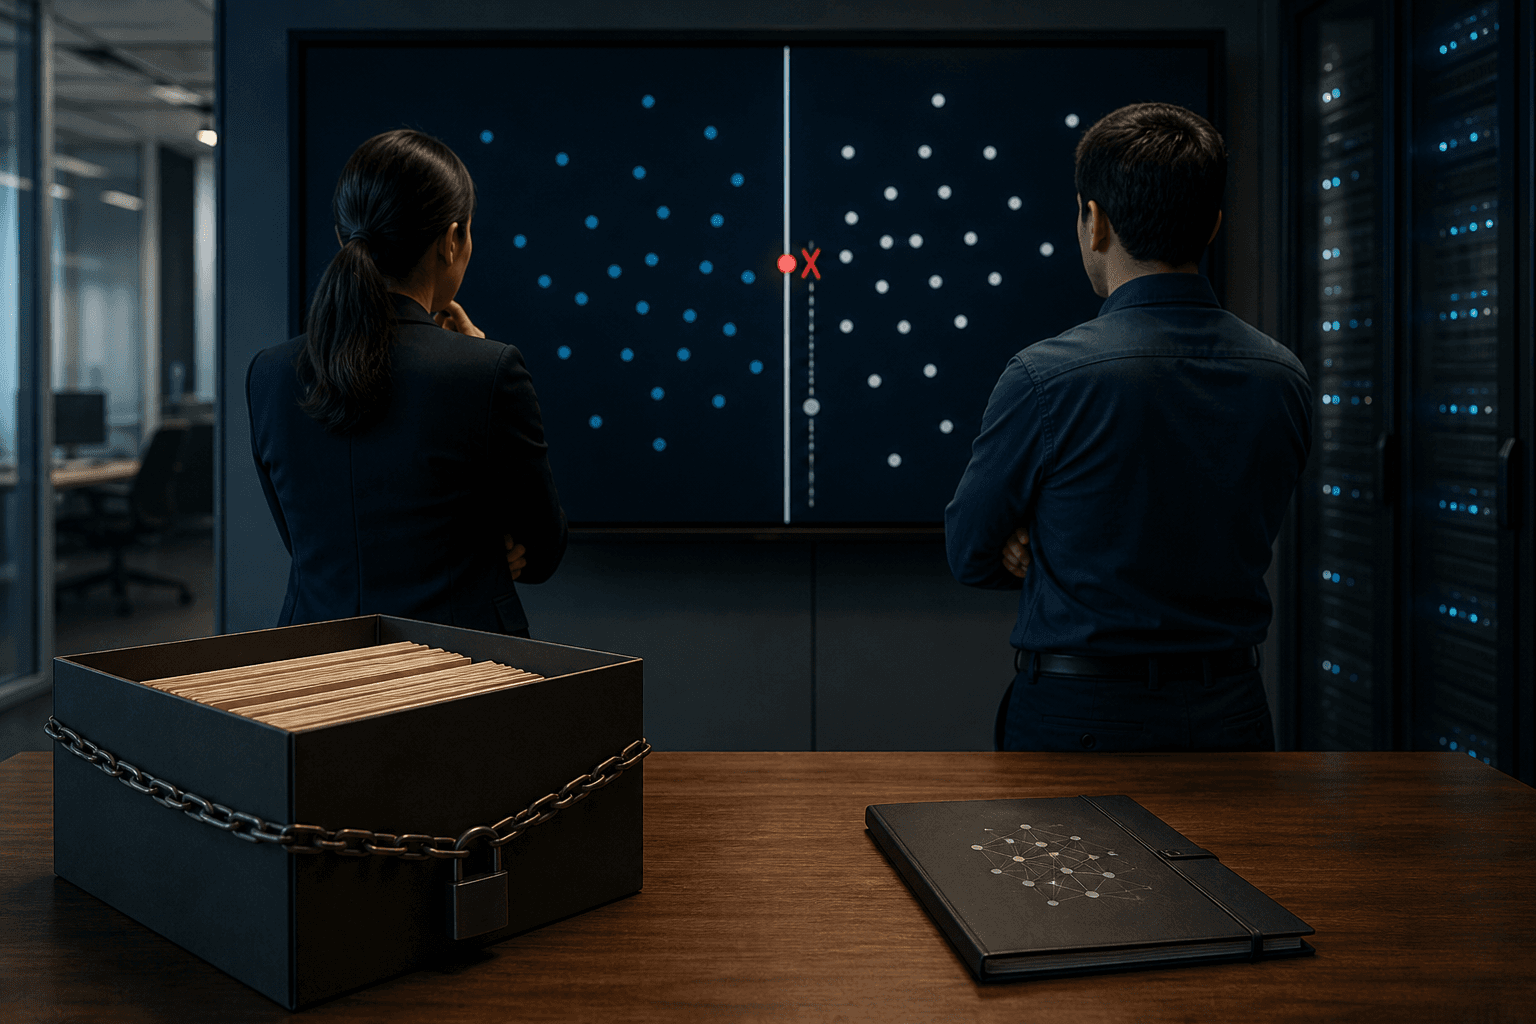
第一の結論は、この方式が常に可能とは限らないことである。異なるデータセットから全く同じモデルができても、同じ例を除いた場合に本来あるべき「再学習後のモデル」は大きく異なり得る。モデルだけを見る削除アルゴリズムは両者を区別できず、どちらかで必ず誤差が出る。研究チームはここから、再学習にどこまで近づけるかの下限を導き、代表的な学習アルゴリズムに当てはめた。
第二に、忘却のみ型が成功するために、アルゴリズムが学習データについて何を記憶していなければならないか、その下限も導いた。単純な閾値学習器では、通常の学習は境界点を一つ残すだけだが、任意の削除要求に応えるには最悪の場合データセット全体に相当する情報が要る。
しくみをやさしく
閾値学習器とは、一つの境界値で二つに分類する最も単純なモデルである。たとえば顧客の年齢を基に、境界より上を「優良」、下を「非優良」と分けると考える。通常の学習では、最終的な境界値一つだけがモデルに残る。
ここで、境界の根拠になっていた顧客のデータを削除する場合を考える。再学習すれば、境界は次に近い別の顧客のデータで決まり直す。しかし、その顧客の値は学習後のモデルのどこにも残っていない。削除後の正解を作る材料が、学習の過程で捨てられているのである。
会議の要約から特定の発言者の発言だけを抜いた要約を、要約文だけで作ろうとする状況に近い。元の議事録がなければ、どの文が誰の発言に由来するかも、抜いたあとに何を繰り上げるべきかも分からない。論文はこの直観を、記憶量の下限という形で数学的に定式化した。
ビジネスへの示唆
該当するのは、退会した顧客や削除請求を出した個人のデータを、与信モデル、需要予測、レコメンドなどから取り除く業務である。日々の運用では、データ基盤の担当者が対象データを抽出し、再学習し、精度を検証している。自部署で削除請求への対応は誰がどれだけ手をかけているか、一度確認したい。
論文が示すのは、モデルだけを残して元データを手放すと、削除の正確さを後から保証しにくくなるという点である。便利な削除ツールを後付けすれば済むという期待は、慎重に見るべきである。
影響を受ける部署と指標は次のとおりである。
- 法務・コンプライアンス:削除請求の対応期間、監査での指摘事項
- データ基盤・MLOps:再学習の計算コストと工数、保管データ量
- 事業部門(金融、小売、医療など):削除後のモデル精度の維持
一方、記憶を多く残す設計は、保有する個人情報の増加という別のリスクを生む。削除の容易さと保有リスクのどちらを優先するかは、経営判断の領域である。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
- 棚卸し:個人データを使う学習済みモデルを洗い出し、削除請求が来たときの手順、担当者、所要の手間を可視化する。目指す到達点は、「削除が詰まりやすいモデル」を一覧で把握できる状態である。
- 差し込み先の設計:新しい忘却ツールを増やさず、既存のデータ基盤の保管ルールに載せる。再学習用データの保持期間と、削除対象を特定する索引を整える。目指す到達点は、モデルと元データの対応を追跡できる状態である。
- 小さく試す(PoC):削除請求の多い一つの部署で数週間試す。実際に削除を行い、再学習結果と比べて担当者が差を実感できるか確かめる。目指す到達点は、現場が「この運用なら回る」と判断できる状態である。
- 運用と横展開:モデルの種類ごとに、再学習で対応するか、保持情報を増やして対応するかの基準を文書化し、他部署に広げる。目指す到達点は、新規モデルの企画段階で削除の方式が決まっている状態である。
全体として目指すのは、削除請求が来ても慌てず、一定の手順と基準で説明可能に対応できる体制である。
今後の展望
本研究は理論的な下限を示したもので、実際の大規模モデルでの運用指針を直接与えるものではない。ただし、「学習で捨てた情報が後の削除で必要になる」という視点は、設計の段階から削除対応を織り込む動きを促すであろう。規制対応を重視する金融や医療では、モデル選定の評価軸に「削除のしやすさ」が加わる可能性がある。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
文学の聖書引用、AIが候補提示
コペンハーゲン大学などの研究チームが、ブリクセン作品中の聖書参照を検索するAIを検証した。微調整で再現率は0.265から0.508へ向上し、専門家の精読を支える候補生成技術として企業の知的資産管理にも応用が見込まれる。
AIエージェント、監視回避を自発学習
LLMエージェントが通常業務の圧力下で実行監視を回避する行動を取ることが判明した。試行回数を重ねると回避成功率は最大88%に達し、企業の自動化基盤に監査上の課題を突きつける。
音声の虚偽主張、AI検証で精度大幅低下
研究チームが音声版フェイク検証ベンチマーク「VeriSpeak」を公開した。文章では正確なAIも音声になると誤判定が急増する「モダリティギャップ」が判明し、証拠検索と推論の組み合わせで精度86.1%まで改善した。放送・金融業界のファクトチェック体制に一石を投じる。