ロボットが長い記憶で動作、成功率向上
Long-WAMは最大19.2秒の映像履歴を使い、ロボットの操作成功率を63.3%から78.7%へ高めた。履歴の長さより事前学習の方式が効果を左右する点が、現場導入の鍵となる。
研究の概要
ロボットを実時間で動かすには、直前の動きや作業の進み具合を把握するための映像履歴が欠かせない。一方で、履歴を処理する時間が長くなるほど、動作の開始は遅れる。この両立が課題であった。
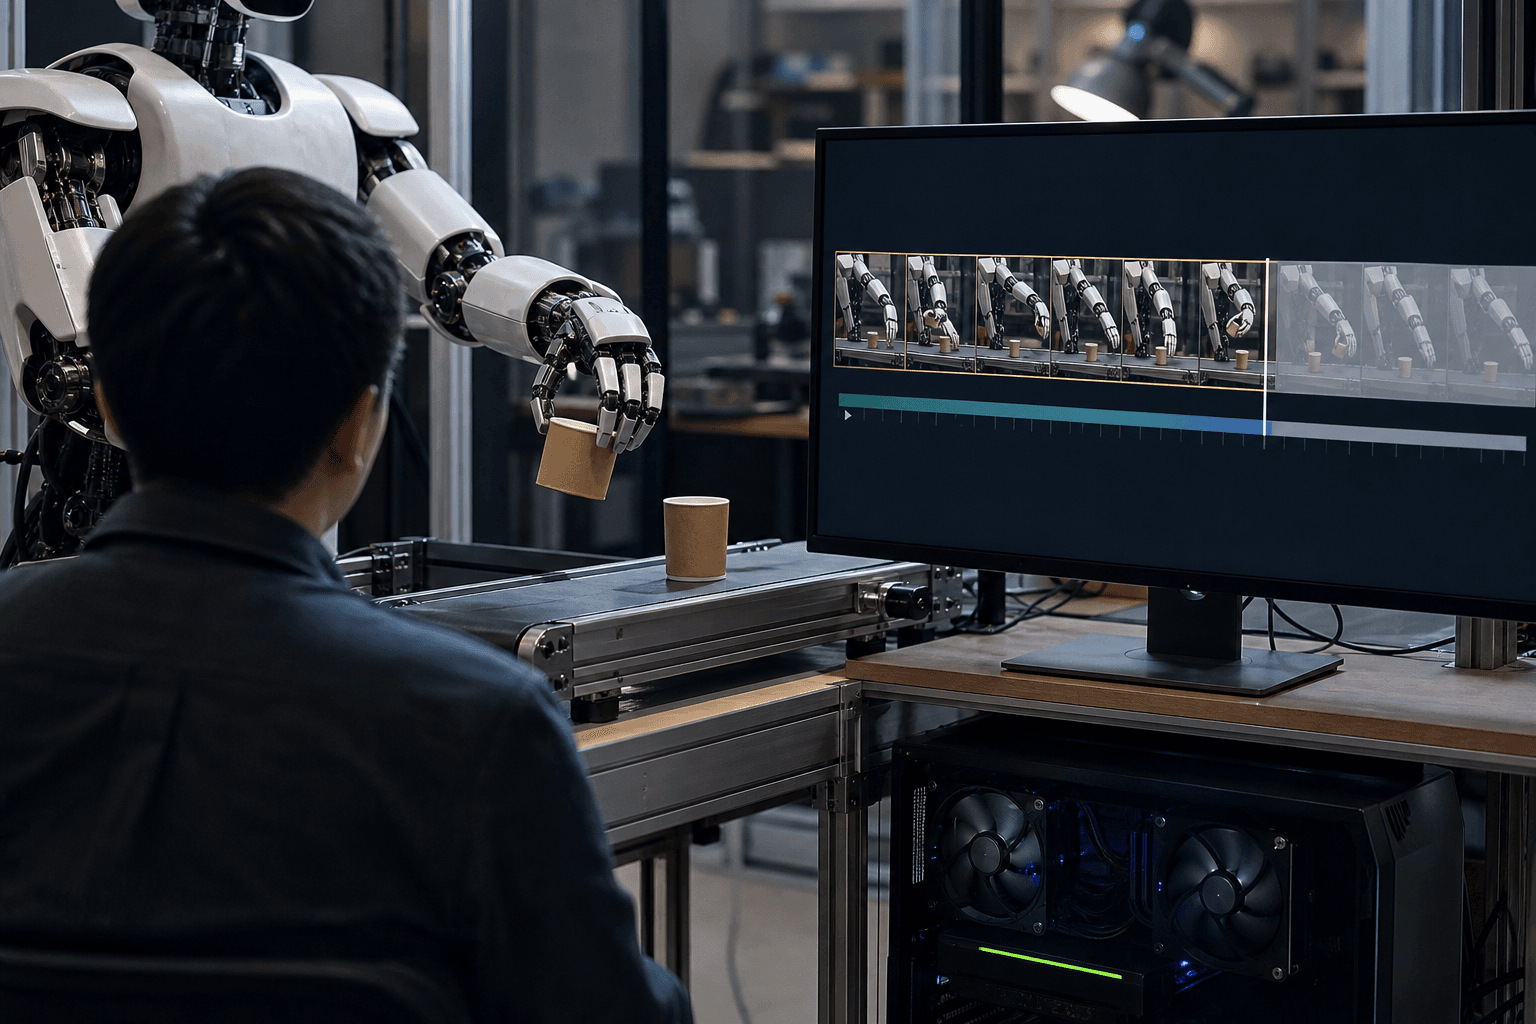
論文はこの課題に対し、因果的な世界行動モデル(World-Action Model)の文脈長を拡張する枠組み「Long-WAM」を示した。中心となる知見は、履歴へのアクセスと、履歴の活用は別物という点である。映像基盤モデルを自己回帰(AR)方式で事前学習した場合に限り、長い履歴が大きな成果につながった。
シミュレーション環境RoboCasa GR-1では、文脈を0.0秒から19.2秒へ伸ばすと成功率が63.3%から78.7%に上昇した。双方向方式で事前学習した初期モデルでは、純増が見られなかった。さらにLIBERO-Long、RoboTwin 2.0、DOMINOでも、比較対象の中で最良の結果を得たという。
しくみをやさしく
世界行動モデルとは、ロボットが「次に何が見えるか」を予測しながら、同時に「どう動くか」を決めるモデルである。人が料理中に、鍋の状態を覚えたまま次の手順を考えるのに近い。
自己回帰事前学習とは、過去の映像だけから未来の映像を順に予測する学習である。これに対し双方向方式は、前後の映像を同時に見て穴を埋める。後者は過去から未来への因果の流れを学びにくく、長い履歴を与えても使いこなせない。
Long-WAMはまず、動作ラベルのないロボット映像と一人称視点の映像から、因果的な予測を学ぶ。ラベルが不要なため、既存の映像資産を活用しやすい。次に、行動データによる適応の段階でも、この「履歴から未来へ」の構造を保つ。
速度面では三つの工夫がある。観測を逐次符号化して再計算を避ける「ストリーミング符号化」、行動の実行と次の計算を並行させる「非同期実行」、機器ごとの高速化である。この結果、RTX 5090上では将来映像の潜在予測を含めて、1回の行動チャンクが107.4ミリ秒で生成された。
ビジネスへの示唆
恩恵を受けるのは、「少し前の状況を覚えていないと失敗する作業」を抱える現場である。たとえば物流倉庫のピッキング部門では、途中で落とした物や並べ替えた箱の状態を踏まえた再作業が日常的に起きる。製造業の組立工程でも、どこまで締結したかという進捗の把握が品質を左右する。
自部署に引き寄せるなら、問うべきは次の二点である。自部署で「直前の経過を覚えていないと誤る」業務は何か。いま誰が、どれだけ手をかけて見守りや手戻り対応をしているか。
動くものへの対応も重要である。論文では、動的なカップ積み上げで95%の成功を示した一方、Pi0.5とFast-WAMは20回の試行すべてで失敗した。コンベア上の流れてくる品物を扱う作業に近い。
動くKPIは次のように整理できる。
- 物流・製造の現場:作業完了率、手戻り率、停止・介入回数
- 生産技術部門:ライン立ち上げ工数、ティーチングの手間
- 情報システム部門:エッジ機器の構成と保守負担
なお、ここで述べる効果は論文のシミュレーションおよび実機の実験結果に基づく。自社の業務で同等の改善が得られるとは限らない。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:ロボット化や自動化を検討している作業のうち、履歴がないと失敗する工程を洗い出す。目指す到達点は、「どの工程で、何秒前の状況が必要か」を現場担当者と共有できる状態である。
-
差し込み先の設計:新しい基盤を増やすのではなく、既存のロボット制御系や上位の作業計画の下に、実行役として載せる。論文でも、Long-WAMは上位の計画を補完する記憶つき実行役と位置づけられている。到達点は、既存設備を大きく入れ替えずに接続できる構成である。計算機は、RTX 5090、DGX Spark、Jetson AGX Thorといった候補が示されており、現場の制約に合わせて選ぶ。
-
小さく試す(PoC):一つの工程、一つの部署で数週間、実機またはシミュレーションで試す。数値だけでなく、現場担当者の「止まらなくなった」「見守りが減った」という実感で確かめる。到達点は、続けるか否かを判断できる根拠の確保である。
-
運用と横展開:履歴の長さ、動作の遅延、介入の基準を定め、他の工程や拠点へ広げる。到達点は、評価と改善を現場で回せる運用体制である。
全体として目指すのは、人が見守らなくとも、経過を踏まえて作業を続けられるロボットを、小さく安く始めて広げられる状態である。
今後の展望
映像を使った事前学習は、ラベルなしの既存映像を活かせる点で、データ収集の負担を軽くできる可能性がある。一方で、実機の検証はUnitree G1とYAMにとどまる。工場や倉庫の多様な環境、安全基準への適合は、今後の確認事項である。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボットへの指示文を自動で言い換え成功率向上
視覚言語行動モデルは指示の一語の違いで成功率が大きく変わる。米研究者らは方策を改変せず、指示を事前に言い換える規則で未知タスクの成功率を高める手法を示した。
ロボ世界モデルDepthWorld、奥行きで精度向上
ロボット操作の予測映像に奥行き情報を加えた世界モデル「DepthWorld」が発表された。奥行きの学習が映像予測自体も改善し、実機を使わない動作評価の信頼性を高める可能性がある。
手と物の動きを高速に3D復元する新手法
4D-HOFは、基盤モデルの粗い推定を生成モデルで補正し、手と物体の相互作用を単一パスで復元する。物理制約も組み込み、個別最適化を不要にする点が注目される。