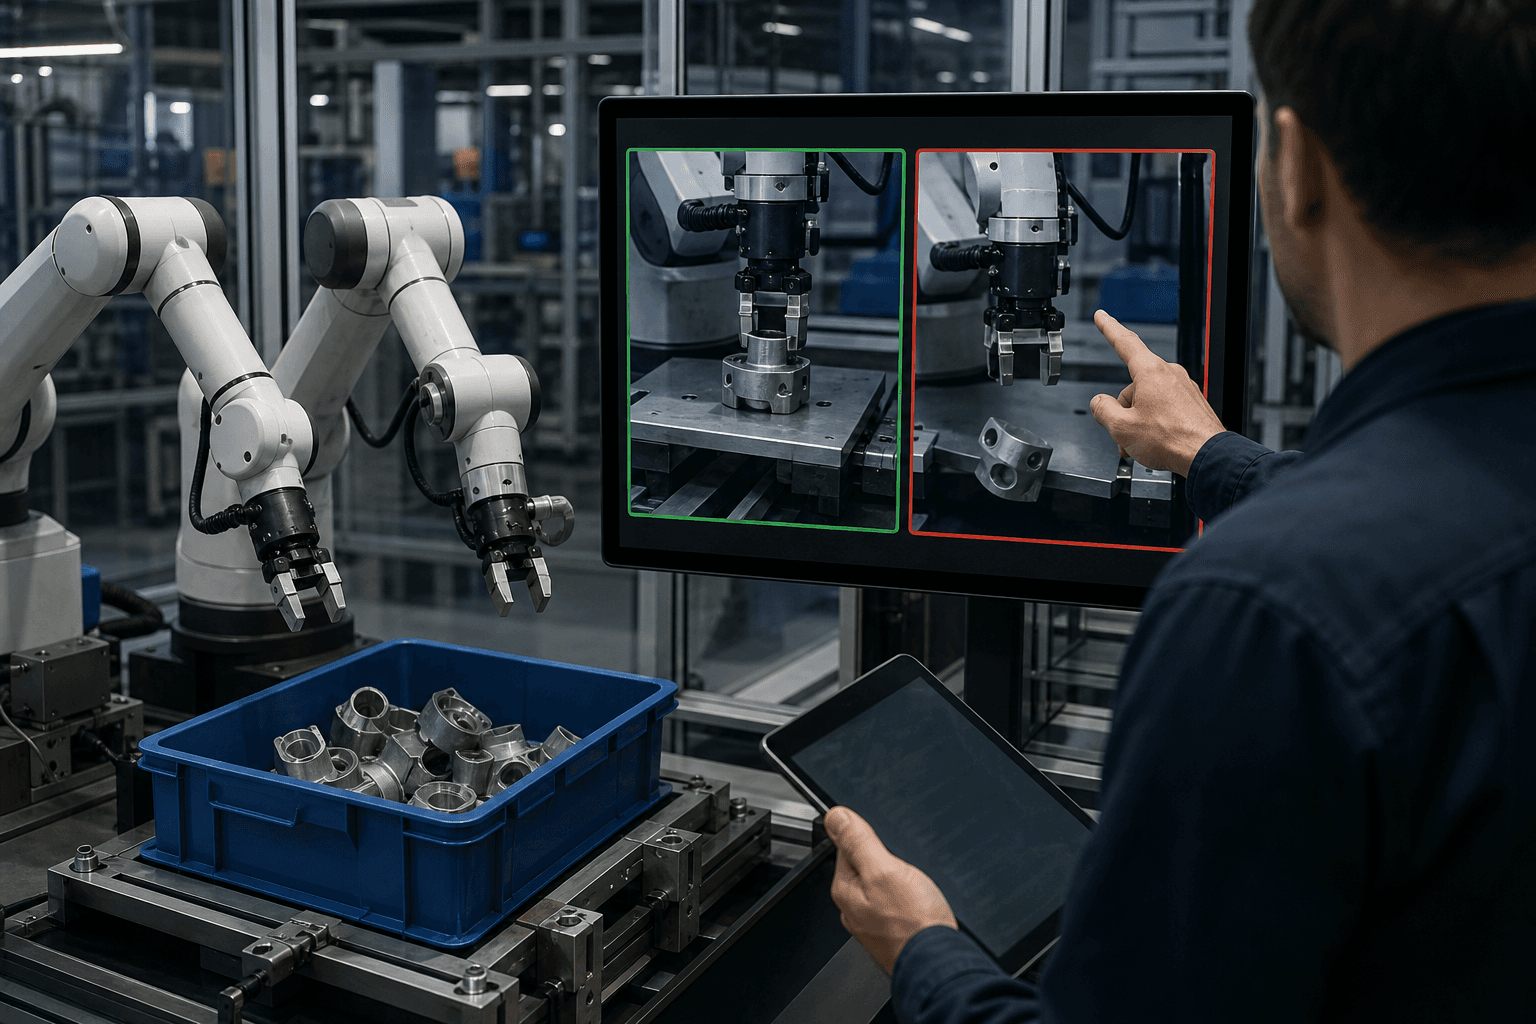
ロボット学習、成功境界に絞り効率化
米研究チームは、ロボットの強化学習で習熟度の「境界」にある課題へ学習を集中させる手法SGSを開発した。100万超の並列環境でも効果が出て、組立や脚式移動の自動化に道を開く。
研究の概要
米国の研究チームは、ロボット制御の強化学習で、学習の対象を方策の能力の「境界」に絞り込む手法 Success Guided Sampling(SGS) を発表した。ワシントン大学などの研究者らによる成果である。シミュレーション上で最大2の20乗、すなわち100万を超える並列環境を動かした実験で、従来手法では解けなかった多地形の四足歩行と、接触の多い精密組立を解いたと報告している。
背景には、ロボットの強化学習に伴う設計負荷がある。従来は課題ごとに報酬関数を細かく調整し、人間のお手本(デモンストレーション)も用意する必要があった。近年は、さまざまな初期状態からやり直せるシミュレータの「リセット」と大規模並列計算を組み合わせ、この負荷を減らす流れが出ている。ただし著者らは、これをより精密で動的な課題へ単純に拡大しても、期待した効果が得られないことを確認した。
原因は、初期状態を一様にランダムに選ぶ点にある。すでに習熟した状況と、現状では手も足も出ない状況に学習経験の多くが費やされ、実際に学べる情報が少なくなる。並列環境を増やしても、無駄な経験が増えるだけになる。
しくみをやさしく
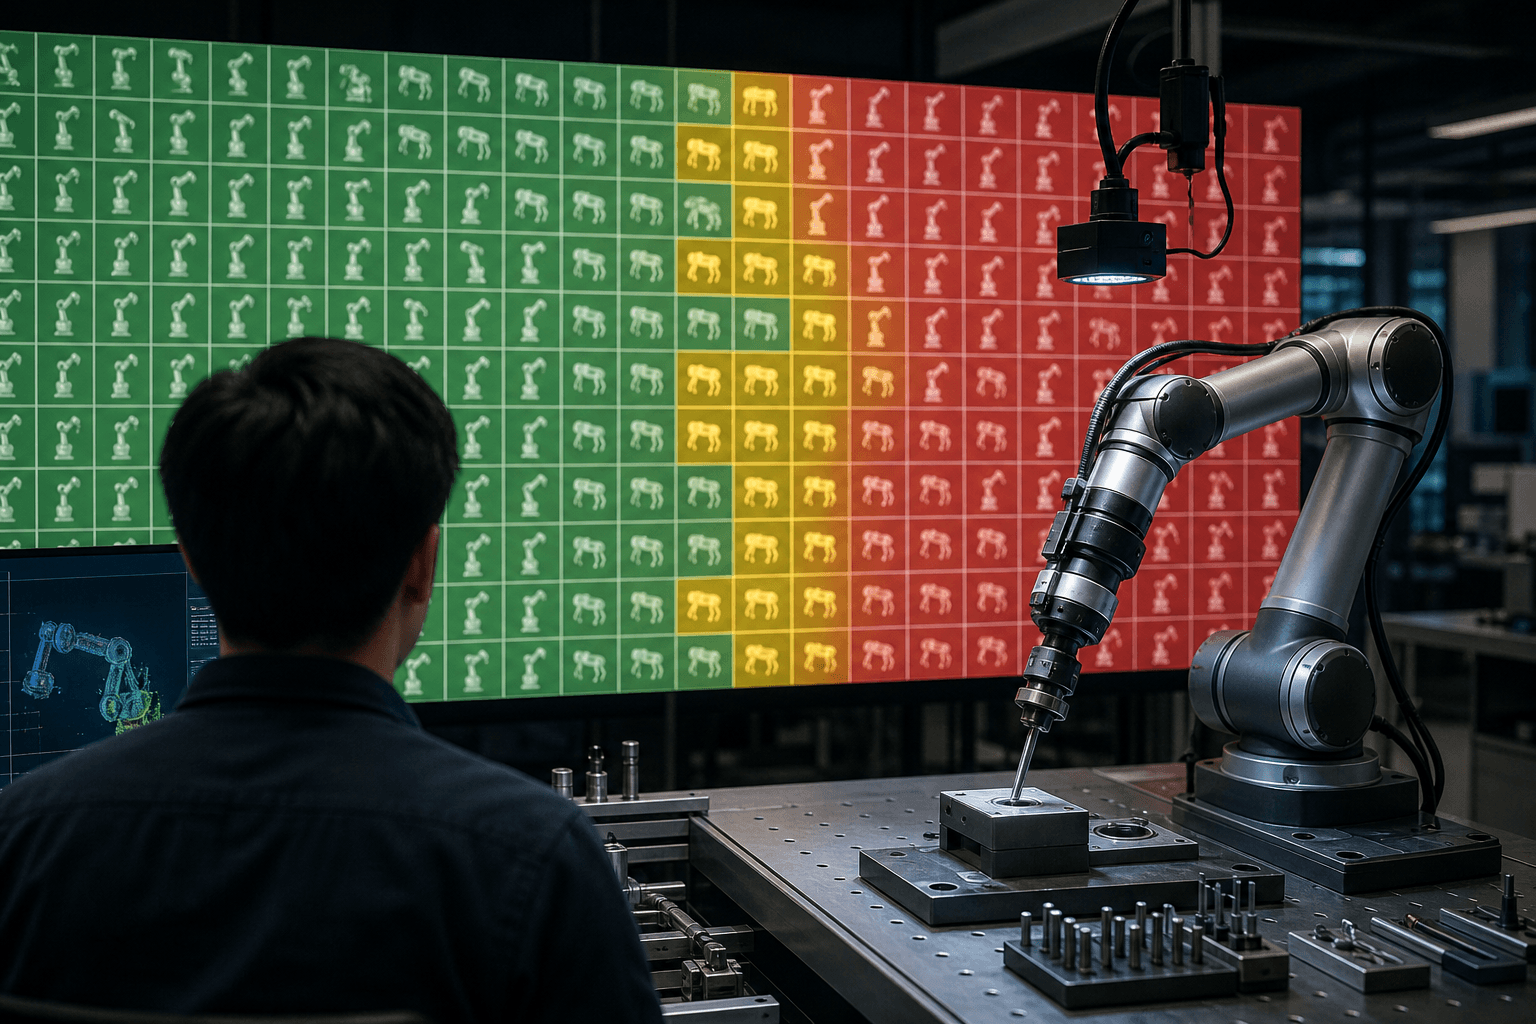
SGSは、この無駄を減らす適応型のサンプラーである。各課題設定について、方策がどの程度成功しているかを逐次記録する。常に成功する設定は「習得済み」、ほとんど成功しない設定は「未到達」とみなす。そのうえで、成功と失敗が混在する「境界」の設定を優先して、次のバッチで多く割り当てる。
教育に例えると分かりやすい。すでに満点を取れる問題を繰り返し解かせても、まったく歯が立たない問題を与え続けても、学習者は伸びない。少し頑張れば解ける問題に集中させるのが効率的である。SGSはこれをロボットの学習で自動的に行う。
強化学習では、成功と失敗の両方が含まれて初めて、行動の良し悪しを比較する手がかりが得られる。境界に経験を集めることで、バッチ内の学習信号の密度が上がり、並列環境の増加が性能向上へ結び付く。著者らは、この仕組みで報酬の作り込みやデモに頼らずに難しい課題を解けると位置付けている。
さらに、学習した組立の方策をRGBカメラ画像だけで動く方策へ蒸留し、実機で複数の難しい組立課題に追加学習なしで転移させる、いわゆるゼロショット転移も示した。
ビジネスへの示唆
最も恩恵を受けるのは、ロボットの動作開発を担う製造業の生産技術部門や設備開発部門である。たとえば、新製品の投入ごとに組立ロボットの動作を調整する業務は、熟練の技術者が報酬設計や教示データの作成に時間を割いていることが多い。SGSのような手法は、この調整工数を減らせる可能性がある。
自部署に置き換えるなら、次の問いが出発点となる。
- 自部署で、動作の教示や調整に最も手間がかかっている工程はどこか。
- その作業に、いま誰が、どれだけの時間をかけているか。
- 部品の位置ずれや形状違いなど、条件のばらつきで失敗する場面はどこか。
動く指標としては、新ライン立ち上げの期間、教示作業の人時、組立の成功率、段取り替え時間、不良率が挙げられる。物流倉庫のピッキングやアームによる仕分け、脚式ロボットによる設備点検といった、地形や配置が一定でない現場でも、条件のばらつきに強い方策を作る方向で役立つ可能性がある。
また、計算資源の使い方にも示唆がある。並列規模を増やすだけでは無駄が増えるため、学習データの「配分」を設計する発想が、開発コストの管理にも重要になる。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:ロボット作業のうち、条件のばらつきで失敗が多い、または教示に時間がかかる工程を洗い出す。目指す到達点は、効果が出やすい対象の優先順位を関係者が共有することである。
-
差し込み先の設計:すでにシミュレータや強化学習の基盤がある場合は、初期状態を選ぶ部分にサンプラーを差し替える形で組み込む。新しいツールを増やさず、既存の学習パイプラインの一部を置き換える現実解を優先する。目指す到達点は、既存資産を活かしたまま学習効率を高める構成である。
-
小さく試す(PoC):一つの工程、一つの部署で数週間、既存の方式と並べて試す。担当技術者が、報酬調整の手間や学習の安定性を実感として比較する。目指す到達点は、導入判断に足る手応えの確認である。
-
運用と横展開:成功率の計測方法や、境界の課題を見る基準を標準化し、他の工程や拠点へ広げる。目指す到達点は、新しい作業の立ち上げ時に、同じ手順で動作を作れる体制である。
全体として、熟練者の勘に頼る動作調整を、データ配分の仕組みで再現できる状態を目指す。
今後の展望
本研究は主に simulation 上の成果であり、実機への転移は組立課題で示された段階である。現実の工場では、センサーの誤差や摩耗など、シミュレータで再現しきれない要素が残る。そのため、実用化には現場データによる検証と安全面の確認が欠かせない。それでも、設計負荷を減らしつつ計算規模を成果につなげる道筋を示した点は、汎用ロボットの開発競争において意義が大きい。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
動画生成AI、手順を自ら判断し実行する新手法
研究チームが、初期画像と目標だけから次の行動を決めて動画化し、結果を見て完了まで進める世界モデル「WorldGuide」を発表した。手順書や研修動画の制作を変える可能性がある。
文脈で動作を止める安全フィルタが登場
米研究チームは、人型ロボットの動作生成AIに追加学習なしで後付けできる安全フィルタ「CSF」を発表した。状況次第で意味が変わる動作の危険を、自然言語の規則から抑える。
世界モデルDreamTrueが失敗映像を学び欠陥率を低減
ロボットの動作から未来の映像を予測する世界モデル「DreamTrue」が、人手評価の相互作用の欠陥率を48.12%から6.25%へ下げた。実機で試す前に映像で動作を検証できる可能性を示す。