分布のずれを一つの式で測り補正する新手法
密度比と変位場を単一の凸最適化で同時に推定する手法が提案された。分布のずれの大きさと動かし方を一度に得られ、学習済み生成モデルを再学習せず補正できる点が実務上重要である。
研究の概要
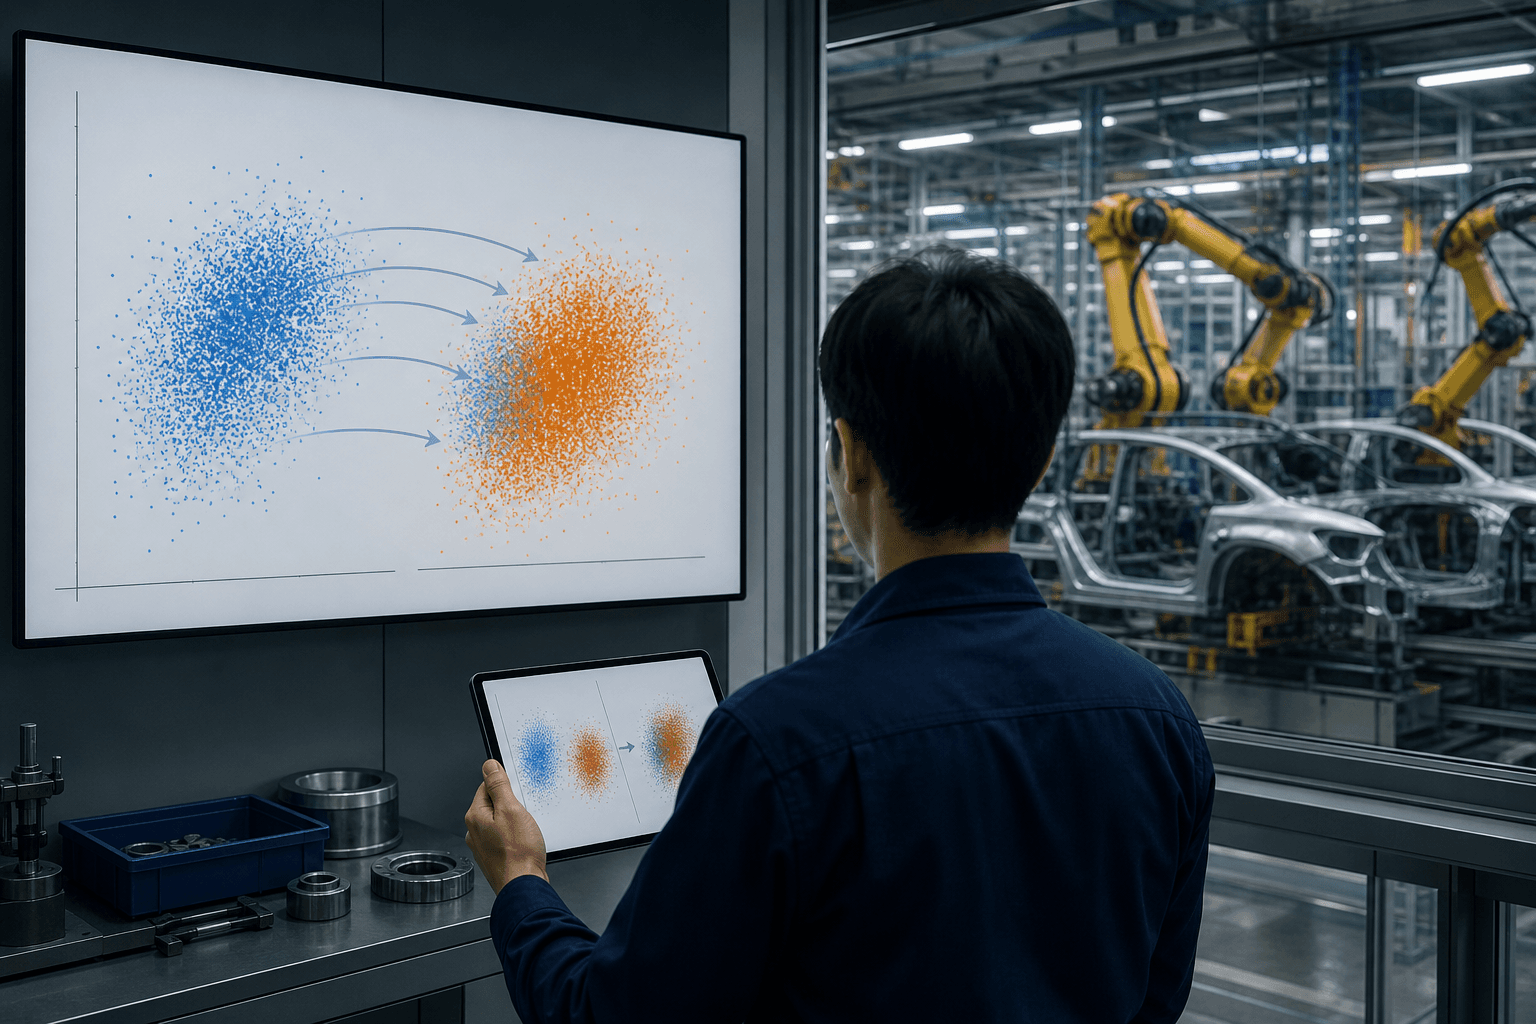
機械学習では、手元のデータの分布と、運用現場で出会うデータの分布が食い違う「分布シフト」が常に問題となる。これを捉える代表的な指標が密度比である。ある値がどちらの分布でどれだけ出現しやすいかの比であり、確率の質量という静的な視点でずれを表す。これに対し、一方の分布を他方へ「どう動かすか」を示す変位場は、動的な視点でずれを表す。両者は補完的であるが、従来は別々に推定され、一方から他方を得るには後処理が必要であった。
Song Liu氏の論文は、この二つを一つの枠組みに統合した。基準分布に対する目標分布の対数密度比を、基準分布のスタイン作用素を変位場に作用させたものの符号反転(正規化定数を除く)としてモデル化する。これにより、ずれの統計的記述と力学的記述が、単一の凸最適化問題から同時に得られる。
しくみをやさしく
スタイン作用素とは、ある分布の形(スコア、すなわち対数密度の勾配)を使い、任意の関数から「その分布の下での平均がゼロになる量」を作る道具である。本手法では、この作用素に「各地点をどちらへ動かすか」を表す矢印の場、つまり変位場を入力する。出てきた量の符号を反転したものを対数密度比とみなすのである。矢印の場さえ決まれば密度比も決まり、逆に密度比から矢印の向きも読み取れる。
最適化が凸であるため、局所解に陥る心配が小さく、結果の再現性を確保しやすい。さらに、推定した変位場に沿って分布を少し動かし、再び推定するという「推定と移動」の反復を行う。反復の方向は二通りある。プッシュフォワードは、モデル側を目標へ近づける方式で、学習済みのサンプラー(生成モデル)を再学習せずに補正できる。プルバックは、データ側を基準分布へ近づける方式で、変換モデルを一層ずつ当てはめていく。論文はシミュレーションベース推論における分布シフトと、非線形独立成分分析への応用を示し、利点と限界の双方を報告している。
ビジネスへの示唆
本手法が効くのは、「いま使っているモデルが現場データとずれてきたとき、どう直すか」という業務である。たとえば製造業の品質管理部門では、設備更新や原料ロット変更のたびに、不良検知モデルの前提がずれる。シミュレーションで作った疑似データと実機データの差を埋める工程も、開発部門が日常的に抱える課題である。金融のリスク管理部門でも、市場環境の変化でシナリオ生成モデルの分布が実態から離れる場面がある。
読者に問いたいのは、自部署で「過去データで作ったモデルや擬似データを、新しい状況に合わせて作り直している業務」は何か、その作り直しに誰がどれだけ手をかけているか、である。本手法は再学習を伴わずに生成側を補正できるため、再学習の工数、モデル更新までのリードタイム、予測精度の劣化頻度といったKPIの改善につながる可能性がある。
- 製造(品質管理・生産技術):不良検知の誤検知率、モデル再調整の工数
- 金融(リスク管理):シナリオ生成の実態乖離、モデル検証の負荷
- 研究開発(シミュレーション部門):実測との乖離の把握と補正に要する期間
なお、効果の大きさは論文では限定的な応用例で示されたにとどまり、自社データでの有効性は検証が必要である。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:シミュレーションや生成モデルの出力と実データがずれて、手直しや再学習が発生している業務を洗い出す。誰が、どの頻度で、何を直しているかを可視化する。目指す到達点は、「ずれ」が業務のどこで損失を生んでいるかを部署内で共有できる状態である。
-
差し込み先の設計:新しいツールを増やさず、既存の生成モデルやシミュレータの出力の後段に補正層として置く。プッシュフォワード方式は元のサンプラーを変更しないため、現行の運用フローを崩しにくい。目指す到達点は、既存システムに最小限の接続点を足すだけで補正が回る構成である。
-
小さく試す(PoC):一つの部署、一つのモデルに絞り、数週間で試す。補正前後の出力を現場担当者が見比べ、「実データに近づいた」という実感を確かめる。凸最適化であるため、設定による結果のぶれが小さく、小さく・安く始めやすい。目指す到達点は、担当者が補正の妥当性を自分の言葉で説明できることである。
-
運用と横展開:ずれの大きさを示す密度比を、モデル更新の要否を判断する共通基準として整える。その後、近い課題を持つ他部署へ広げる。目指す到達点は、ずれの検知と補正が定常業務に組み込まれた状態である。
全体として目指すのは、分布のずれを「起きてから作り直す」対応から、「測って動かして補正する」運用へ転換した状態である。
今後の展望
論文自体が限界を認めているとおり、高次元データや複雑な分布での適用範囲は今後の検証課題である。一方、ずれの量と動かし方を一体で扱える点は、生成AIの運用保守やデジタルツインの精度維持といった領域で価値を持ちうる。実務側では、まず自社のずれが起きやすい工程を特定し、小規模な検証から着手することが現実的である。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
4ビットAdamW、丸め方の再設計で精度差縮小
AdamWの最適化状態を4ビットで保持する際の丸め方を見直した新手法ZIP-SRとZE-EDENが提案された。メモリ削減と学習精度の両立を狙え、LLM自社学習の費用負担を下げる可能性がある。
AIの内部信号で妨害と虚偽を検知
LLMの内部状態を読み取る「プローブ」が、AIエージェントの妨害行為を98.8%のAUCで検出し、テキスト監視を上回った。発話に表れない欺瞞も捉え、AI監査の新たな基盤となる可能性がある。
動画AIの弱点を測る新指標OmniCapBenchが登場
音声と映像を同時に理解するAIの能力を、原子的な評価単位で精密に診断する新ベンチマークが公表された。人物の取り違えや音と映像のずれなど、実務で致命傷となる誤りの特定に道を開く。