カメラ構成を問わぬロボ制御AIを開発
カメラの台数や位置が変わっても動作するロボット操作AI「VersaCamVLA」が提案された。現場ごとの再学習を減らせる可能性があり、導入コストの抑制に資する。
研究の概要
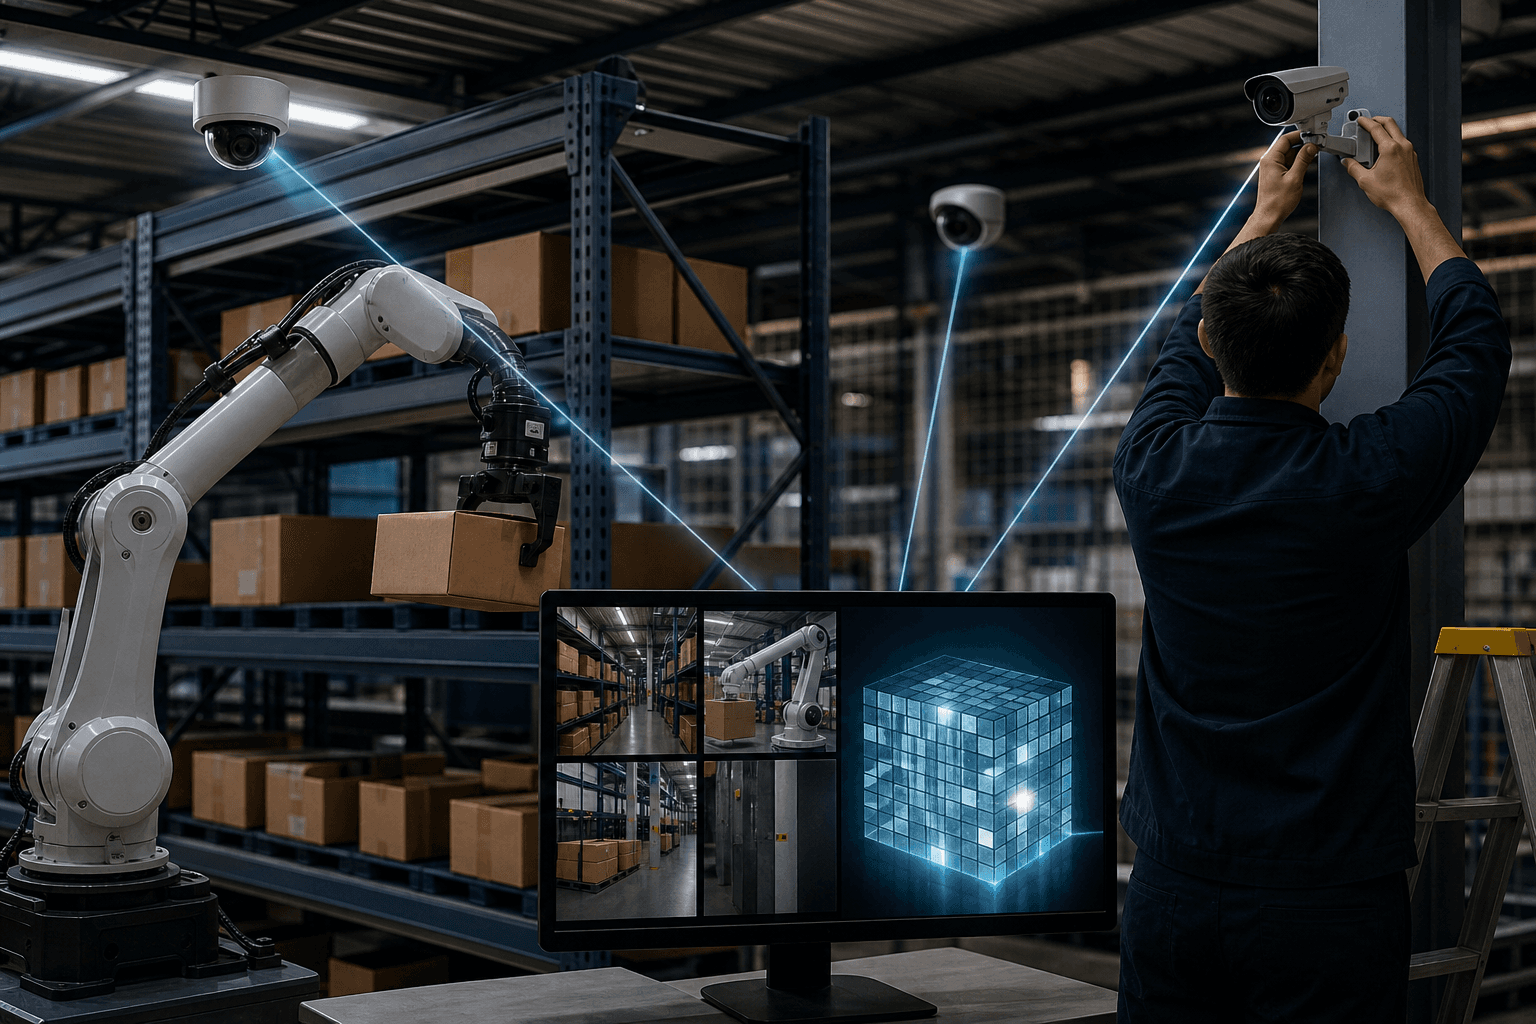
ロボットに言葉で指示し、カメラ映像から動作を生成させる視覚言語行動モデル(VLA)は、ロボット操作の基盤技術として注目を集めている。しかし多くのモデルは、学習時と同じカメラ構成、すなわち同じ台数と同じ設置位置を前提としている。導入先でカメラを増減したり、取り付け位置を変えたりすると、性能が大きく落ちやすいという弱点があった。
Boyao Han氏らの研究チームは、この課題に対しVersaCamVLAを提案した。カメラ構成の扱いと動作の学習を切り離す設計が特徴である。台数も位置も異なる複数のカメラ映像を、固定サイズの「シーントークン」と呼ぶ情報の束に変換する共通の入り口を学習する。動作の生成は既存の事前学習済みVLAが担う。
評価はシミュレーション基盤のRoboTwinとLIBERO、および実機ロボットで行われた。結果として、従来のVLA手法や、単純に複数映像を連結する直接マルチビュー方式を一貫して上回った。カメラ台数が変わる場合や、学習時に見ていないカメラ位置でも、性能が安定して保たれたと報告されている。
しくみをやさしく
中核は、位置情報付きのRGB画像を何枚でも受け取り、常に同じ大きさの「場面の要約」に畳み込む仕組みである。会議の議事録に例えると、参加者が3人でも5人でも、最終的に同じ書式の1枚にまとめるようなものだ。後段のAIは書式が一定なので、入力の枚数や出所を気にせずに済む。
この要約器の学習には、複数信号による目標視点の予測が使われる。ある視点群の映像から、別の視点で見える像などを当てさせることで、物体の配置や奥行きといった空間構造を要約に織り込ませる。実際の運用時に新しい視点の画像を描き起こしたり、3Dセンサーで計測したりする必要はない。
もう一つの工夫が手首カメラ拡張姿勢サンプリング(WAPS)である。ロボットの手首に付いたカメラは、作業中にアームとともに動くため、自然と多様な位置から撮影した映像が得られる。これを追加の撮影作業なしに視点の多様性として活用し、未知のカメラ位置への対応力を高める。
運用時には、軽量な空間エンコーダがこの要約を、既存のVLAに補助的な視覚条件として差し込む。基盤モデルを作り直さず、後付けで拡張できる点が実務上の利点である。
ビジネスへの示唆
恩恵が大きいのは、ロボットの設置環境が拠点ごとに異なる業務である。例えば物流倉庫のピッキング工程では、棚の配置や天井の高さにより、カメラの取り付け位置を拠点ごとに変えざるを得ない。製造業の組立・検査ラインでも、段取り替えのたびにカメラを動かす場面は多い。
自部署に当てはめるなら、次の問いが出発点となる。
- ロボットやカメラの据え付け・調整に、いま誰がどれだけ時間を割いているか
- 拠点追加やライン変更のたびに、動作の再学習や再調整が発生していないか
- カメラが故障・汚れで1台使えなくなった際、ラインはどう止まるか
影響を受ける部署は、生産技術部門、物流現場の設備担当、ロボットSIerの導入チームである。動くKPIとしては、立ち上げリードタイム、再教示・再学習の工数、カメラ故障時のライン停止時間、設備の稼働率が挙げられる。カメラ構成に縛られないことで、カメラ位置の精密な固定や、拠点別の追加データ収集といった負担を減らせる可能性がある。
現場での導入イメージ
仮に導入支援に入るなら、次の4段階で進めることになる。
-
棚卸し:ロボット作業のうち、カメラ構成の違いが原因で調整や再学習が発生している工程を洗い出す。拠点別のカメラ台数、位置、調整にかかる人手を一覧にする。到達点は、構成差によるロスが大きい工程を特定し、優先順位を共有できる状態である。
-
差し込み先の設計:新規にロボット基盤を入れ替えるのではなく、既に使っているVLAや制御系に、軽量な空間エンコーダを補助入力として足す形を検討する。既存のカメラ設備をそのまま活用する。到達点は、現行システムを大きく変えずに試せる構成を決めることである。
-
小さく試す(PoC):1つの拠点または1ラインに絞り、数週間でカメラ位置を変える、台数を減らすといった状況を意図的に作る。現場担当者が、調整の手間や成功率の安定感を実感として確かめる。到達点は、効果と限界を現場の言葉で説明できる状態である。
-
運用と横展開:カメラの設置許容範囲や、性能が落ちる条件の基準書を整え、他拠点へ展開する。到達点は、新拠点でカメラ設置の自由度が上がり、立ち上げの手順が標準化されることである。
全体として目指すのは、「カメラ構成が違っても、同じロボットAIを使い回せる現場」である。
今後の展望
本研究はシミュレーションと実機での検証にとどまり、実際の工場や倉庫で想定される照明変化、遮蔽物、長期稼働下での安定性は今後の課題である。また、位置情報付きの画像を前提とするため、カメラ位置の把握方法も運用上の論点となる。それでも、ロボットAIを現場ごとに作り込む時代から、構成差を吸収して使い回す時代へ移る方向性を示した点で意義は大きい。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
外部映像から一人称視点を深度なしで生成
外部カメラの映像から作業者の一人称視点を生成する新手法LEGOが登場した。深度推定や点群化を省き、構造を担う変換器と細部を担う拡散モデルを分担させ、従来法を上回る精度を示した。
分岐現象を生成AIが一括予測、設計探索に道
独Bi-FORKは、座屈など一つの入力から複数の解が生じる分岐現象を、生成モデルで一度に復元する。最大26万点の高次元系にも対応し、シミュレーション代替の適用範囲を広げる。
画像AI、1ブロック反復で精度維持し軽量化
単一のTransformerブロックを繰り返し使う画像認識モデル「reViT」が、全層モデルと同等の精度を保ちつつ保存パラメータを約70%減らした。端末搭載や配布のコストを下げる道を開く成果である。