動画AIの弱点を測る新指標OmniCapBenchが登場
音声と映像を同時に理解するAIの能力を、原子的な評価単位で精密に診断する新ベンチマークが公表された。人物の取り違えや音と映像のずれなど、実務で致命傷となる誤りの特定に道を開く。
研究の概要
音声と映像を一体で扱うマルチモーダル大規模言語モデル(MLLM)の進化は速い。一方で、その実力を正しく測る物差しは追いついていない。Zhongyu Yang氏らの研究チームは、音声付き動画の説明文(キャプション)を診断的に評価するOmniCapBenchを発表した。
従来の評価には三つの課題があった。説明文全体に点数を付ける方式は広く網羅できるが、どこで誤ったかが分からない。部分的な問いで確かめる方式は誤りの場所を特定できるが、動画全体を網羅できない。さらに、評価をLLMに任せきりにすると採点が安定しない。この三者は互いに両立しにくいトレードオフの関係にあった。
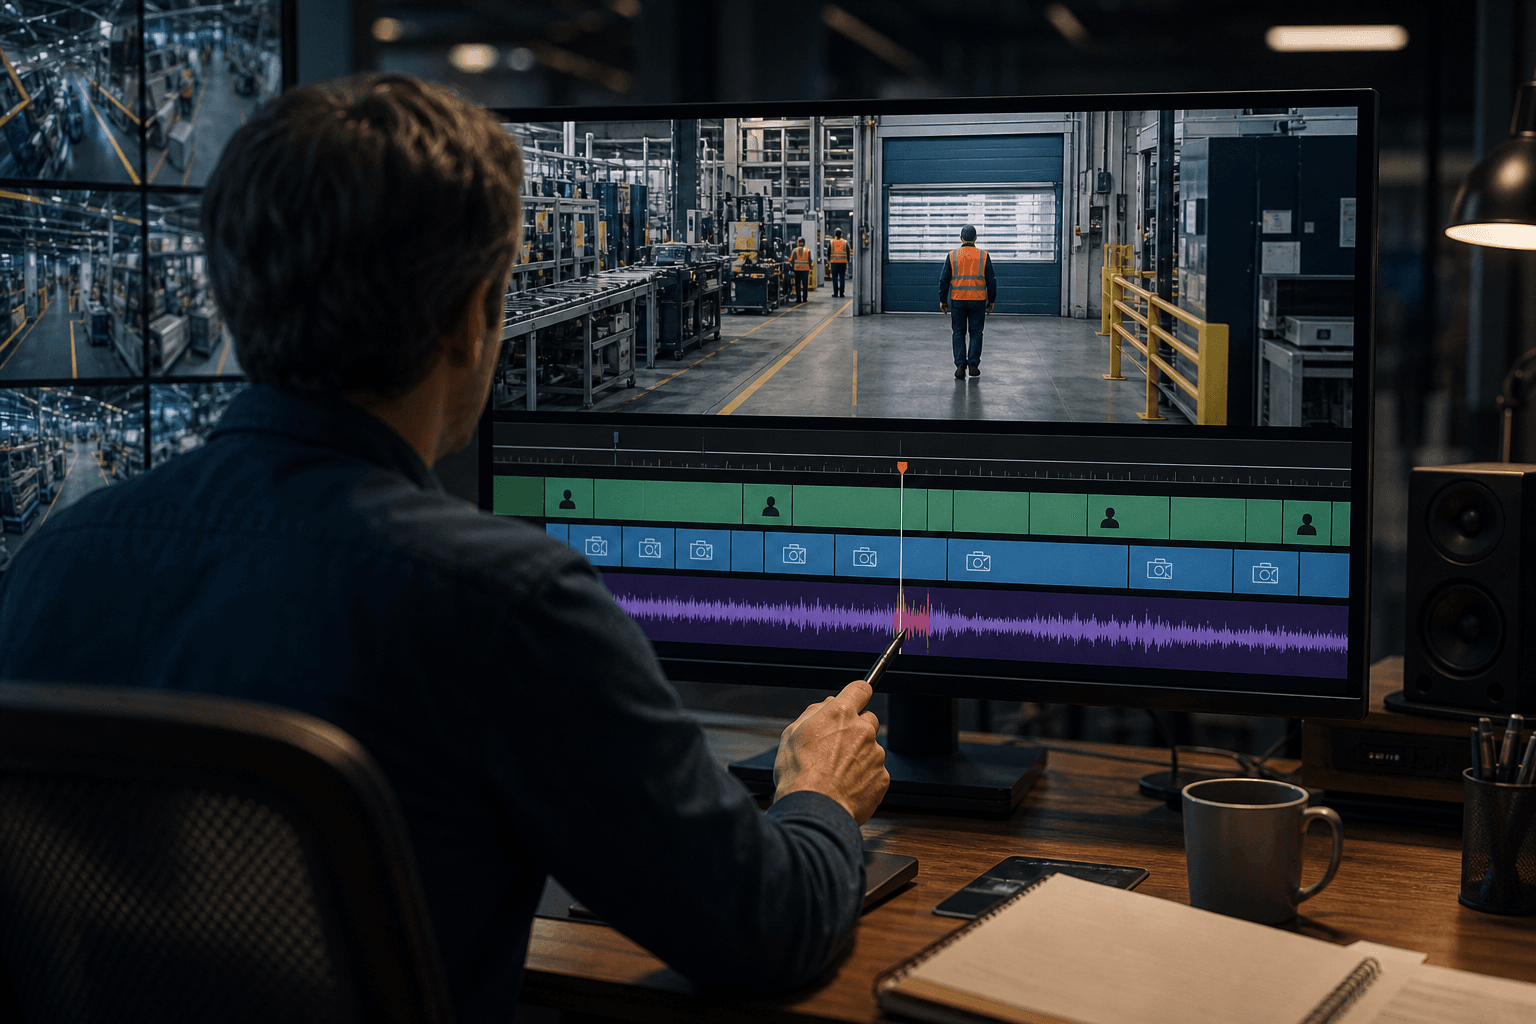
本研究は評価対象を自由な文章から、検証可能な「原子的な評価単位」の集合へと置き換えた。単位は登場対象の参照(エンティティ)、映像のショット、音声イベントの三つのトラックに分かれる。786本の動画に密な注釈を付け、最先端のMLLMを評価した。結果、個々の場面を捉える局所的な知覚は強い一方、長い時間にわたる音声と映像の統合的な推論は弱いことが示された。特に、同一人物が途中で別人として扱われるアイデンティティ・ドリフトと、音と映像の対応が崩れるクロスモーダルの不整合で弱点が目立った。
しくみをやさしく
従来の採点は、AIが書いた説明文を丸ごと審判役のLLMに読ませ、「良い出来か」を判断させる方式が主流であった。これは、答案全体を見て感覚で点を付ける採点に近く、採点者の気分で結果が揺れやすい。
OmniCapBenchは、これを小問に分解した答案の採点へと変える。たとえば「0秒から5秒に赤い服の女性が登場する」「3秒時点でドアが閉まる音がする」といった、正誤を確かめられる最小の事実を単位とする。時刻や登場順といった形式的な条件は、プログラムによる決定論的な制約チェックで機械的に判定する。意味の一致を見る必要がある部分だけ、LLMが局所的に比較する。審判の裁量が及ぶ範囲を狭めることで、採点の安定性を確保する仕掛けである。
この構造により、誤りの種類を切り分けられる。時間の位置を誤る「時間的接地の失敗」、人物が入れ替わる「アイデンティティ・ドリフト」、音と映像の対応ずれ、存在しないものを述べる「幻覚」が、それぞれ別の項目として現れる。
ビジネスへの示唆
動画を要約・記録するAIは、すでに多くの職場で候補に挙がっている。自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを、まず問い直したい。
- コールセンター・カスタマーサポート部門:通話や画面録画の要約。対応品質のチェック工数、応対記録の正確性が指標となる。
- 製造業の品質保証・安全管理部門:作業動画や異音を含む設備映像の確認。見逃し率や点検の確認時間が動く。
- メディア・広報・マーケティング部門:動画素材の整理、字幕や説明文の作成。素材検索の所要時間や制作リードタイムが関わる。
- 小売・警備の監視業務:映像と音を突き合わせた状況記録。誤報や確認負荷が指標となる。
本研究が示す弱点は、実務の痛点と重なる。長い会議録画で発言者が途中から別人として記録される、現場映像で「異音がした」時刻がずれる、といった誤りは、記録の信頼性を直接損なう。AIの総合点だけを見て導入を決めれば、こうした弱点を見落としかねない。自社の動画で何が起きれば困るのかを先に定義し、その誤りの種類ごとに製品を比較する視点が重要になる。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。なお、本論文は評価の枠組みを示すものであり、社内導入の効果を数値で保証するものではない。
-
棚卸し:動画や音声を人が見聞きして記録している業務を洗い出し、どこで時間がかかり、どの誤りが痛いかを可視化する。目指す到達点は、「人物の取り違え」「音と映像のずれ」など、自社で許容できない誤りの種類が言語化された状態である。
-
差し込み先の設計:新しいツールを増やさず、既存の録画管理、議事録、ナレッジ検索(RAG)の流れにAIの要約を載せる位置を決める。あわせて、OmniCapBenchの考え方を借り、自社動画から「いつ、誰が、どんな音がしたか」という確認可能な小さな事実のチェックリストを作る。目指す到達点は、AIの出力を人が最小限の手間で検証できる設計である。
-
小さく試す(PoC):一部署、数週間の範囲で、数十本程度の実動画を対象に試す。担当者が「どの種類の誤りが、どの場面で出るか」を実感として確かめる。小さく安く始められる点が利点である。目指す到達点は、採用する製品・設定と、人の確認を残すべき工程の見極めである。
-
運用と横展開:誤りの種類ごとの合格基準と、人による確認の条件を定め、他部署へ広げる。モデル更新のたびに同じチェックリストで再評価する。目指す到達点は、モデルが変わっても品質を一定に保てる評価の仕組みの定着である。
全体として目指すのは、AIの要約を「なんとなく使う」状態から、誤りの性質を理解したうえで任せる範囲を決める状態への移行である。
今後の展望
研究チームは、本ベンチマークを全方位型(オムニモーダル)モデル開発の「きめ細かな道筋」と位置づける。長時間の音声・映像推論が弱点と分かったことで、開発側の改良点も明確になった。利用企業にとっては、ベンダーに対し総合点ではなく誤りの種類別の性能を問う交渉材料となる。評価の物差しが整うほど、動画AIの業務適用は現実味を増すと見られる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
分布のずれを一つの式で測り補正する新手法
密度比と変位場を単一の凸最適化で同時に推定する手法が提案された。分布のずれの大きさと動かし方を一度に得られ、学習済み生成モデルを再学習せず補正できる点が実務上重要である。
4ビットAdamW、丸め方の再設計で精度差縮小
AdamWの最適化状態を4ビットで保持する際の丸め方を見直した新手法ZIP-SRとZE-EDENが提案された。メモリ削減と学習精度の両立を狙え、LLM自社学習の費用負担を下げる可能性がある。
AIの内部信号で妨害と虚偽を検知
LLMの内部状態を読み取る「プローブ」が、AIエージェントの妨害行為を98.8%のAUCで検出し、テキスト監視を上回った。発話に表れない欺瞞も捉え、AI監査の新たな基盤となる可能性がある。