1本の動画で多指ロボ手が器用な作業を習得
動画1本から多指ロボットハンドの操作方針を学ぶ枠組み「Dex-One2Many」が登場した。映像を場面グラフに抽象化して強化学習を導き、未知の配置でも既存手法を71%上回った。
研究の概要
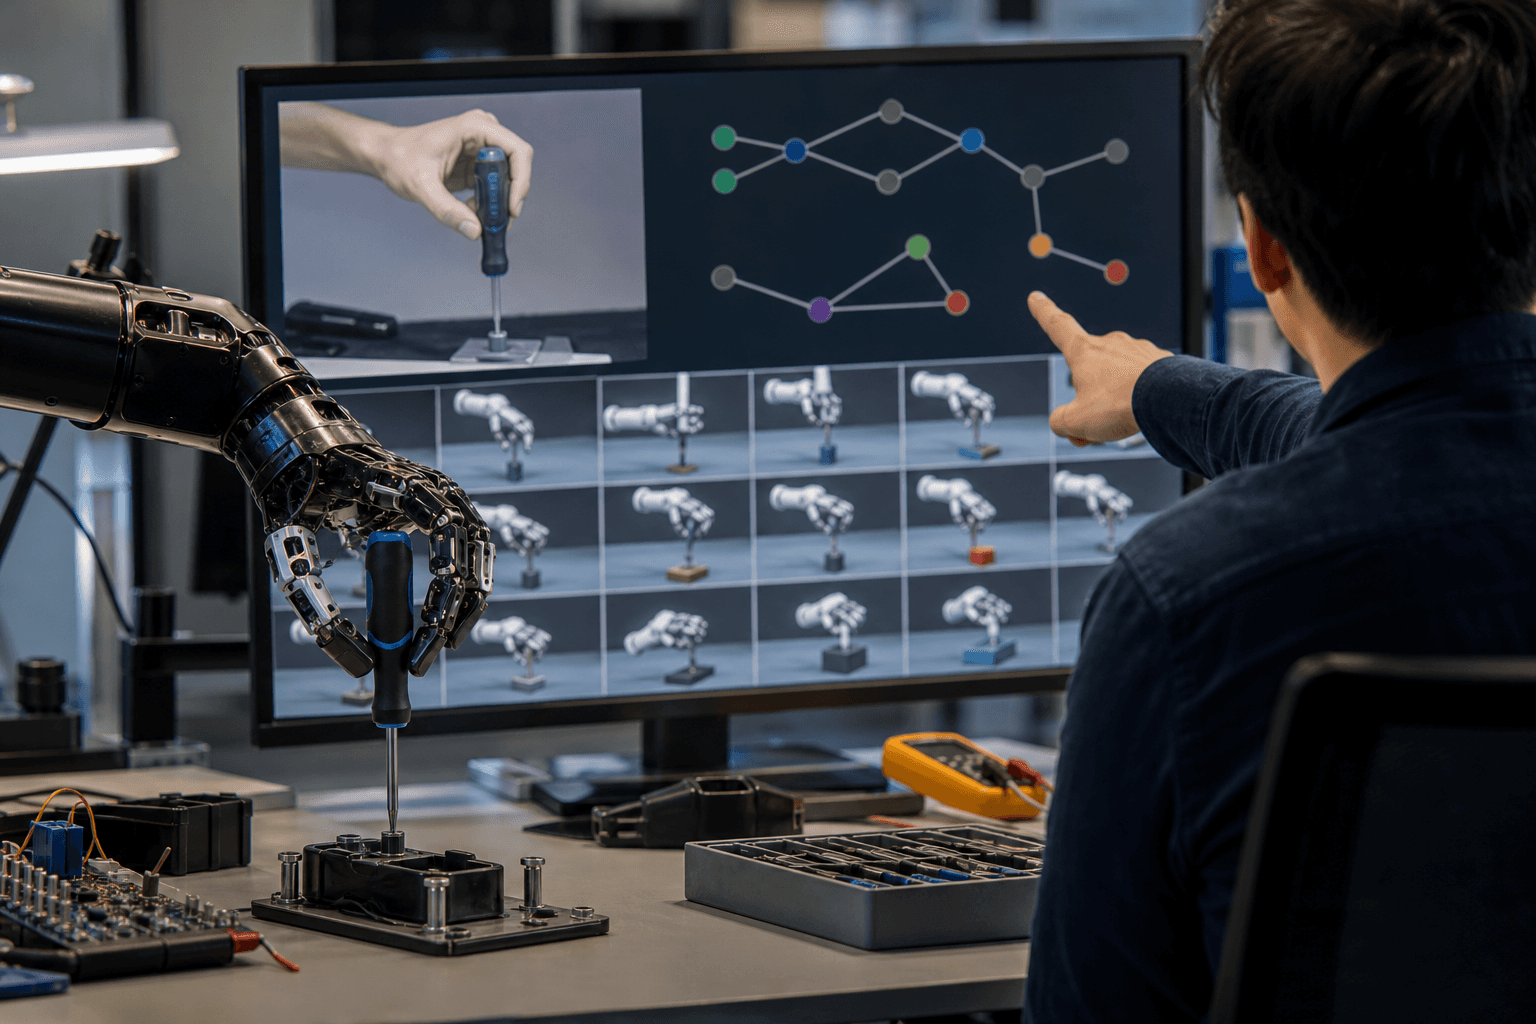
人間の作業動画を1本見せるだけで、ロボットハンドに道具の扱いなどの器用な操作を覚えさせる手法「Dex-One2Many」が発表された。韓国などの研究者らによる成果であり、arXivに論文が公開されている。
従来、動画から学ぶ手法の多くは、映像に映った手の動きをそのままなぞる模倣が中心であった。しかし動きを厳密に再現しようとすると、動画に映っていない物体の初期位置、目標位置、握り方には対応しにくい。一方、強化学習(試行錯誤で方針を獲得する手法)を単独で使えば幅広い状況に対応できる可能性があるが、指の関節が多く、複数段階からなる作業では探索の範囲が膨大になり、学習が進みにくいという弱点がある。
本研究は、この「汎化」と「探索」の二つの課題を同時に解くことを狙った。5種類の道具使用・操作タスクで評価した結果、動画に近い設定では比較手法を6.5%上回り、未知の設定では差が71%に広がった。学習はすべてシミュレーション内で行い、追加調整なしに実機の多指ハンドへ移す「ゼロショット転移」も確認されている。
しくみをやさしく
鍵となるのは、動画を「場面グラフ」の連なりに置き換える点である。場面グラフとは、「ハンドが物体を持つ」「物体が別の物体の上に載る」といった、物と物との関係を記述した図である。動画の作業を段階ごとに区切り、各段階をこの関係図として表現する。
このグラフは二つの役割を担う。第一に、シミュレーション上で学習を始める「リセット状態」を生成する制約として働く。グラフは正確な座標ではなく関係だけを規定するため、その条件を満たす範囲で物体の位置や握り方を多様に変えた開始状態を大量に作れる。動画に映っていない配置や握りも、自然に学習へ取り込まれる。
第二に、各段階の達成度を測る密な報酬を与える。「関係が目標のグラフにどれだけ近づいたか」を細かく採点できるため、成功か失敗かの二択に頼らずに済む。さらに各段階をその段階専用のリセット状態から始めるので、1回の試行で探る範囲が短くなる。長い作業を最初から最後まで通して探索する必要がなく、強化学習の弱点が緩和される。
ビジネスへの示唆
この技術は、人の手作業の動画を教材にロボットを立ち上げる場面で効果が見込まれる。例えば電機・精密機器の組立現場では、ねじ締めや工具の持ち替え、コネクタ挿入といった作業がある。現在は熟練者の動きをロボット技術者がティーチング(動作の手動登録)しており、品種が変わるたびに手間が生じる。自部署で該当する作業は何か、いま誰がどれだけ時間をかけて動作を教えているかを点検する価値がある。
物流倉庫のピッキング部門では、形状や置き方が毎回異なる品物の取り扱いが課題である。外食・食品加工の調理工程や、医療・介護の器具準備のように、道具を使う作業にも応用余地がある。
動く指標として次が挙げられる。
- 生産技術部門:新作業の立ち上げ工数、段取り替え時間
- 製造ライン:ロボットの作業成功率、停止・やり直し回数
- 物流:未知の品物への対応率、人手による補助の頻度
- 人材・教育部門:熟練者の技能を記録・継承する負荷
特に、動画に映らない配置への対応力が高い点は、多品種少量の現場で価値を持つ。ただし論文の評価は5タスクにとどまり、現場の複雑な条件でどこまで通用するかは個別の検証が要る。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:道具や物体を扱う手作業のうち、教示に時間がかかる、品種ごとに作り直している、熟練者に依存している工程を洗い出す。目指す到達点は、効果が出やすい候補工程の優先順位が、担当者の納得のもとに共有されている状態である。
-
差し込み先の設計:新しいロボットを増やすのではなく、既存の多指ハンドやロボットアーム、現在使っているシミュレーション環境や作業動画の保管場所に載せる方法を考える。まず作業を段階に分け、各段階で物がどういう関係になれば成功かを言葉で定義する。目指す到達点は、現場の作業手順書と、ロボットの学習目標が同じ言葉でつながる状態である。
-
小さく試す(PoC):一部署・一工程に絞り、数週間規模で、熟練者の動画1本から方針を学習させる。動画にない配置で試し、担当者が「使える」と実感できるかを確かめる。目指す到達点は、少ない準備で動画から動く見通しが現場の実感として得られ、失敗パターンも把握できている状態である。
-
運用と横展開:動画の撮り方、段階の切り分け、合否の基準を標準化し、他の工程や部署へ広げる。シミュレーションと実機のずれを点検する手順も整える。目指す到達点は、新しい作業を動画で依頼すれば、現場主導でロボットが立ち上がる運用である。
全体として目指すのは、熟練者の動画が、そのままロボット立ち上げの出発点となる体制である。
今後の展望
場面グラフの作成を自動化できれば、動画の準備負担はさらに下がる可能性がある。一方、力加減が重要な作業や、柔らかい物体の扱いなど、関係の記述だけでは捉えにくい作業への拡張が課題となる。ハンド機構の違いへの適応も含め、実用化には工程ごとの検証の積み重ねが欠かせない。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
動画生成AI、手順を自ら判断し実行する新手法
研究チームが、初期画像と目標だけから次の行動を決めて動画化し、結果を見て完了まで進める世界モデル「WorldGuide」を発表した。手順書や研修動画の制作を変える可能性がある。
ロボット学習、成功境界に絞り効率化
米研究チームは、ロボットの強化学習で習熟度の「境界」にある課題へ学習を集中させる手法SGSを開発した。100万超の並列環境でも効果が出て、組立や脚式移動の自動化に道を開く。
文脈で動作を止める安全フィルタが登場
米研究チームは、人型ロボットの動作生成AIに追加学習なしで後付けできる安全フィルタ「CSF」を発表した。状況次第で意味が変わる動作の危険を、自然言語の規則から抑える。