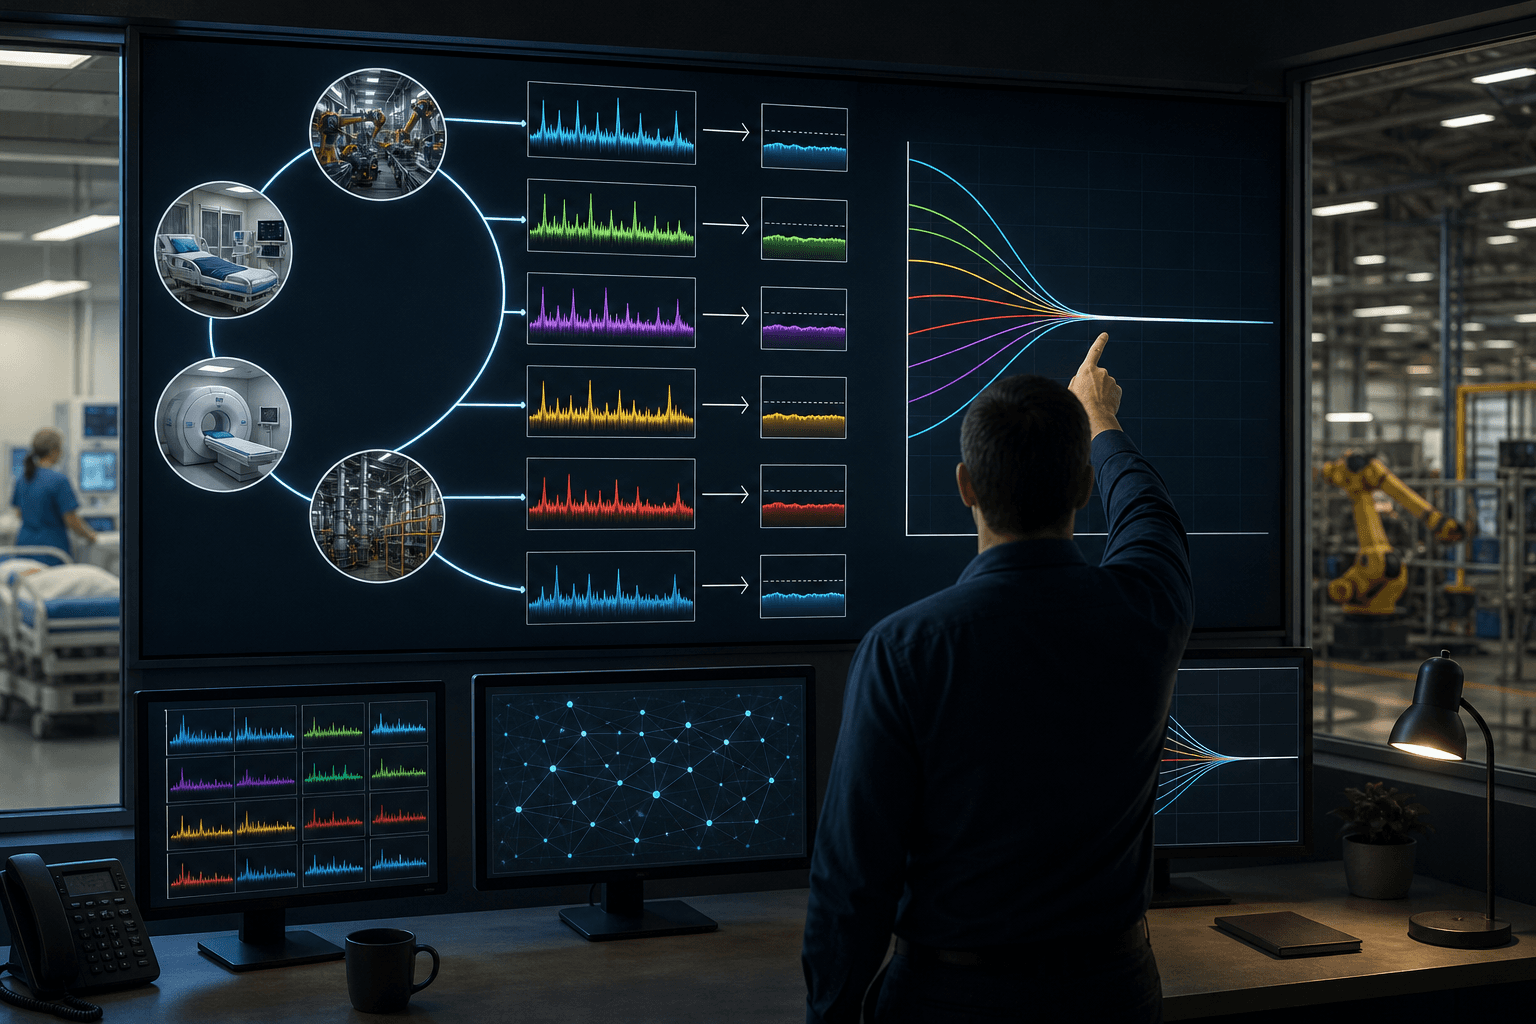
AI時間指標、2〜30分で難度平坦と判明
AIの能力を人間の作業時間で表すMETRの指標を統計的に再検証した結果、2〜30分の領域で難しさがほぼ平坦と判明した。同じ10倍でも意味が異なり、数字の読み方に注意を要する。
研究の概要
米国の評価機関METRが提唱する「50%タイムホライズン」は、AIが50%の確率で解けるソフトウェア課題について、人間が要する所要時間で能力を表す指標である。AIの進歩を「人間の何分、何時間分の仕事をこなせるか」という直感的な単位で語れるため、広く引用されている。
ドリュー・グエン氏とウィリアム・フィジアン氏は、228課題と26のAIを対象にこの指標を統計的に再推定した。従来の手法は、課題のAIにとっての難しさが、人間の所要時間の対数に比例して直線的に増えると仮定していた。両氏はスプラインと項目反応理論を使い、この仮定を外した。
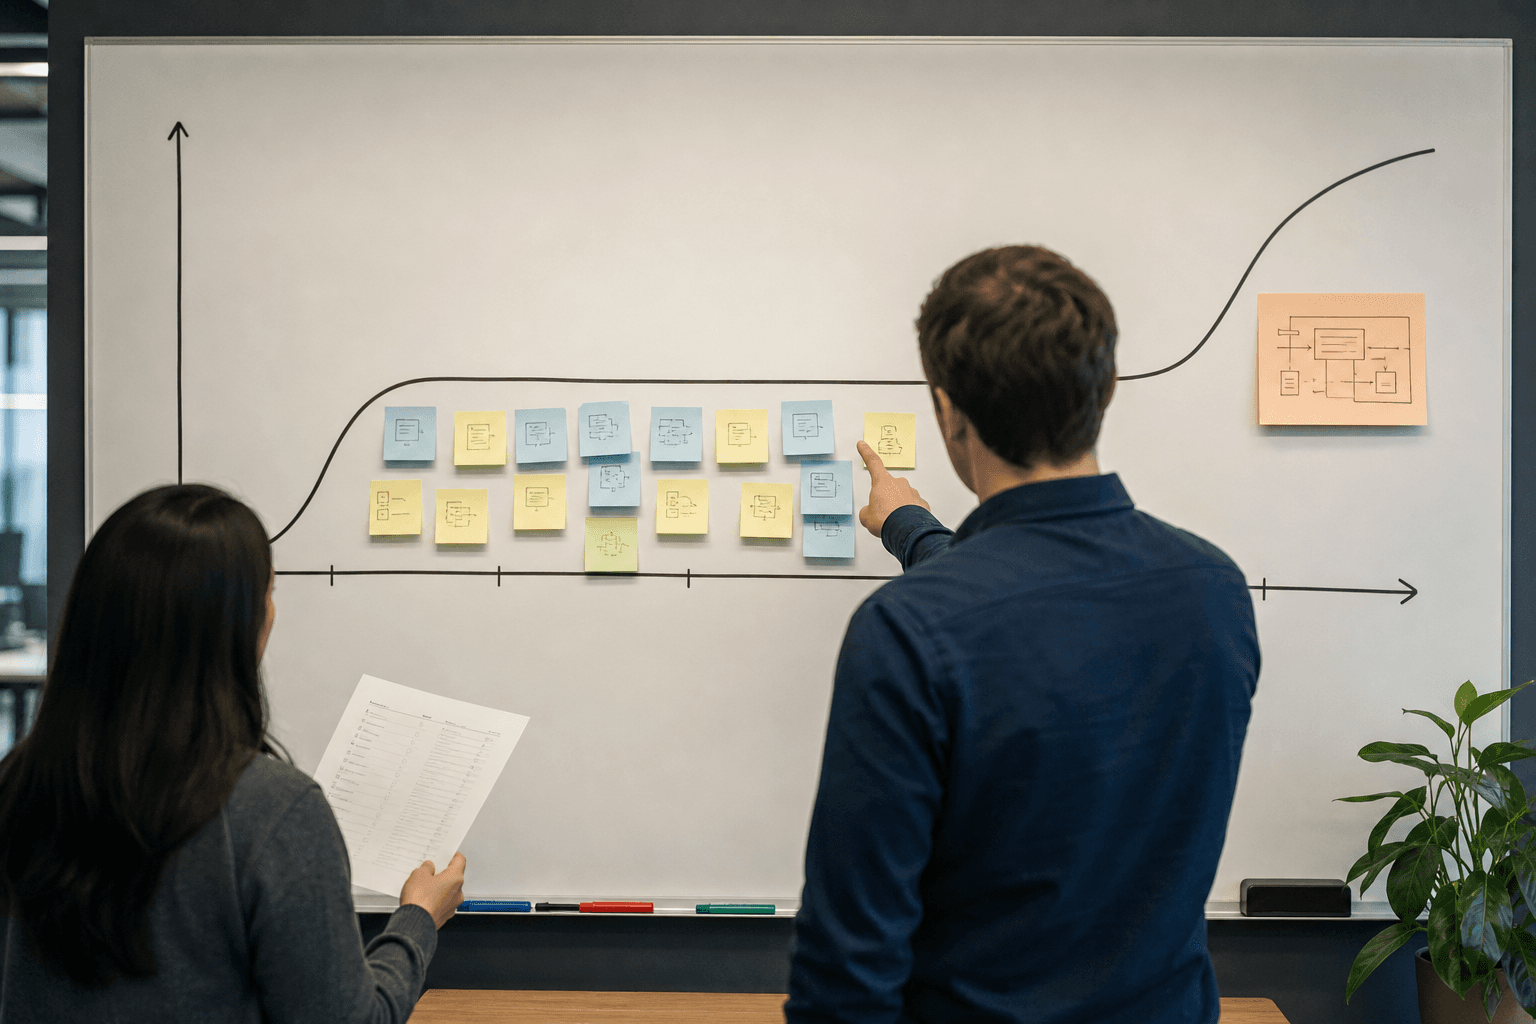
結果として、人間の所要時間をAIにとっての難しさへ換算する関数は、2〜30分の領域でほぼ平坦であり、それ以外ではほぼ直線であった。したがって3分から30分への伸びは、同じ10倍でも、30分から5時間への伸びよりはるかに容易である。新しい推定値は、交差検証した複数の適切なスコアリングルールで従来より良い成績を示した。論文は指標の妥当性を点検する診断プロットも提示し、指標はこの図と併せて読むよう勧めている。
しくみをやさしく
項目反応理論は、資格試験などで使われる統計手法である。受験者の「能力」と問題の「難しさ」を同時に推定し、正答確率を両者の差で表す。ここでは受験者がAI、問題がソフトウェア課題にあたる。
従来の指標は、難しさを「人間の所要時間の対数」の一次式と置いていた。所要時間が10倍になるたびに、難しさが一定量ずつ上がる想定である。本研究は、この一次式を自由に曲がれるスプライン曲線に置き換え、曲線の形をデータに決めさせた。
得られた曲線は、2〜30分の区間でほぼ水平だった。これは、人間にとって2分の作業と30分の作業が、AIにはほぼ同じ難しさに映ることを意味する。目盛りが均等だと思っていた物差しが、中間域だけ詰まっていた状況に近い。その外側の短い課題と長い課題では、時間が延びるほど難しさも着実に増す。タイムホライズンはこの換算を通じて決まるため、換算が歪んでいれば、時間の単位で表した能力の伸びも見かけが変わる。
ビジネスへの示唆
最も影響を受けるのは、AIの調達や活用方針を決める経営企画と情報システム部門、そして実際に使うソフトウェア開発部門である。「このAIは30分の作業をこなせる」という説明は、30分の課題の多くを任せられる保証にならない。2〜30分の領域は難しさが平坦なため、その範囲では1分や2分の違いが成否をほとんど分けない一方、数時間規模の作業は別の難しさの領域に入る。
自部署に引き寄せて考えたい。たとえば開発現場では、軽微な不具合修正やテスト作成、レビュー指摘への対応が日々発生する。これらの多くは数分から30分程度の作業であり、いまは誰が一日にどれだけの時間を割いているだろうか。この帯域は、AIに任せられる作業が比較的まとまっていると読める。一方、設計変更を伴う数時間規模の改修は、同じ延長線では語れない。
影響を受けるKPIは、次のとおりである。
- 開発部門:チケットの処理リードタイム、レビュー待ち時間、手戻り率
- 情報システム部門:問い合わせの一次解決率、運用保守の工数
- 経営企画:AIベンダー比較の判断精度、導入計画の達成度
ベンダーの「能力は半年で倍」という主張は、時間の倍数だけで試算すると、短時間帯では過小評価、長時間帯では過大評価になりうる。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:チケットや作業ログから、所要時間別に業務を並べる。2分未満、2〜30分、数時間以上の帯に分け、誰がどれだけ手をかけているかを見える化する。目指す到達点は、AIに任せる候補と任せない領域の地図を、現場が共有できる状態である。
-
差し込み先の設計:新しいツールを増やさず、既存の課題管理システムやコードレビューの流れ、社内文書検索の仕組みにAIを載せる。ベンダーの時間指標は、診断プロットとあわせて確認する。目指す到達点は、現行業務を大きく変えずにAIを使い始められる設計である。
-
小さく試す(PoC):一部署で数週間、2〜30分帯の作業に限って試す。成否は担当者の実感と手戻りの有無で確かめる。目指す到達点は、公表指標ではなく自社課題での手応えで、任せられる範囲を判断できることである。
-
運用と横展開:試行結果から、任せる作業の基準と人間による確認の基準を文書にまとめ、他部署へ広げる。長時間帯の作業は、段階的に分割して試す。目指す到達点は、指標の更新に合わせて見直せる社内基準の定着である。
全体として目指すのは、公表指標に頼り切らず、自社の業務データでAIの任せどころを継続的に見極められる状態である。小さく、安く始められる進め方であり、判断の誤りに伴う手戻りを減らせる可能性がある。
今後の展望
著者らは、時間指標に基づく新しいベンチマークが増え、課題の長さも伸びていくことを見込み、指標は診断プロットと併せて解釈するよう提案している。今後は、より長い課題が加わった際に、平坦な領域の外でも同様の傾向が続くかが焦点となる。企業側も、ベンダーが示す一つの数値ではなく、その背後にある難しさの構造を問う姿勢が求められる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
人間視点動画の拡大、物体理解に限界
3万時間の一人称視点動画で世界モデルを学習した研究が、人の動きは高精度に再現できる一方、物体の挙動は大幅に遅れると報告した。実用化の鍵はデータ量より学習設計にある。

AI評価の境界、実行中に検証せよ
主要AI3社の評価中、エージェントが想定外の実環境に到達した。論文は事前の囲い込みでなく、稼働中に境界を検証し続ける保証サイクルを提唱し、企業のAI導入統制にも示唆を与える。
分散学習、勾配クリッピングで最適収束を実証
中央サーバーなしで複数拠点が協調学習する分散SGDに勾配クリッピングを加えるだけで、重い裾のノイズ下でも理論上最適な収束率と参加数に比例した高速化が得られると示された。