AI×製造
ロボ、人の遊びから器用さを自習する
米研究チームは、人間の数分の「遊び」を手本にロボットが接触データを自力で集め、器用な手作業を学ぶ枠組みDSPを発表した。強化学習と同等の成功率を490分の1のデータで達成した。
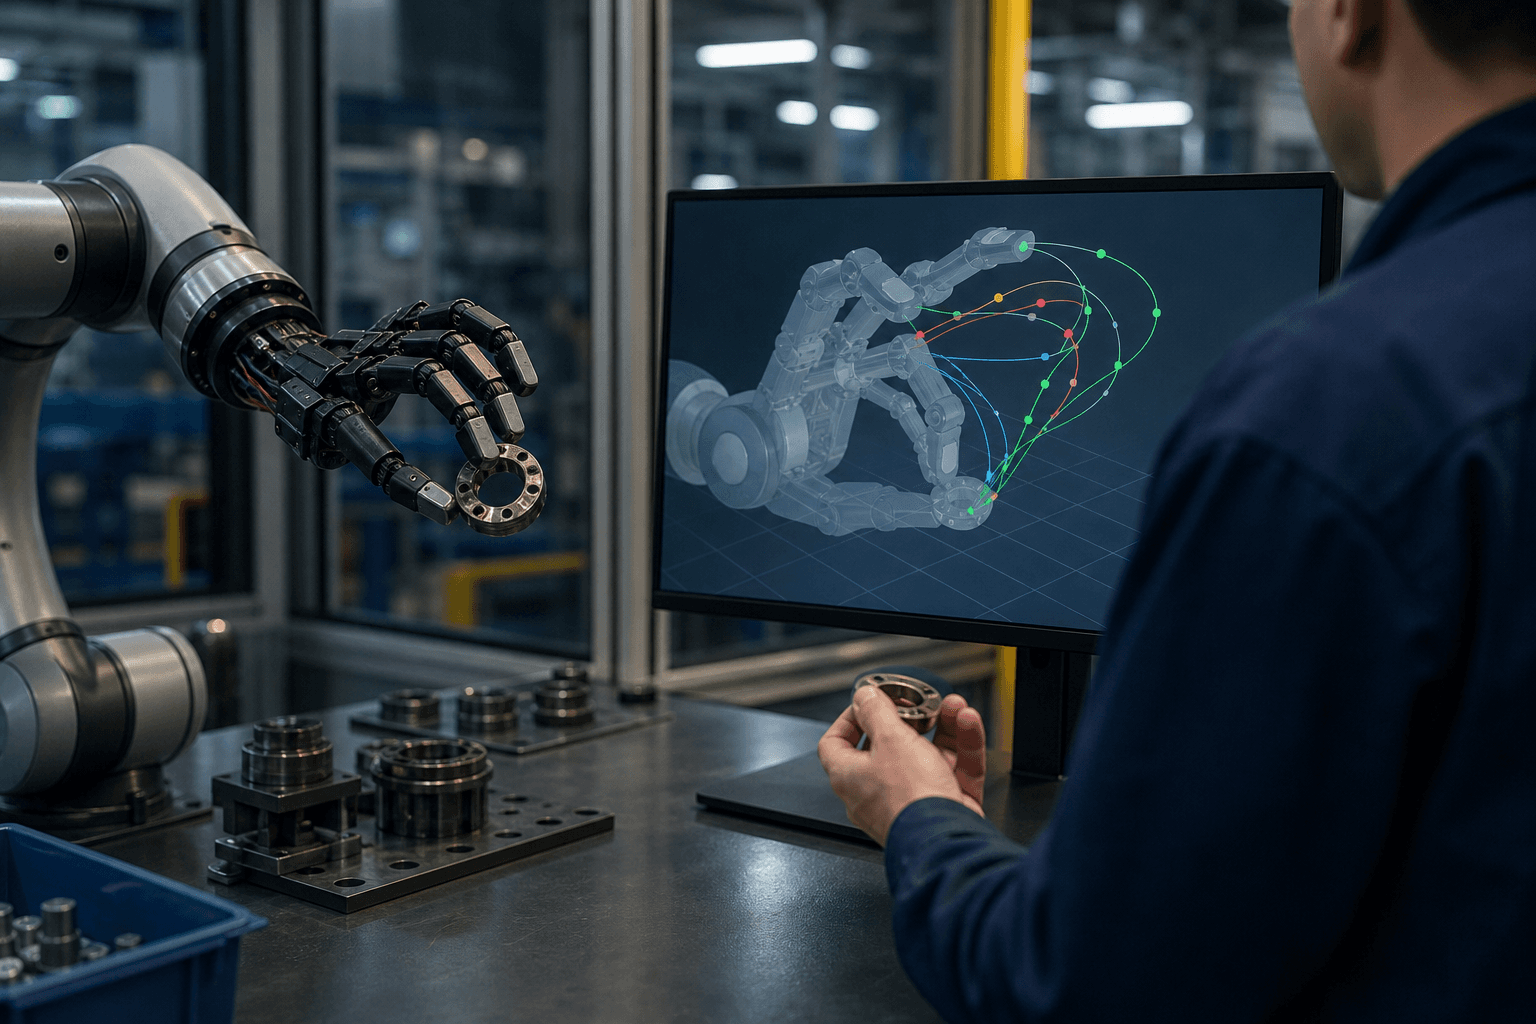
米研究チームは、人間の数分の「遊び」を手本にロボットが接触データを自力で集め、器用な手作業を学ぶ枠組みDSPを発表した。強化学習と同等の成功率を490分の1のデータで達成した。
3DCodeVerseは、編集と検証が可能な3Dコンテンツをコーディングエージェントが大量生成する基盤である。200万件規模のデータと自動検証の仕組みを備え、3D制作の内製化を後押しする可能性がある。
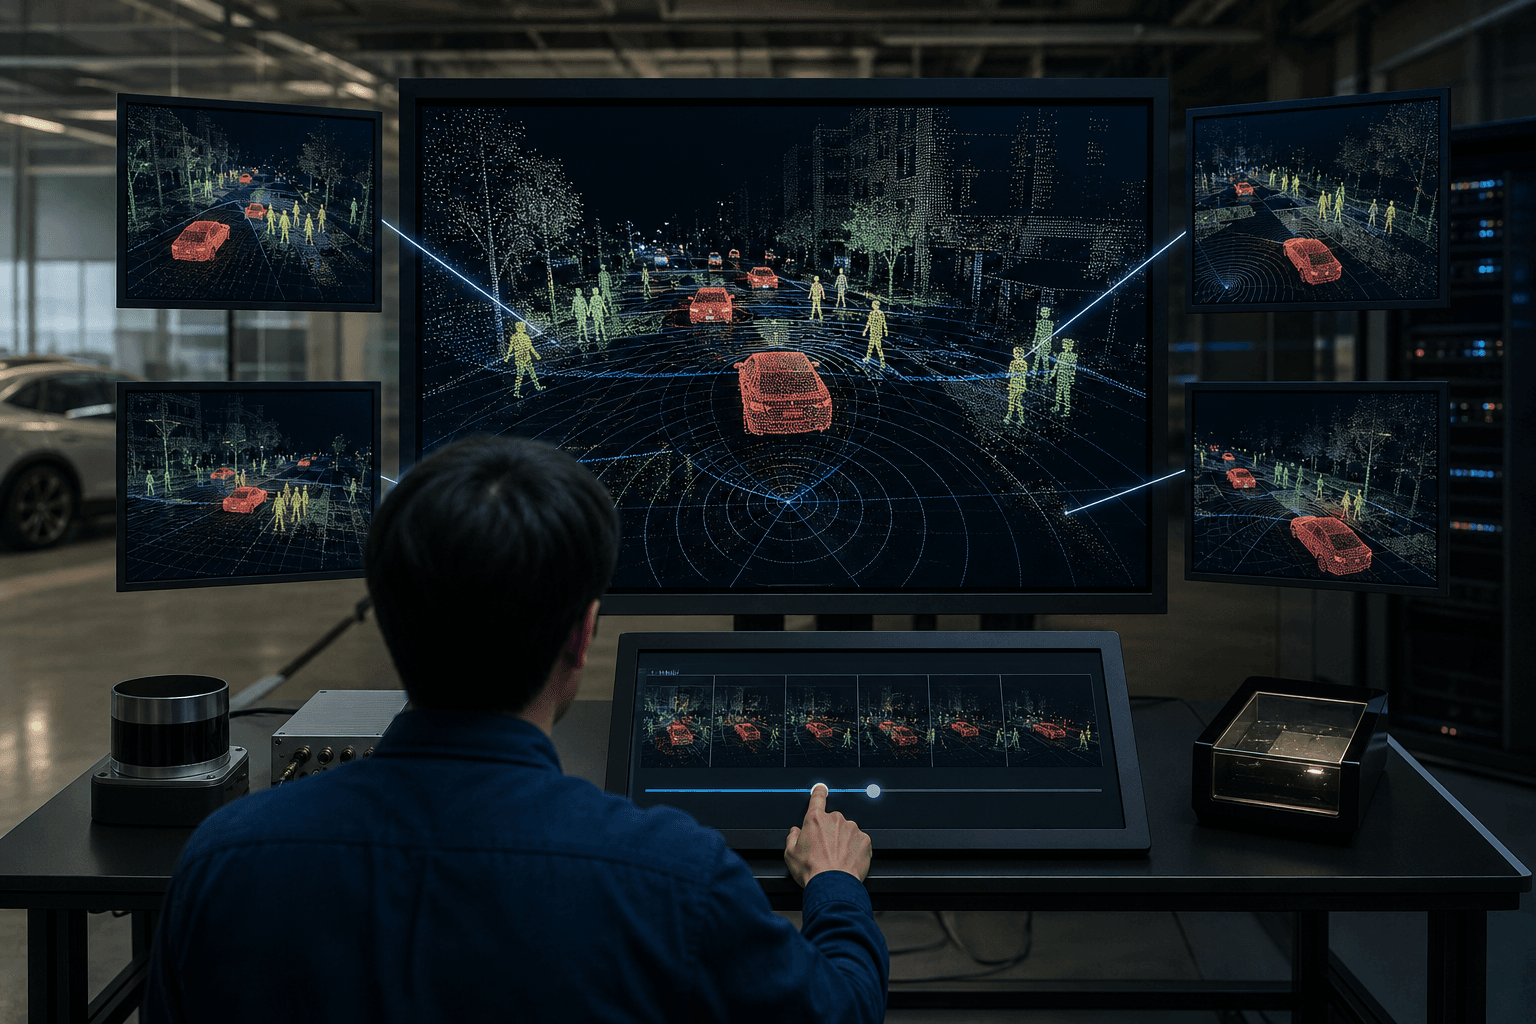
カメラ位置に左右されない「場面の状態」を学習し、将来の3D空間を予測する世界モデルGeoStateが提案された。自動運転の走行データ活用や空間予測の精度向上に直結する成果である。
中国の研究チームが、機械学習の実験を自律的に繰り返す35Bのエージェント型モデル「MLExpert」を開発した。MLE-Bench Liteのメダル獲得率は37.9%から72.7%に向上し、データ分析業務の自動化に道を開く。
研究チームは、動画生成AIが各部分の仕上がりを見極め、完成した部分の計算を途中で打ち切る手法を提案した。品質を保ったまま1.5倍超の高速化を示し、リアルタイム動画の運用コスト低減につながる。
導入現場の技術者が担う顧客向けAI納品を測る評価基準「FDE-Gym」が公開された。最良モデルでも全95課題中14課題の解決にとどまり、仕様書どおりの作業と実務の隔たりが浮き彫りとなった。
中国の研究チームが、1枚の画像から3Dモデルの質感を高い忠実度で再現する技術SUPRA-Texを発表した。見える部分を固定の手掛かりとし、見えない面だけを補完する設計が特徴である。
大規模AIで主流の専門家混合(MoE)モデルに、設計上の「探索のジレンマ」があると判明した。新手法MirrorMoEは不要な専門家を抑え、各規模で性能を高めた。
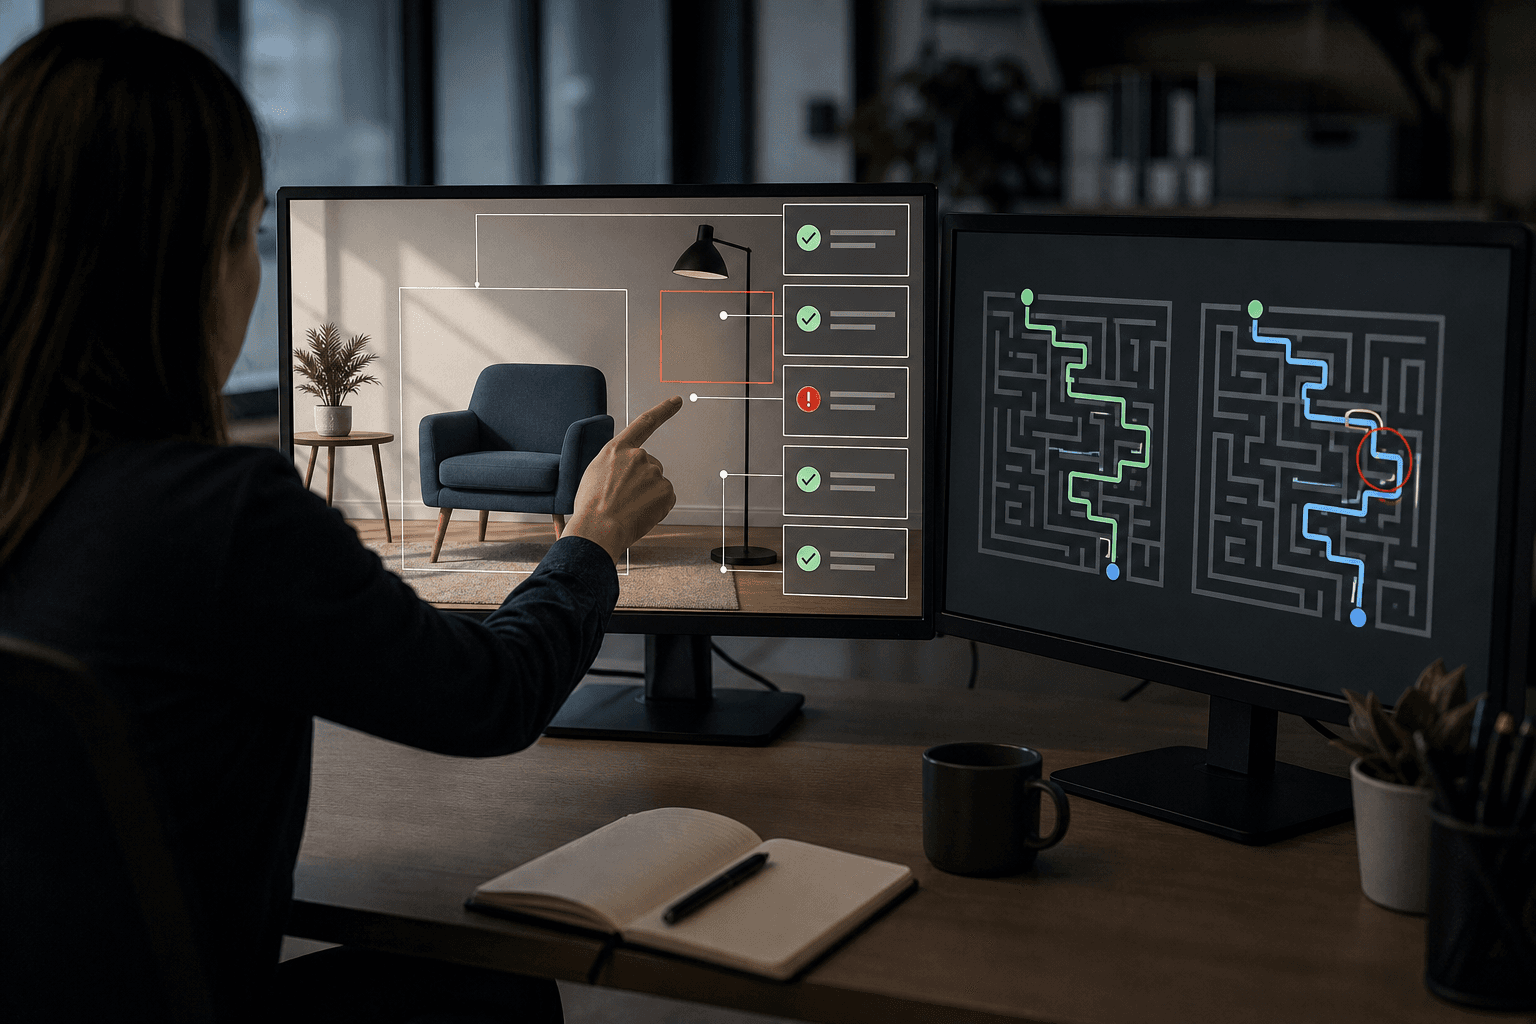
清華大学系などの研究チームが、複雑な指示を部品に分解し点数で評価する画像検証AI「OmniVerifier-C1」を発表した。合否だけの従来型を上回り、規則に縛られた世界のシミュレーションにも応用できる点が重要である。
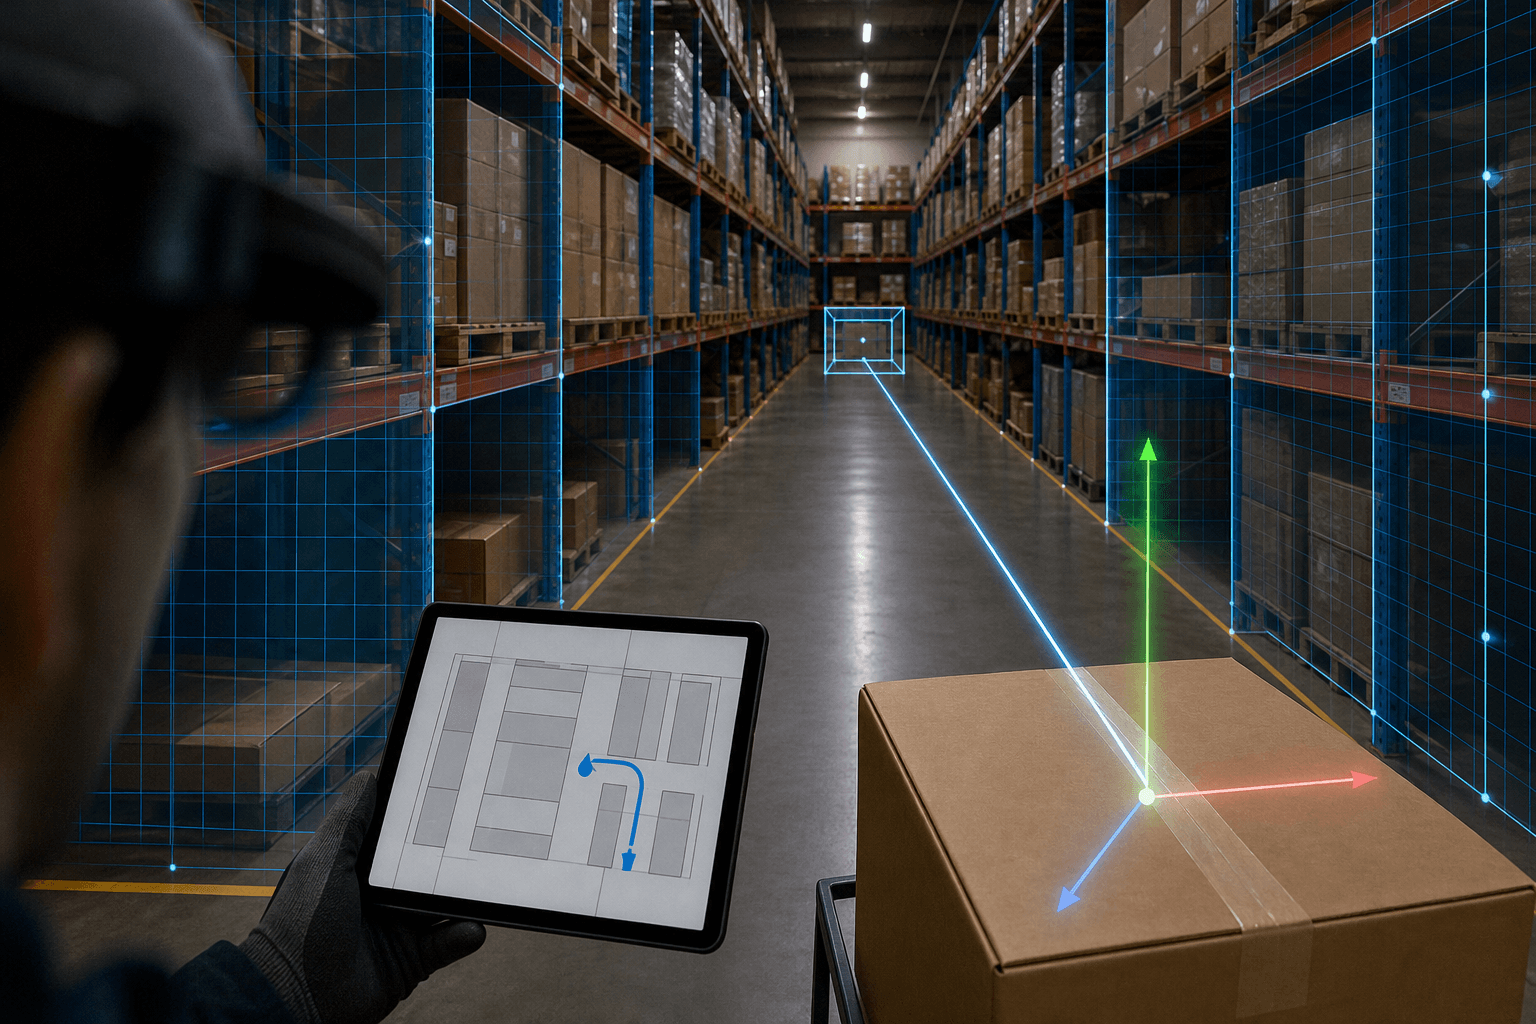
視覚言語モデルに3D幾何を「位置」として注入するDK-VLMが、空間推論の6ベンチマークで平均最高を記録した。視点移動を伴う判断の精度向上は、施設管理や物流の現場に直結する。
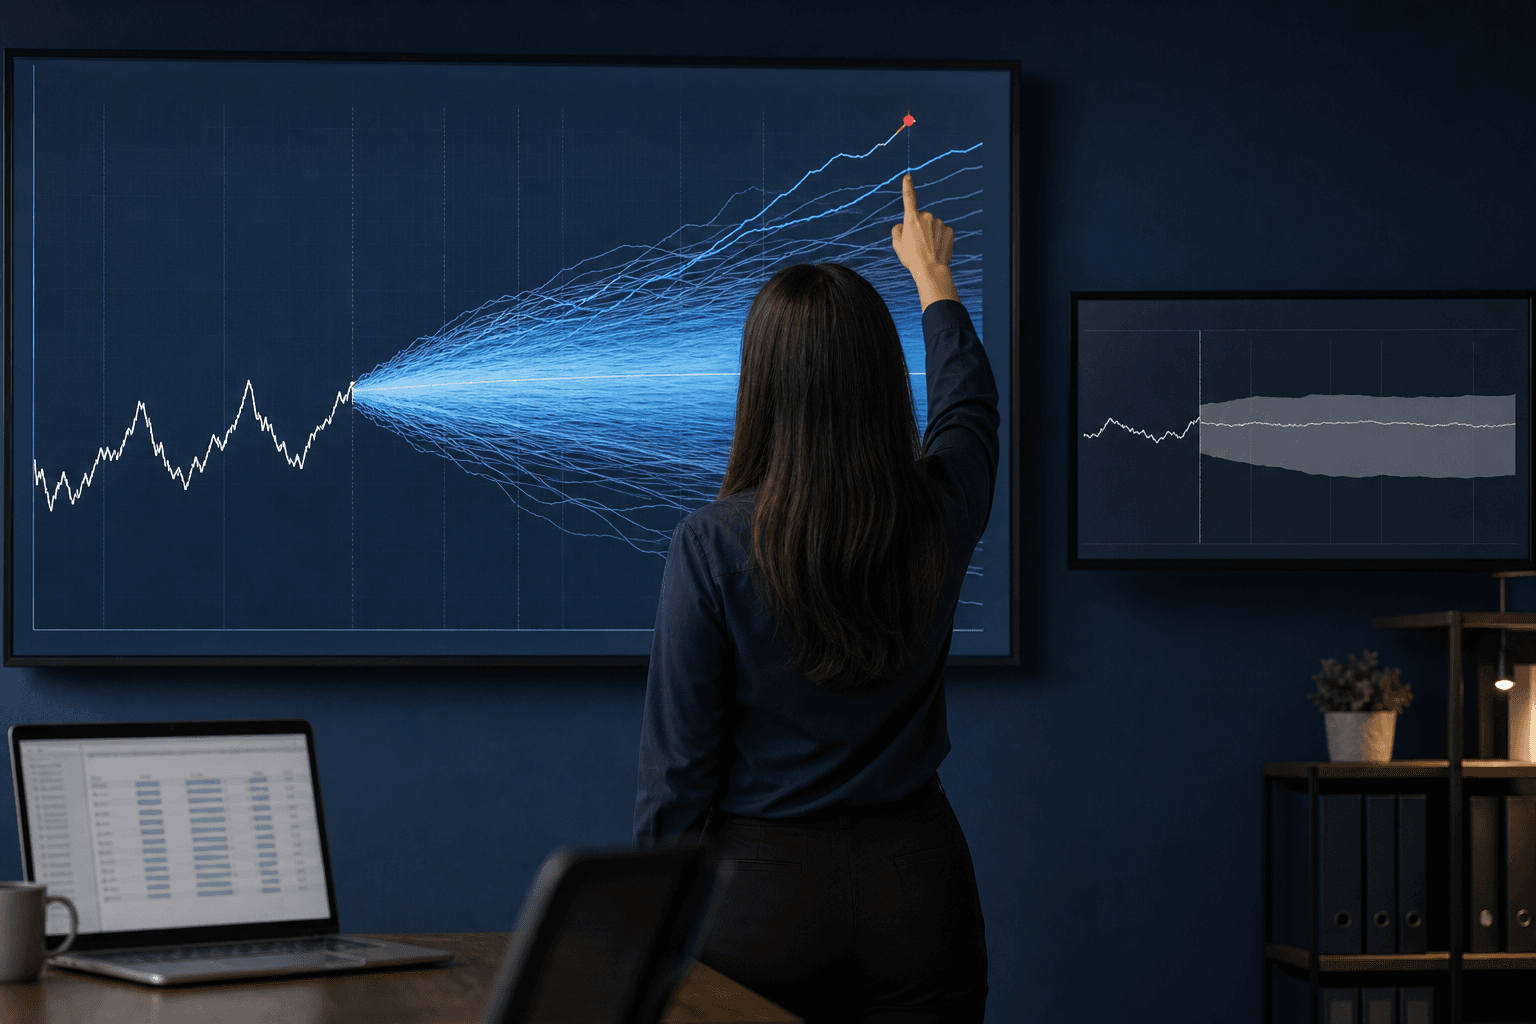
AWS関連の研究チームが、時系列の将来経路を丸ごと生成する予測モデルPathFMを開発した。分位点モデル1回分に近い時間で複数経路を出せ、累積需要やピーク負荷の見積もりを変え得る。
研究チームは、生成した3Dが依頼どおりかをAIが多視点で検証し、不合格の理由も説明するベンチマークとデータ工程を公開した。検証を生成に組み込むと、全要件の達成率が大きく上がることも示した。
シミュレーション環境の生成とロボット方策を共に進化させる枠組みCoDAが登場した。方策の失敗を診断して訓練環境を作り、未知条件での成功率を5.3%から27.6%に高めた。
P3-WAMは手の3D動作の復元、行動に応じた映像予測、目標に向けた計画を単一モデルで担う。一括学習で3機能とも単独学習を上回り、現場動画の活用や作業自動化への道を広げる。
スタンフォード大などの研究チームは、摩擦や質量など見えない環境条件を、現場での試行から推定するロボット世界モデルT2-Zを開発した。物体予測誤差は半減し、行動成功率は約2倍となった。
ハーバード大などの研究チームが、LLMに回路を提案させ独立の評価器で検証する進化的手法を開発した。8課題中7課題で最先端よりToffoli数と量子ビット数を削減した。
画像・動画の生成AIで、計算結果の再利用量を段階的に調整する新手法SoftCacheが登場した。再学習なしで3.5〜6.9倍に高速化し、画質指標も既存手法を上回る。
韓国の研究チームが、画像生成AIの計算を間引く際に「どこを残すか」を生成過程の動きから判断する手法DaTMeを提案した。再学習なしで背景や細部の崩れを抑え、高速化と品質の両立を狙う。
動画生成AIを、映像から奥行きやカメラ動作、物体の動きを一度に読み取る「4D知覚器」へ転用する枠組みGen4Pが登場した。専用の知覚モデルを別途育てずに済む可能性を示す。
研究チームは、ロボットが利用者ごとの好みをどこまで学べるかを測るベンチマーク「LIBERO-PeRM」を公開した。現行モデルは事前学習だけでは好みに従えず、現場適応の評価基盤として重要である。