家庭用ロボの好み対応力を測る基準が登場
研究チームは、ロボットが利用者ごとの好みをどこまで学べるかを測るベンチマーク「LIBERO-PeRM」を公開した。現行モデルは事前学習だけでは好みに従えず、現場適応の評価基盤として重要である。
研究の概要
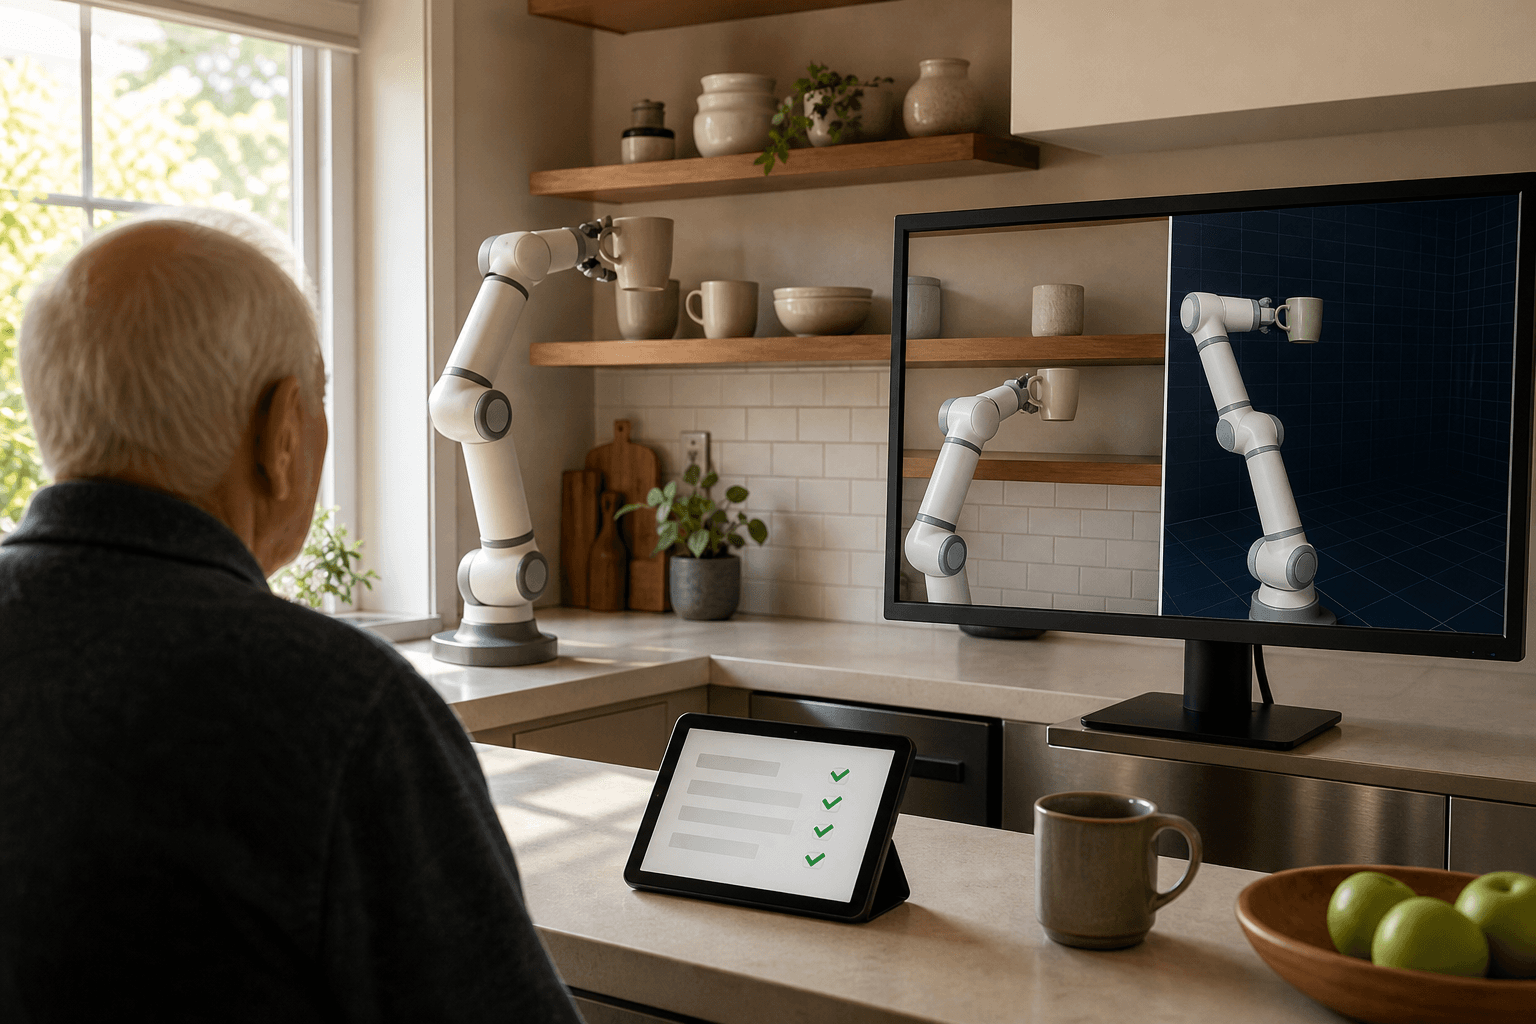
研究チームは、ロボット操作における個人適応を測定する基準LIBERO-PeRMを公開した。従来のロボット操作研究は、タスクを完遂できるかを主に評価してきた。しかし家庭や介護、店舗の現場では、同じ「物を片付ける」作業でも、ゆっくり丁寧に運ぶ、特定の手順を好むなど、利用者ごとの好みを満たせるかが実用性を左右する。本研究は、タスク完了と好みの充足を切り分けて測る点に特徴がある。
既存のLIBEROを土台に、好みを動作、スキル、利用者プロファイルの3類型で定義した。条件は、タスク目標を変えずに言語で表現でき、自動採点でき、タスク間で再利用できることである。好みの有無で対になるデモンストレーションを手続き的に生成し、5つのタスクスイート(312タスク)を構築した。評価は、ゼロショットでの追従、単一の好みの学習、デモ数を増やしたときの習得効率、レイアウトやタスクをまたぐ汎化、複数の好みの合成と衝突時の挙動という5つの問いで行う。
実験では、現行のVLA政策はゼロショットの個人適応に苦戦した。一方、教師あり微調整(SFT)を施すと好みは学習可能になった。好みなしと好みありを混ぜて学ぶ混合学習は、好みなしタスクの性能維持で逐次適応を上回り、文脈プロンプトを併用すると好みのみの学習より改善した。ただし動作に関する好みの学習は弱まる傾向があった。汎化、分解、衝突の処理は依然として難しい。
しくみをやさしく
VLAとは、カメラ画像と言語指示を入力し、ロボットの動作を直接出力する大規模モデルである。「赤いカップを棚へ」という指示には従えても、「この人はいつも左手側から、ゆっくり置く」という癖までは知らない。これがゼロショットで失敗する理由である。
本ベンチマークは、同じ作業を好みなしと好みありの2通りで記録した手本を大量に用意する。これにより、モデルが作業そのものを誤ったのか、好みだけを外したのかを分けて採点できる。
混合学習と逐次適応の違いは、新人教育に例えられる。標準手順を覚えた後に特定顧客向けの流儀だけを追加で教え込むと、標準手順を忘れやすい。これが逐次適応の弱点である。最初から両方を混ぜて教えれば忘れにくいが、細かな動きの癖は薄まりやすい。この得失が数値で比較できるようになった点が成果である。
ビジネスへの示唆
恩恵が大きいのは、利用者や顧客ごとに「やり方の流儀」が異なる反復作業である。たとえば介護施設の配膳・片付け、飲食店厨房の盛り付け補助、物流現場での顧客別の梱包や仕分けが該当する。
読者は、自部署で該当する業務は何か、いま誰がどれだけ手をかけて個別対応しているか、と問うてみてほしい。ベテランが暗黙知で担う顧客別ルールが多い現場ほど、好みの学習は価値を持つ。
動く可能性のある指標は次のとおりである。
- 現場運営部門:やり直し率、クレーム件数、顧客別ルールの教育にかかる時間
- 品質管理部門:仕様逸脱の発生頻度
- 商品・サービス企画部門:顧客満足度、個別対応の提供可能範囲
一方で、複数の好みの合成や衝突の処理は未解決である。「ゆっくり」と「急ぎ」のように要望が食い違う場面を、現行モデルが自力でさばけるとは見込みにくい。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
- 棚卸し:個別対応で手間が詰まっている作業を洗い出す。好みを動作、手順、利用者属性に分類し、言語で書き出せるものを選ぶ。到達点は、自動化候補と人が担うべき判断の線引きが見える状態である。
- 差し込み先の設計:新しい仕組みを増やさず、既存のロボットや作業指示書、顧客情報の管理に好み情報を紐づける。モデルには文脈プロンプトとして渡す。到達点は、現場が追加の操作を意識せず好みが反映される状態である。
- 小さく試す(PoC):一部署・数週間に限り、少数の好みで試す。好みなしの標準作業が劣化していないかを必ず併せて確認し、担当者の実感で判断する。到達点は、効果と副作用を現場の言葉で語れる状態である。
- 運用と横展開:好みの記述形式、評価基準、衝突時に人へ引き継ぐルールを整え、他部署へ広げる。到達点は、新しい好みを小さな手間で追加できる運用である。
全体として目指すのは、標準作業の品質を保ったまま、利用者ごとの流儀に小さく・安く適応できる現場である。
今後の展望
本研究は、好みの習得、汎化、合成、衝突を同じ土俵で測る基準を提供した。今後は、動作の好みを弱めない学習法や、衝突時に人へ確認する設計が競争点になる。企業にとっては、ロボットを選ぶ際に、作業の成功率に加えて好みへの適応力を問う視点が重要になる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
PathFM、需要予測の将来経路を高速生成
AWS関連の研究チームが、時系列の将来経路を丸ごと生成する予測モデルPathFMを開発した。分位点モデル1回分に近い時間で複数経路を出せ、累積需要やピーク負荷の見積もりを変え得る。
LLMが量子回路を設計、資源削減を実証
ハーバード大などの研究チームが、LLMに回路を提案させ独立の評価器で検証する進化的手法を開発した。8課題中7課題で最先端よりToffoli数と量子ビット数を削減した。
SoftCache、拡散モデル生成を最大6.9倍高速化
画像・動画の生成AIで、計算結果の再利用量を段階的に調整する新手法SoftCacheが登場した。再学習なしで3.5〜6.9倍に高速化し、画質指標も既存手法を上回る。