1枚の画像から見た目忠実な3D素材を生成
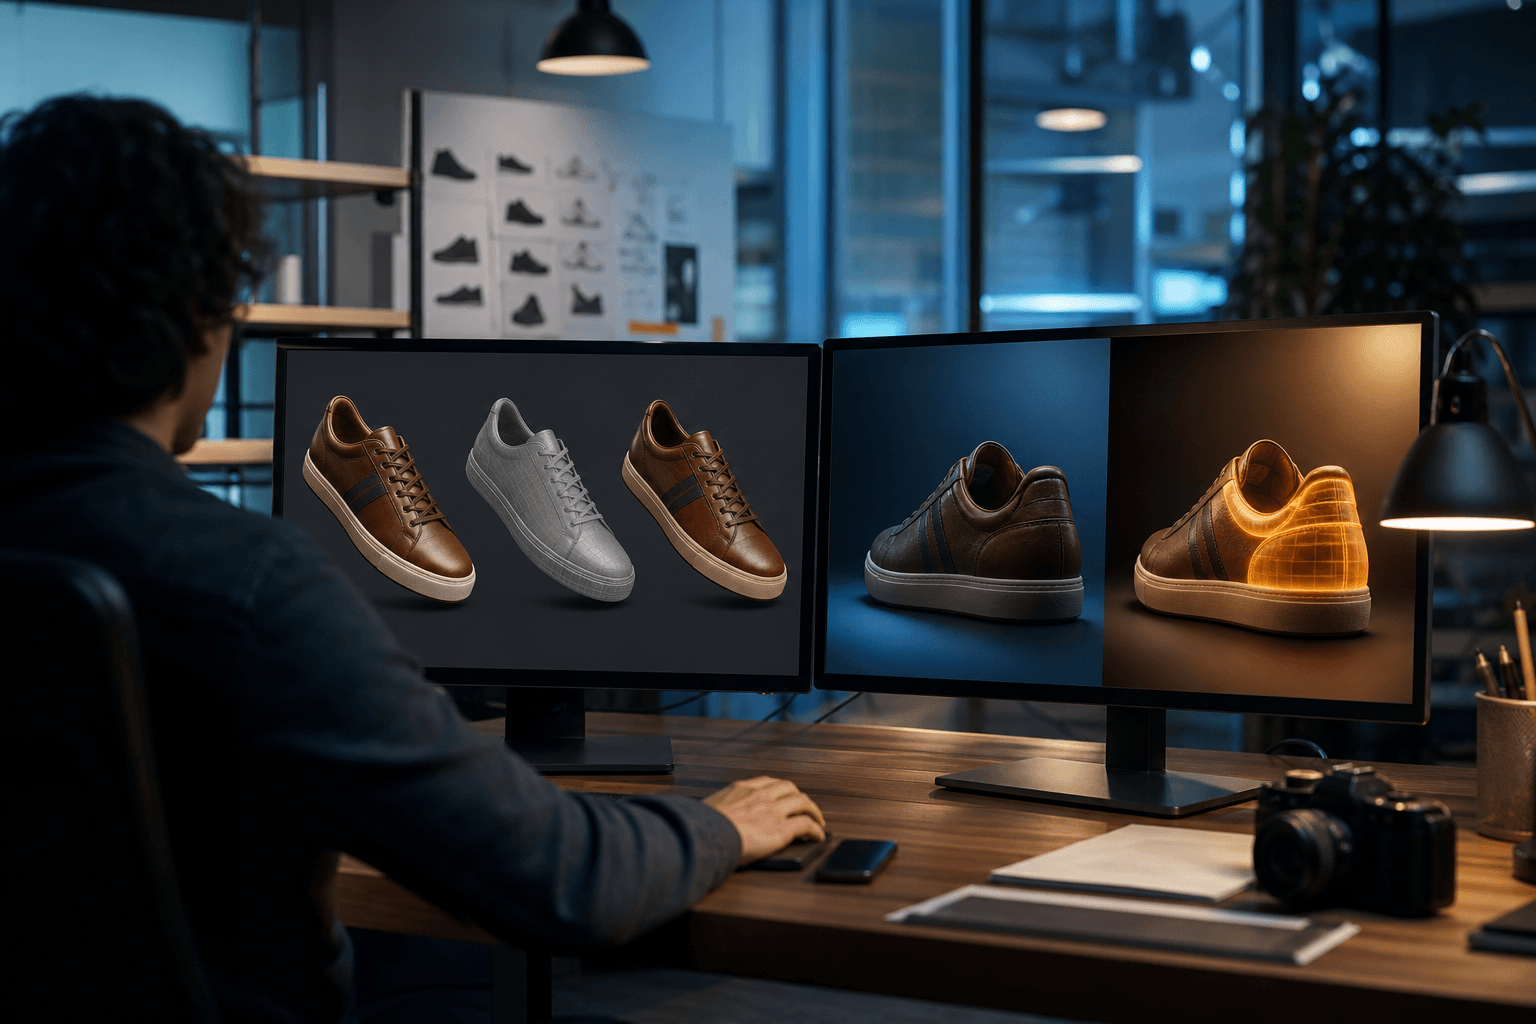
中国の研究チームが、1枚の画像から3Dモデルの質感を高い忠実度で再現する技術SUPRA-Texを発表した。見える部分を固定の手掛かりとし、見えない面だけを補完する設計が特徴である。
研究の概要
SUPRA-Texは、単一画像から3Dメッシュに再照明可能な素材を貼り付ける技術である。ここでいう素材とは、光の当たり方が変わっても自然に見えるPBR(物理ベースレンダリング)用のマップ群を指す。研究チームが課題としたのは、既存手法の二つの弱点である。一つは、複数視点の予測を融合する際に矛盾が生じ、継ぎ目や破綻が出る点である。もう一つは、画像の特徴を暗黙的に条件付けする方式では、ロゴや文字、細かな柄といった細部が失われやすい点である。
論文は、可視部分の素材推定、表面への位置合わせ、観測に導かれた3D補完という三つの工程を分離することで、これらを解決すると主張する。限られた3Dデータで学習した生成器は、見えている証拠を保つことと、見えていない面を補うことに能力を集中できる。公開データのみで学習しながら、ジオメトリ指定のテクスチャ生成と、画像からの一貫した資産生成の双方で最高水準の性能を示し、実世界の画像では主要な商用システムに並ぶか上回るとしている。
しくみをやさしく
処理は三段階で進む。第一に、マルチモーダルLLMを基盤とする画像編集モデルが、参照画像から「照明の影響を取り除いた」素材マップを予測する。写真には光や影が焼き込まれているため、これを分離しておかないと、別の照明下に置いた際に不自然になる。
第二に、得られたマップを3Dメッシュの見える表面へ投影する。さらに事前学習済みの素材VAEエンコーダで、生成対象と同じ潜在空間の「観測潜在表現」に変換する。同じ空間に置くことで、見えている情報がそのまま生成器の言語で表現される。
第三に、インターリーブ型フロートランスフォーマーが完全な素材を生成する。この観測潜在表現は書き換え不可の固定アンカーとして保持される。そのうえで、未観測領域の更新と全表面の更新を交互に繰り返す。見える部分は写真どおりに保たれ、裏側や隠れた面は整合性を保ちながら補われる。論文はこれを、見たままが得られる「What You See Is What You Get」の忠実度と表現している。
ビジネスへの示唆
恩恵が大きいのは、商品画像から3D資産を起こす日常業務である。たとえばEC事業のコンテンツ制作部門では、新商品が入るたびに3Dモデラーが写真を見ながらテクスチャを手作業で描き込んでいる。ゲーム開発のアセット制作、家具やインテリアの販促、メーカーの設計・マーケティング部門も同様である。自部署で、画像から3Dや素材を起こす業務は何か、いま誰がどれだけ手をかけているかを問うことが出発点となる。
動く可能性のある指標は次のとおりである。
- 制作リードタイム:新規アセット1点あたりの制作期間
- 修正回数:写真との見た目の差異による手戻り
- ブランド整合性:ロゴや柄の再現精度に起因する品質指摘
- 返品率:実物との見た目の差が原因となる返品
再照明が可能なため、AR試着や店舗シミュレーション、広告ビジュアルなど、異なる照明環境へ同一資産を転用しやすい点も利点である。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
- 棚卸し:3D資産やテクスチャ作成にかかわる業務を洗い出し、手作業が集中する工程や手戻りの多い工程を可視化する。目指す到達点は、効果の出やすい対象商品群と判断基準が共有された状態である。
- 差し込み先の設計:新しいツールを増やさず、既存のDCCツールや資産管理の流れに「画像からの素材案生成」を一工程として載せる。目指す到達点は、モデラーが普段の環境のまま下書きを得られる状態である。
- 小さく試す(PoC):一部署、数週間の範囲で、実際の商品画像から素材を生成し、担当者の実感で品質と手間の変化を確かめる。目指す到達点は、使える場面と使えない場面を現場の言葉で説明できる状態である。
- 運用と横展開:合格基準、確認担当、権利処理のルールを整え、他部署や他カテゴリへ広げる。目指す到達点は、品質を保ちながら再現性をもって運用できる状態である。
全体として目指すのは、写真から忠実な3D素材の初稿が得られ、人は仕上げと判断に時間を使える状態である。
今後の展望
本手法は公開データのみで学習されており、小さく始めやすい土台がある。一方、見えない面の補完はあくまで推定であり、重要な商品では最終確認が欠かせない。商用システムと並ぶ水準に達したことで、3D制作の内製化を検討する企業の選択肢が広がると見られる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボ、人の遊びから器用さを自習する
米研究チームは、人間の数分の「遊び」を手本にロボットが接触データを自力で集め、器用な手作業を学ぶ枠組みDSPを発表した。強化学習と同等の成功率を490分の1のデータで達成した。
3D制作をコード化するAI基盤が登場
3DCodeVerseは、編集と検証が可能な3Dコンテンツをコーディングエージェントが大量生成する基盤である。200万件規模のデータと自動検証の仕組みを備え、3D制作の内製化を後押しする可能性がある。
視点依存を分離する3D世界モデルが登場
カメラ位置に左右されない「場面の状態」を学習し、将来の3D空間を予測する世界モデルGeoStateが提案された。自動運転の走行データ活用や空間予測の精度向上に直結する成果である。