MoE改良手法MirrorMoE、探索の矛盾を解消
大規模AIで主流の専門家混合(MoE)モデルに、設計上の「探索のジレンマ」があると判明した。新手法MirrorMoEは不要な専門家を抑え、各規模で性能を高めた。
研究の概要
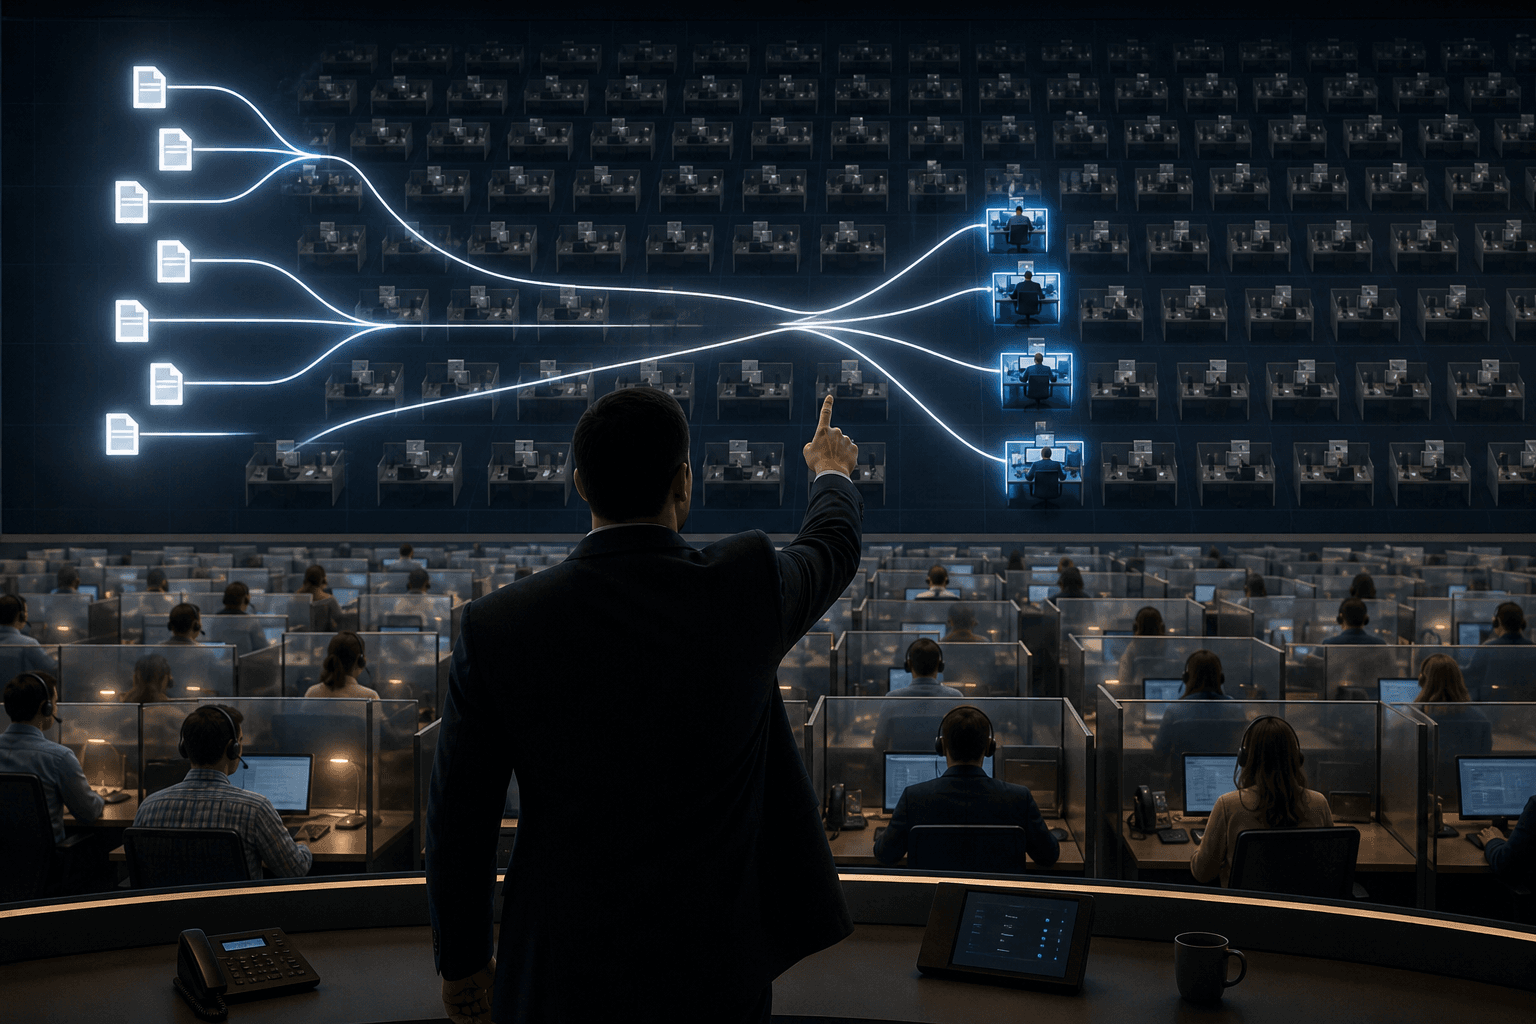
Bingcong Li氏らの研究チームは、混合専門家(MoE)モデルの最新設計に潜む矛盾を指摘し、解決策としてMirrorMoEを提案した。MoEは、多数の「専門家」と呼ばれる小さなネットワークのうち一部だけを入力ごとに動かし、パラメータ数を増やしながら計算量を抑える方式である。
近年のMoEは二つの設計を併用する傾向にある。一つは細粒度の専門家分割であり、活性化する割合を一定に保ったまま専門家を細かく分け、選べる組み合わせの数を増やす。もう一つは共有専門家であり、すべてのトークン(文章を区切った処理単位)で常に働く専門家を置く。
研究チームは両者の間に探索のジレンマがあると指摘する。共有専門家が常に働くと、トークンの表現のばらつきが小さくなり、振り分け(ルーティング)が多様な組み合わせを試しにくくなる。一方、細粒度分割では組み合わせが爆発的に増えるため、むしろ試行錯誤が必要になる。この結果、細粒度分割で得られるはずの表現力が実際には十分に引き出されていない可能性がある。MirrorMoEは複数のモデル規模で一貫して性能を改善したと報告されている。
しくみをやさしく
MoEのルーティングは、受付で案件を担当者に振り分ける作業に近い。担当者が数百人に細分化されると、組み合わせの候補は膨大になる。優れた振り分けを見つけるには、さまざまな組み合わせを試す必要がある。
ところが共有専門家は、全案件に必ず関与する「全員参加の担当者」にあたる。この担当者の出力が全案件に共通して加わるため、案件ごとの特徴の差が薄まり、振り分け役が違いを見分けにくくなる。これが探索の低下を招く。
MirrorMoEの発想は、探索を増やすのではなく探索空間を狭めることにある。トークンごとに、その処理に不要な専門家を適応的に抑制する。候補の組み合わせが減れば、限られた試行でも有望な組み合わせに到達しやすくなる。論文の要旨からは、抑制の具体的な計算手順までは読み取れないが、狙いは広大な探索空間を現実的な大きさに絞る点にある。
ビジネスへの示唆
自社でMoE型の基盤モデルを学習・調整する企業にとって、同じ計算予算でモデルの質を高められる可能性がある。ただし多くの企業は、公開モデルを利用する立場であろう。その場合も、選定するモデルの内部設計が品質やコストを左右するという理解は役立つ。
具体的な業務で考えたい。カスタマーサポート部門では、問い合わせ要約や回答案の作成に大規模モデルが日々使われる。法務部門では契約書の条項抽出に使われる。いずれも、同じ処理費用でどれだけ精度が出るかが運用の鍵である。自部署でAIが担う業務は何か、いま誰がどれだけ確認作業に手をかけているかを、まず書き出してみるべきである。
影響を受けやすい部署とKPIは次のとおりである。
- 情報システム部門:推論コスト、応答時間、GPU利用効率
- カスタマーサポート:一次回答の正答率、対応時間
- 法務・経理:抽出精度、人手による再確認の件数
- 研究開発:自社モデルの学習効率、品質あたりの開発費
なお、論文が示す根拠は要旨の範囲では「複数規模での一貫した性能向上」であり、具体的な改善幅や費用削減額は確認できない。導入判断では自社データでの検証が欠かせない。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
- 棚卸し:生成AIを使う業務を洗い出し、どこで精度不足や処理費用の負担が出ているかを可視化する。目指す到達点は、モデル改善の恩恵が大きい業務の優先順位が、担当者の実感とともに共有された状態である。
- 差し込み先の設計:自社で学習するのか、外部モデルを使うのかを分ける。外部利用なら、MoE型モデルを既存のAPIや社内検索(RAG)の裏側で差し替える形にとどめ、新しいツールを増やさない。自社学習なら、既存の学習基盤にルーティング改良を追加する。目指す到達点は、業務フローを変えずにモデルだけを入れ替えられる構成である。
- 小さく試す(PoC):一部署、数週間の範囲で、従来モデルと新方式のモデルを同じ業務データで比較する。評価は数値だけでなく、担当者が「手直しが減ったか」を実感で確かめる。目指す到達点は、自社業務で効果が出るかを小さく・安く判断できる状態である。
- 運用と横展開:効果が確認できた場合に限り、評価基準と更新手順を文書化し、他部署へ広げる。モデルの入れ替え時期も定める。目指す到達点は、モデルの進化を継続的に取り込める運用体制である。
全体として目指すのは、モデル内部の進歩を現場の品質向上と費用抑制へ着実に結びつける状態である。
今後の展望
今回の成果は、MoEの性能が規模だけでなく、振り分けの学習しやすさにも左右されることを示した。今後は、より大規模なモデルや多様なタスクでの再現性が焦点となる。企業側には、モデル選定時に設計思想まで確認する姿勢が求められよう。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
機械学習開発を自律遂行する35Bモデル登場
中国の研究チームが、機械学習の実験を自律的に繰り返す35Bのエージェント型モデル「MLExpert」を開発した。MLE-Bench Liteのメダル獲得率は37.9%から72.7%に向上し、データ分析業務の自動化に道を開く。
動画生成AI、必要な部分だけ磨き1.5倍速に
研究チームは、動画生成AIが各部分の仕上がりを見極め、完成した部分の計算を途中で打ち切る手法を提案した。品質を保ったまま1.5倍超の高速化を示し、リアルタイム動画の運用コスト低減につながる。
顧客現場でのAI納品、評価基準が登場
導入現場の技術者が担う顧客向けAI納品を測る評価基準「FDE-Gym」が公開された。最良モデルでも全95課題中14課題の解決にとどまり、仕様書どおりの作業と実務の隔たりが浮き彫りとなった。