AIが空間認識を強化、幾何を位置情報で注入
視覚言語モデルに3D幾何を「位置」として注入するDK-VLMが、空間推論の6ベンチマークで平均最高を記録した。視点移動を伴う判断の精度向上は、施設管理や物流の現場に直結する。
研究の概要
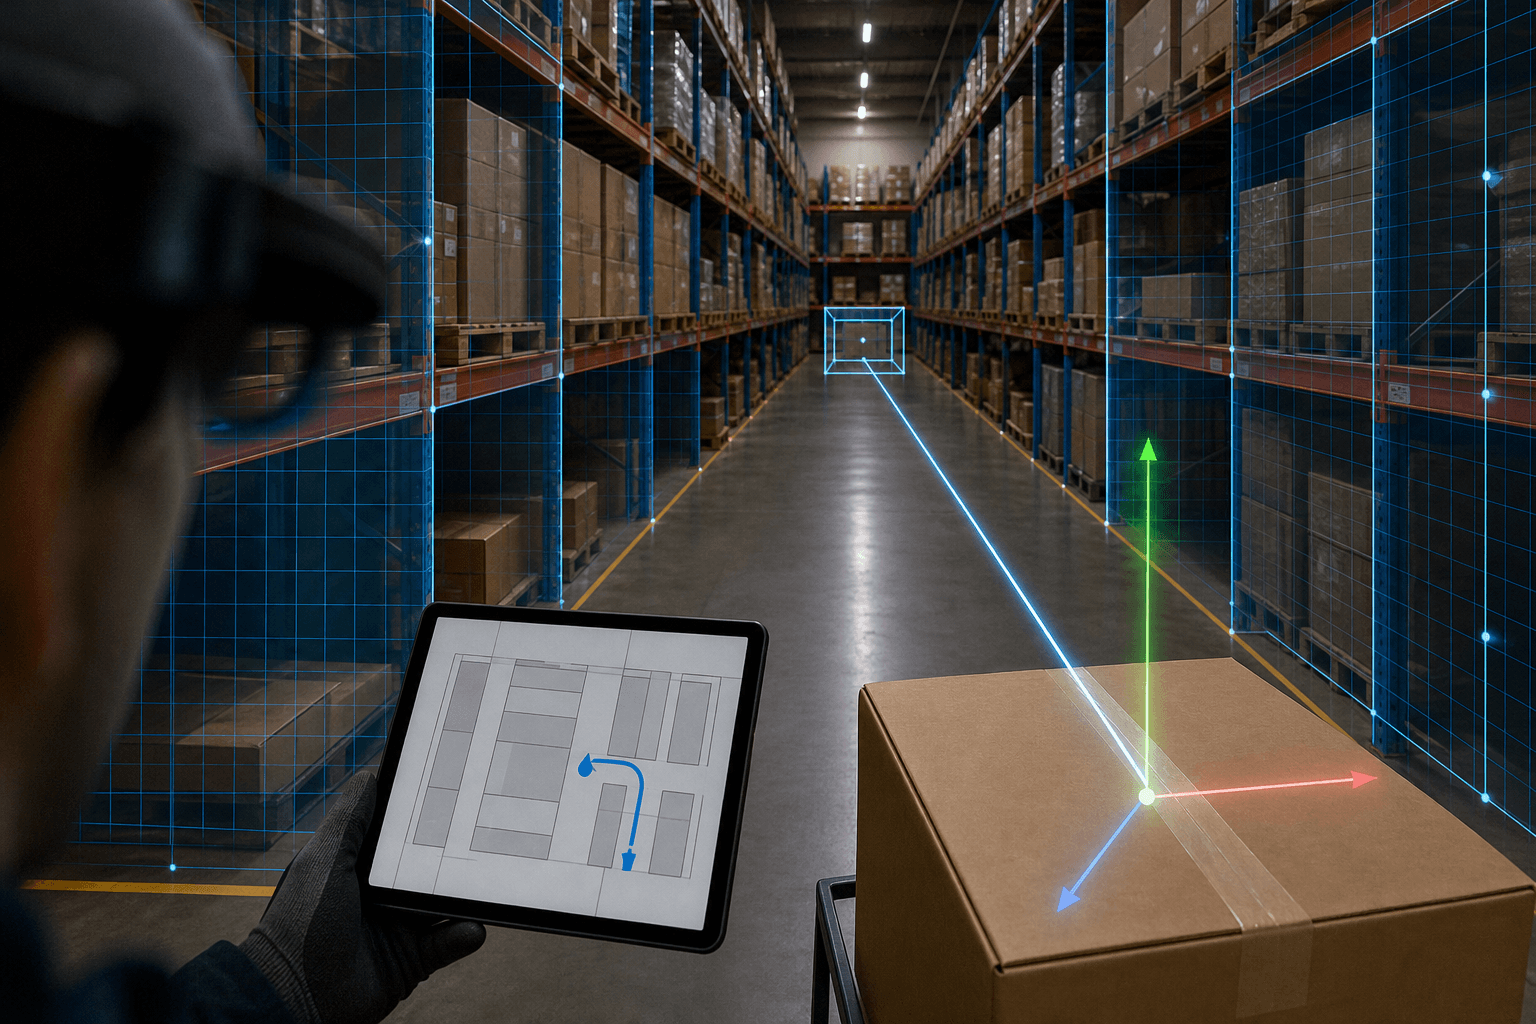
視覚言語モデルは、画像や動画の内容を言葉で説明することには長けている。しかし、複数の視点にまたがる3次元の位置関係を理解し、観察者が動くたびに判断を更新することは、いまも苦手としている。たとえば「入口から見て右にあった棚は、奥の通路から見るとどちらか」といった問いである。
従来は、3D再構成で得た特徴を視覚トークンに融合する手法が一般的であった。だが、空間の教師データが限られる状況では、この特徴を事前学習済みの意味表現と整合させることが難しい。
Han Su氏らの研究チームは、この課題に対しDK-VLMを提案した。中核はデュアルカーネル注意機構である。8B規模のDK-VLMは、比較対象の中で6つの空間ベンチマークの平均スコアが最も高く、VSI-Benchで74.33、ReVSI-32で58.28と、いずれも総合最高点を得た。一般的な動画理解の性能も保たれたという。
しくみをやさしく
注意機構とは、画像の各断片(トークン)が、他のどの断片に注目すべきかを決める仕組みである。通常は、画像上の並び順という「入力位置」が手がかりになる。
DK-VLMはここに2つの視点を持ち込む。1つ目の意味カーネルは、事前学習済みモデルがもともと持つ注意と位置符号化をそのまま残す。2つ目の幾何カーネルは、推定した3D点群とカメラ姿勢を使い、点同士の変位や視点間の相対的な変換に基づいて注意を直接調整する。この2系統の出力を、学習されたゲートが場面に応じて混ぜ合わせる。
要点は、幾何を「融合する特徴」ではなく「位置」として注意に入れる点である。地図にたとえれば、写真に別の情報を貼り付けるのではなく、写真の各点に座標を振って近さを計算させる発想に近い。これにより、既存の意味理解を壊さずに空間の手がかりを加えられる。
もう一つの工夫が参照枠合成(RC)教師である。観察者が右へ曲がり、さらに向きを変える、といった連続判断では、基準となる座標系を更新し続けなければならない。RCは、検証済みの単一ステップ注釈から、段階的な旋回と向きの目標を作って学習させる。これが複数ステップの空間推論を改善した。
ビジネスへの示唆
空間推論の改善は、「人が現場を歩きながら見て判断している業務」に効く。
- 施設管理部門:巡回動画から、設備の位置関係や配置漏れを確認する作業
- 物流・倉庫部門:棚や通路の配置を踏まえたピッキング経路の確認
- 建設・不動産部門:現場の進捗写真と図面の照合
- 小売の店舗運営部門:陳列状況の確認と是正指示
読者はまず、自部署で「動画や複数枚の写真を見て、位置関係を言葉で報告している業務」は何かを考えてほしい。その作業に、いま誰がどれだけの時間をかけているか。ここが適用候補である。
動くKPIとしては、点検・巡回報告の作成工数、確認漏れや誤配置による手戻り率、新人の習熟にかかる期間が考えられる。ただし論文はベンチマーク上の評価であり、現場での効果は別途検証が要る。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
- 棚卸し:位置関係の判断が必要な業務を洗い出し、報告書作成や目視確認で誰の手が止まっているかを可視化する。到達点は、空間判断に時間を取られている業務の優先順位表である。
- 差し込み先の設計:新しいツールを増やさず、既存の点検アプリや報告書の下書き作成、社内の問い合わせ画面に載せる形を探る。撮影した動画に基づく質問応答から始めるのが現実的である。到達点は、現場が普段の操作のまま使える入口の確定である。
- 小さく試す(PoC):一部署・数週間に絞り、実際の巡回動画で回答の正誤を担当者の実感で確かめる。特に視点が変わる質問での間違い方を記録する。到達点は、任せてよい判断と人が確認すべき判断の線引きである。
- 運用と横展開:確認基準と例外時の手順を整え、隣接する部署に広げる。到達点は、空間判断の一次確認をAIが担い、人は例外対応に集中できる運用である。
目指す状態は、現場の「見て位置関係を判断する」作業の下書きをAIが担い、熟練者の目が要所にだけ使われる体制である。小さく安く始められる可能性があるが、実際の費用は利用形態によって異なる。
今後の展望
DK-VLMは3D点と姿勢を推定して使うため、その推定が崩れる暗所や反射の多い環境では精度が下がる可能性がある。現場導入の鍵は、自社の環境でこの前提がどこまで成り立つかの見極めにある。空間理解が実用水準に近づけば、ロボットやドローンの自律動作を支える基盤にもなりうる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボ、人の遊びから器用さを自習する
米研究チームは、人間の数分の「遊び」を手本にロボットが接触データを自力で集め、器用な手作業を学ぶ枠組みDSPを発表した。強化学習と同等の成功率を490分の1のデータで達成した。
3D制作をコード化するAI基盤が登場
3DCodeVerseは、編集と検証が可能な3Dコンテンツをコーディングエージェントが大量生成する基盤である。200万件規模のデータと自動検証の仕組みを備え、3D制作の内製化を後押しする可能性がある。
視点依存を分離する3D世界モデルが登場
カメラ位置に左右されない「場面の状態」を学習し、将来の3D空間を予測する世界モデルGeoStateが提案された。自動運転の走行データ活用や空間予測の精度向上に直結する成果である。