知覚・予測・計画を一つの世界モデルが統合
P3-WAMは手の3D動作の復元、行動に応じた映像予測、目標に向けた計画を単一モデルで担う。一括学習で3機能とも単独学習を上回り、現場動画の活用や作業自動化への道を広げる。
研究の概要
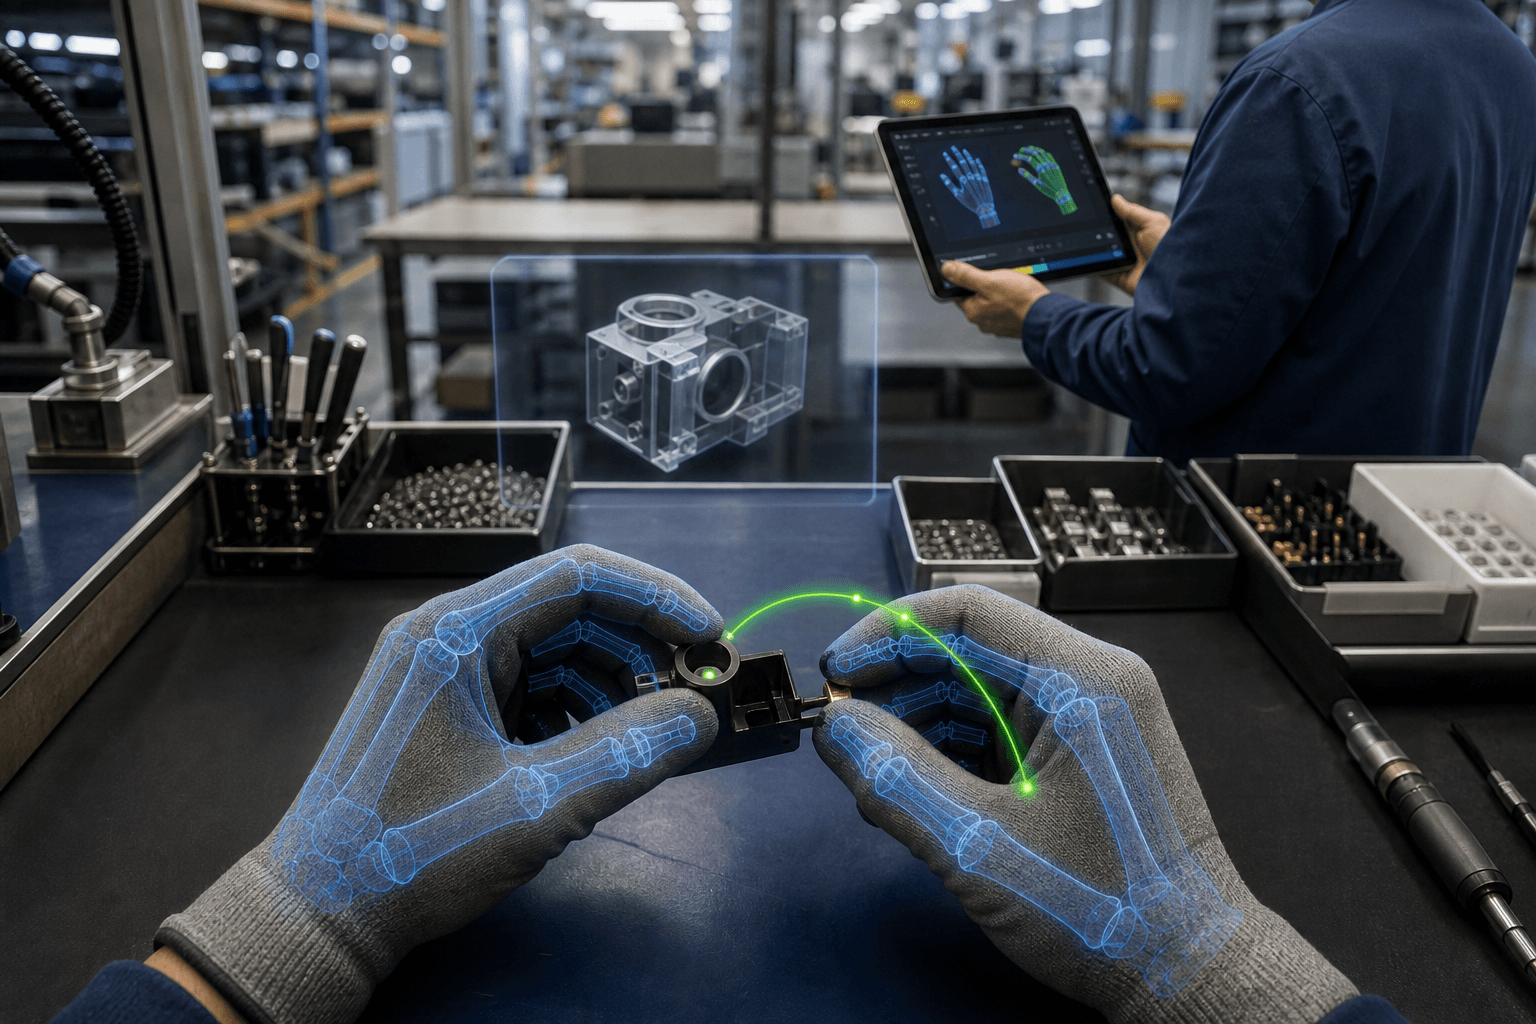
研究チームは、一人称視点の巧緻な手作業を対象とする「世界行動モデル」P3-WAMを発表した。世界行動モデルとは、映像で世界の変化を予測する能力と、ロボットや人の行動を表現する能力を一体化したモデルである。P3-WAMは三つのモードを一つの枠組みで扱う。
第一は「Perceive(知覚)」で、動画から関節を持つ手の動きとカメラの軌跡を3次元で復元する。第二は「Predict(予測)」で、指定された行動をとった場合に映像がどう変化するかを生成する。第三は「Plan(計画)」で、初期画像と言語指示、必要に応じて目標画像を与えると、行動の軌道と、その結果として予想される映像を同時に生成する。
実験では、三つのモードを一緒に学習させた方が、モードごとに単独で学習させた場合より、すべての能力が向上した。計画の質も、視覚言語モデルによる評価で改善した。さらに、3次元の手の復元と行動条件付きの映像予測では、4つのデータセットで専用の比較手法を上回った。目標指向の操作映像でも、映像生成のみの比較手法より、指示への忠実度と動作の進行の自然さが高かった。
しくみをやさしく
土台は、大量の映像で事前学習された動画拡散トランスフォーマーである。拡散モデルとは、ノイズだらけの状態から少しずつ映像を整えて生成する方式を指す。ここに、手の動きを表す「コンパクトで構造化された3D行動表現」を組み込んでいる。
組み込みには「mixture-of-transformers」という構成を使う。基本の重みは映像と行動で共有し、それぞれの性質に合わせた調整部分を別に持つ。加えて、映像と行動が互いに参照し合う双方向の注意機構を備える。たとえるなら、映像担当と動作担当の二人が同じ資料を見ながら、常に相談して作業を進める体制である。
三つのモードを切り替える鍵は「ランダム化されたモダリティの可視性」である。学習時に、映像と3D行動のどちらを条件として見せ、どちらを予測させるかをランダムに変える。映像だけ見せて行動を当てれば知覚、行動を見せて映像を当てれば予測、指示だけから両方を当てれば計画になる。一つの訓練で三つの問題を解く形にしたことが、相互に能力を高め合う要因と考えられる。
ビジネスへの示唆
最も影響を受けるのは、手作業の比重が大きい業務である。たとえば製造業の組立ラインで、熟練者の手順をどう新人に伝えるかという課題がある。自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを問い直す契機になる。
知覚モードは、作業者の頭部カメラ映像から手の動きを3次元で記録する用途に向く。製造の技能伝承、物流の梱包・ピッキング、医療の手技研修では、これまで指導者が横で見て評価していた。動きを数値の軌跡として残せれば、教育担当者の負担と新人の習熟期間という指標に影響しうる。
予測と計画のモードは、ロボットの作業設計に関わる。動かす前に結果の映像を確認できれば、試行錯誤にかかる設備の占有時間や不良発生を減らせる可能性がある。
- 製造・生産技術:標準作業の定着度、教育にかかる時間、手直しの発生
- 物流:ピッキングや梱包の作業品質、新人の立ち上がり
- 医療・介護:手技研修の評価の均質性、指導者の工数
- ロボット開発:現場動画を学習に活かす際のデータ収集の手間
ただし、本論文はあくまで研究成果であり、現場に直ちに導入できる製品ではない。評価は主にデータセットと映像品質に基づく点に留意が要る。
現場での導入イメージ
仮に導入支援に入るなら、次の流れで進める。
- 棚卸し:手作業の中で、属人化していて記録も評価も難しい工程を洗い出す。目指す到達点は、動きの可視化で効果が見込める工程が、関係者の共通認識として絞り込まれた状態である。
- 差し込み先の設計:新しい専用設備を増やさず、既存の作業手順書、教育資料、現場で使う装着型カメラの映像に載せる形を優先する。目指す到達点は、現場の運用を変えずに動画が自然に蓄積される状態である。
- 小さく試す:一部署、数週間の範囲で、熟練者と新人の動きを復元して見比べる。担当者が違いを実感できるかを確かめる。目指す到達点は、現場の指導者が「教育の役に立つ」と判断できる状態である。
- 運用と横展開:評価の基準や映像の取り扱い規程を整え、他の部署や工程に広げる。目指す到達点は、動画から手の動きを評価する手順が標準業務として定着した状態である。
全体として目指すのは、熟練者の手の動きが組織の資産として蓄積され、教育や自動化の判断に継続的に使える状態である。小さく始められる点が、この進め方の利点である。
今後の展望
三つの能力を一つのモデルで高め合えるという知見は、ロボット学習の設計に影響を与えるだろう。人の一人称動画から学び、計画を立て、結果を映像で確認する流れが現実になれば、ロボットの教示にかかる手間を減らせる可能性がある。一方で、実機での安全性や、現場映像に含まれる作業者のプライバシー保護といった課題は残る。導入を検討する企業には、効果検証とあわせた規程整備が求められる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
3D生成物の正誤を説明付きで検証するAI基盤
研究チームは、生成した3Dが依頼どおりかをAIが多視点で検証し、不合格の理由も説明するベンチマークとデータ工程を公開した。検証を生成に組み込むと、全要件の達成率が大きく上がることも示した。
ロボ学習、環境生成と方策が共進化
シミュレーション環境の生成とロボット方策を共に進化させる枠組みCoDAが登場した。方策の失敗を診断して訓練環境を作り、未知条件での成功率を5.3%から27.6%に高めた。
ロボットが少ない試行で環境の癖を学ぶ
スタンフォード大などの研究チームは、摩擦や質量など見えない環境条件を、現場での試行から推定するロボット世界モデルT2-Zを開発した。物体予測誤差は半減し、行動成功率は約2倍となった。