画像生成AI、拡散の動きで高速化
韓国の研究チームが、画像生成AIの計算を間引く際に「どこを残すか」を生成過程の動きから判断する手法DaTMeを提案した。再学習なしで背景や細部の崩れを抑え、高速化と品質の両立を狙う。
研究の概要
SeungJu Cha氏らの研究チームは、拡散モデルによる画像生成を、追加学習なしで効率化する手法DaTMe(Dynamics-aware Token Merging)を提案した。拡散モデルとは、ノイズだらけの画像から少しずつノイズを取り除き、画像を仕上げていく生成AIの方式である。この過程では画像を細かな断片(トークン)に分けて計算しており、数が多いほど計算負荷が高くなる。
トークンマージングは、似通ったトークンを一つにまとめて計算量を減らす訓練不要の高速化策である。課題は、どのトークンをまとめてよく、どれを残すべきかの見極めにある。従来手法は、プロンプト(指示文)に沿った前景領域を優先的に保護していた。しかしこの基準では、指示文で触れられない背景の物体や細かな造作が見落とされ、画像全体の構造的な一貫性が損なわれる問題があった。
研究チームは、重要度を「指示文との関連」ではなく「生成過程でまだ決まりきっていないか」「構造情報を持つか」で測るべきだと主張する。実験はPixArt-αとFLUXという代表的な画像生成モデルで行われ、画像全体で視覚的な忠実度が保たれることが示された。コードは公開されている。
しくみをやさしく
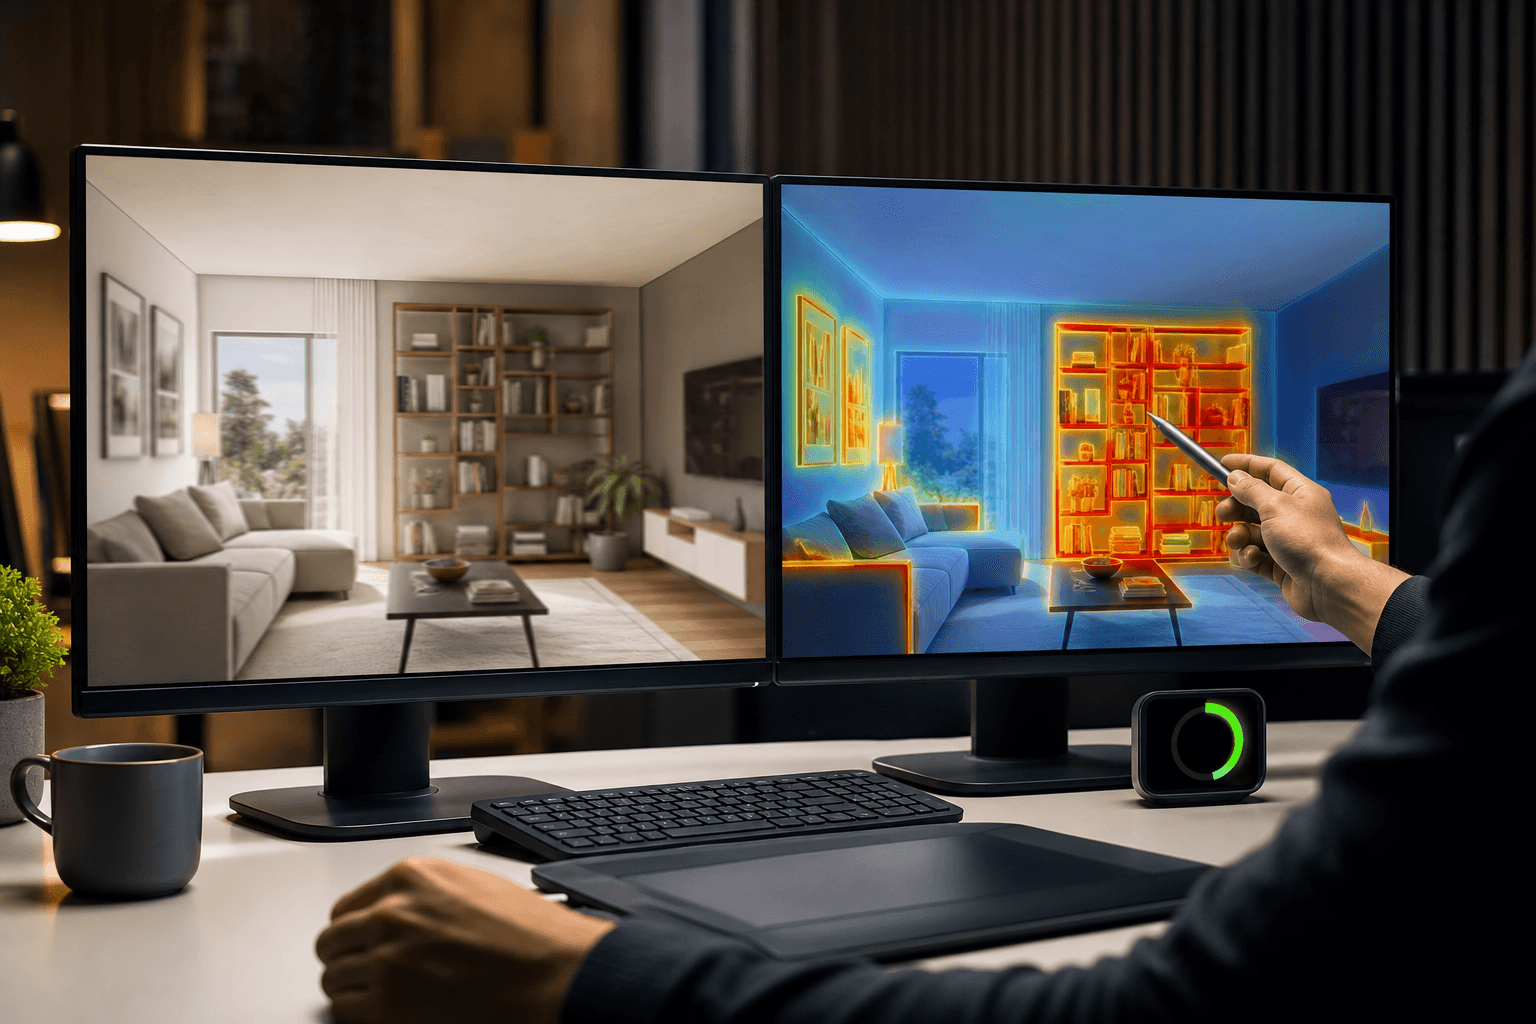
拡散モデルは各ステップで「ノイズを除いた完成画像はこうなるはずだ」という予測を内部で作っている。これがTweedie推定と呼ばれる中間予測である。DaTMeはこの予測を材料に、二つの信号から重要度マップを作る。
一つ目は時間的な信号である。ステップ間でこの予測がどれだけ変化したかを見る。変化が大きい箇所はまだ生成が落ち着いておらず、計算を続ける価値が高い。変化が小さい箇所はすでに確定しつつある。
二つ目は構造的な信号である。予測画像のうち、輪郭や細かな模様のような高周波成分が強い箇所を捉える。ここは削ると見た目が崩れやすい。
この二つをもとに、指定された圧縮率の範囲で各トークンに役割を割り当てる。重要度の高いものは「アンカー」として確実に残す。一方、時間的に安定し、かつ構造的にも平坦なトークンは「安全にまとめられる候補」とする。たとえば無地の壁や空のように、変化が止まり模様も乏しい部分である。書類の要約に例えれば、結論が固まり内容も単調な段落から先に圧縮し、論点が動いている箇所は原文のまま残す考え方である。
ビジネスへの示唆
画像生成を日常業務で回している部署ほど、この種の高速化は自分ごととなる。たとえばEC事業のマーケティング部門では、商品画像の背景違いやバナー案を大量に生成する作業が繰り返される。広告制作では、構図案を多数出して選ぶ工程がある。ゲームや映像のコンセプトアート、建築・不動産のパース制作、アパレルのデザイン試作でも同様である。
問うべきは、自部署で画像を生成・選別する業務は何か、そして誰がどれだけ待ち時間や修正の手間をかけているかである。背景の小物が不自然に崩れる問題は、まさに従来の前景優先型の間引きで起こりやすい。DaTMeはこの崩れを抑えながら計算を減らす方向にあり、動くKPIとして次が考えられる。
- 1枚あたりの生成時間と、案出しのリードタイム
- GPUなど計算基盤のコスト、クラウド利用料
- 修正・やり直しの回数、デザイナーの確認工数
再学習が不要なため、既存モデルの運用に後から足せる点も実務上は大きい。ただし、効果の大きさは用途やモデルにより異なり、自社の画像で確かめる必要がある。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
- 棚卸し:画像生成を使う業務と、待ち時間や計算コストが詰まっている工程を可視化する。目指す到達点は、高速化の恩恵が大きい業務と、品質を落とせない業務を区別できている状態である。
- 差し込み先の設計:新しいツールを増やさず、いま使っているPixArtやFLUX系の生成基盤の推論部分に、公開コードを組み込めるかを検討する。目指す到達点は、現行のワークフローを変えずに、裏側の計算だけが軽くなっている状態である。
- 小さく試す(PoC):一部署、数週間の範囲で、従来設定と並べて生成し、背景や細部の崩れの有無を担当者の目で比較する。目指す到達点は、現場の実感として「この圧縮度なら使える」という許容ラインが言語化されている状態である。
- 運用と横展開:許容できる圧縮率や確認基準を文書化し、用途ごとに設定を使い分けて他部署へ広げる。目指す到達点は、品質基準に基づき圧縮率を選べる運用が定着している状態である。
全体として目指すのは、画像の品質を保ったまま生成の待ち時間とコストを下げ、試行回数を増やせる制作現場である。
今後の展望
今回の手法は、拡散の進み具合そのものを判断材料とした点に特徴がある。ほかの生成モデルや動画生成への応用が期待される一方、実運用では高い圧縮率での品質や、ブランド画像のような厳密さが求められる用途での検証が欠かせない。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
3D生成物の正誤を説明付きで検証するAI基盤
研究チームは、生成した3Dが依頼どおりかをAIが多視点で検証し、不合格の理由も説明するベンチマークとデータ工程を公開した。検証を生成に組み込むと、全要件の達成率が大きく上がることも示した。
ロボ学習、環境生成と方策が共進化
シミュレーション環境の生成とロボット方策を共に進化させる枠組みCoDAが登場した。方策の失敗を診断して訓練環境を作り、未知条件での成功率を5.3%から27.6%に高めた。
知覚・予測・計画を一つの世界モデルが統合
P3-WAMは手の3D動作の復元、行動に応じた映像予測、目標に向けた計画を単一モデルで担う。一括学習で3機能とも単独学習を上回り、現場動画の活用や作業自動化への道を広げる。