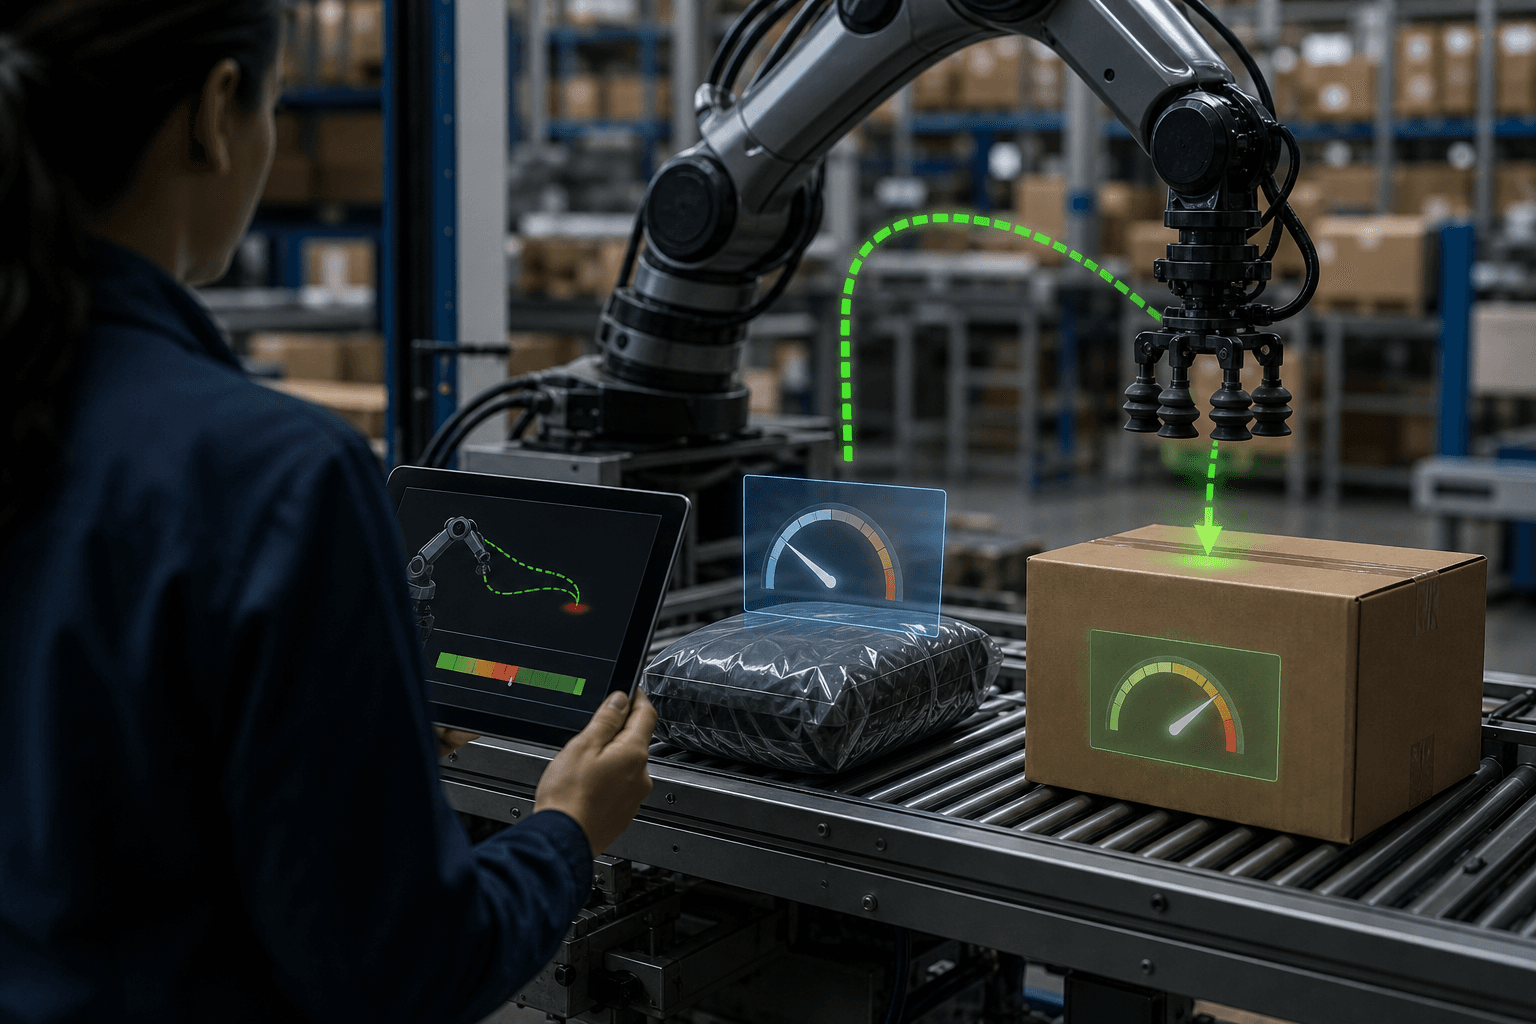
ロボ学習、環境生成と方策が共進化
シミュレーション環境の生成とロボット方策を共に進化させる枠組みCoDAが登場した。方策の失敗を診断して訓練環境を作り、未知条件での成功率を5.3%から27.6%に高めた。
研究の概要
ロボットの訓練用環境を生成AIで自動構築する技術は、すでに実用段階に近づいている。しかし、物理的に正しい環境が、訓練に役立つ環境であるとは限らない。方策がすでにこなせる状況を大量に作っても、学習は進まないからである。
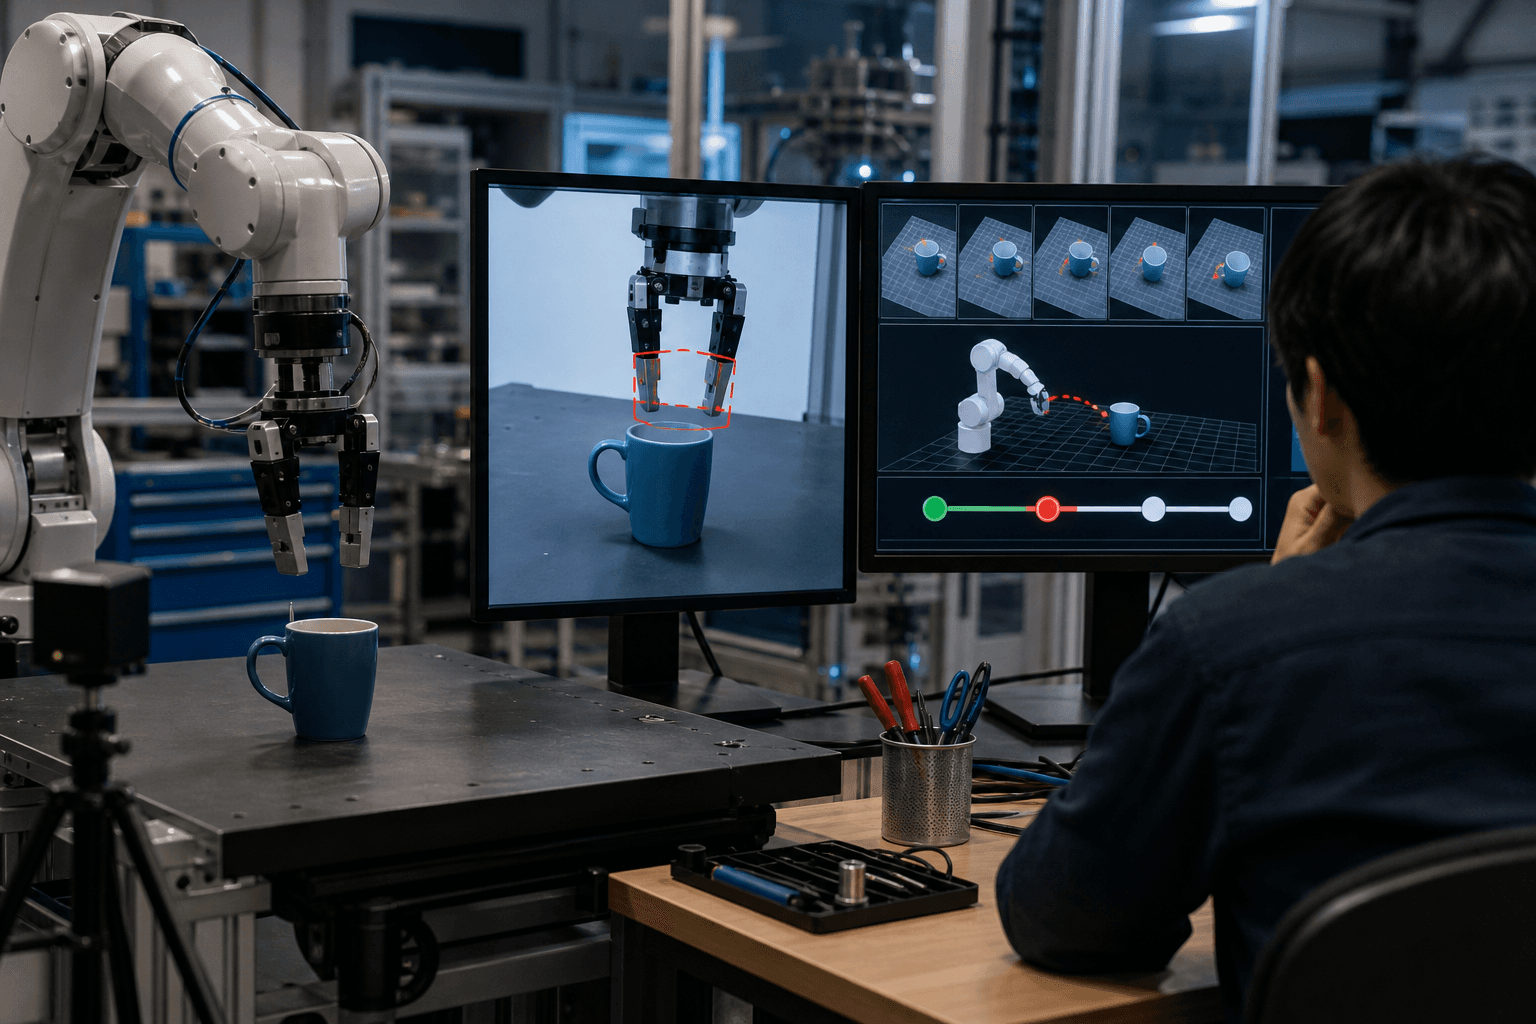
Tianjiao Yuらの研究チームが提案したCoDAは、この課題に対し、シミュレーションのデータ生成エンジンと行動方策を「共進化」させる枠組みである。方策がどこで失敗するかを見極め、その弱点を突く環境と、克服を助ける教師信号を自動で供給する。
評価は4種類の操作タスク群で行われた。教師あり微調整(SFT)後に5.3%だった未知条件(分布外)での成功率は、CoDAにより27.6%へ上昇した。同じ生成予算で最も強い閉ループ型の比較手法を9.5ポイント上回っている。ベンチマークのLIBERO-Proでは、15ラウンドの生成と訓練で、位置の摂動下の成功率が25%から84%、指示文の摂動下が1%から76%に向上した。
しくみをやさしく
中核は、環境の作り方、方策の失敗、学習の進み具合を一つにまとめた「異種メモリ」である。たとえば現場の新人教育に例えると、作業ミスの記録、練習メニュー、上達の記録を一冊の帳面で管理し、次の練習内容を決めるイメージである。
手順は次の通りである。まず視覚言語モデルが「批評役」として、方策の失敗映像から原因を診断する。診断は検証を経てメモリに登録され、二種類のプログラムへ変換される。一つは同じ難しさを再現する環境生成プログラム、もう一つは克服を助ける訓練プログラムである。
さらにText2potentialという手法が、診断の文章を段階的なポテンシャル(進捗の点数)に変換する。ロボットの動作は複数の動きをまとめた「アクションチャンク」単位で価値を学習するが、成功か失敗かだけの報酬では、途中経過が評価されず学習が進みにくい。段階ごとの点数を与えれば、途中の前進に細かな手応えを与えられる。しかも標準的な報酬整形の前提のもとで、タスク本来の最適方策は変わらないと理論的に保たれる。点数稼ぎに走る副作用を抑えられる点が要点である。最後に、測定した学習の進み具合が次の生成とプログラム改良を導く。
ビジネスへの示唆
恩恵が大きいのは、現場で毎日同じ作業が繰り返される領域である。物流倉庫のピッキング、工場の部品組付けや仕分け、食品工場の盛り付けなどが該当する。こうした現場では、箱の位置のずれや言い換えられた作業指示といった「想定外」でロボットが止まり、担当者が復旧に手を取られている。
読者に問いたいのは、自部署でロボットや自動化設備が止まる原因は何か、その復旧に誰がどれだけ手をかけているか、という点である。位置のずれや指示の揺れに弱いという研究結果は、まさにこの停止要因に対応する。
影響を受けやすい部門と、動く可能性のある指標は次の通りである。
- 生産技術・設備保全部門:ティーチング(動作の教え込み)の手間、停止からの復旧時間
- 物流オペレーション部門:例外処理の件数、有人介入の頻度
- 品質保証部門:条件変動時の不良率のばらつき
- 研究開発部門:新しい作業への立ち上げ期間
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:ロボットが止まる、人が手直しする場面を洗い出し、位置ずれ、物体の違い、指示の揺れなどに分類する。到達点は、どの失敗を優先して潰すかが現場の言葉で共有された状態である。
-
差し込み先の設計:新しい基盤を一から作らず、既存のシミュレータと現在使っている方策の学習工程に、失敗診断と環境生成の仕組みを載せる。到達点は、現行の運用を変えずに、失敗記録が自動で次の訓練に反映される経路が通ることである。
-
小さく試す(PoC):一つのライン、一種類の作業に絞り、数週間単位で回す。到達点は、現場担当者が「以前止まっていた場面で止まりにくくなった」と実感できることである。
-
運用と横展開:効果の判定基準と、失敗診断の確認ルールを整え、他の作業や拠点へ広げる。到達点は、診断の妥当性を人が点検できる体制のもとで、改善が継続的に回ることである。
全体として目指すのは、ロボットの失敗が熟練者の手作業の調整ではなく、自動で次の訓練の材料になる状態である。初期投資は、既存環境を活かせば小さく・安く始められる可能性がある。
今後の展望
留意点もある。実験の中心はシミュレーションであり、実機への移行では、見た目や物理特性の差を埋める検証が別途必要になる。視覚言語モデルの診断が誤れば、的外れな訓練を生むため、診断の検証工程が運用上の鍵を握る。
それでも、環境を大量に作る段階から、効く環境を選んで作る段階へ移った意義は大きい。ロボット導入で課題となる現場ごとの個別調整の負担を、データの自動生成で軽くできる可能性がある。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
3D生成物の正誤を説明付きで検証するAI基盤
研究チームは、生成した3Dが依頼どおりかをAIが多視点で検証し、不合格の理由も説明するベンチマークとデータ工程を公開した。検証を生成に組み込むと、全要件の達成率が大きく上がることも示した。
知覚・予測・計画を一つの世界モデルが統合
P3-WAMは手の3D動作の復元、行動に応じた映像予測、目標に向けた計画を単一モデルで担う。一括学習で3機能とも単独学習を上回り、現場動画の活用や作業自動化への道を広げる。
ロボットが少ない試行で環境の癖を学ぶ
スタンフォード大などの研究チームは、摩擦や質量など見えない環境条件を、現場での試行から推定するロボット世界モデルT2-Zを開発した。物体予測誤差は半減し、行動成功率は約2倍となった。