画像検証AI、採点式で複雑な指示の合否判定を精緻化
清華大学系などの研究チームが、複雑な指示を部品に分解し点数で評価する画像検証AI「OmniVerifier-C1」を発表した。合否だけの従来型を上回り、規則に縛られた世界のシミュレーションにも応用できる点が重要である。
研究の概要
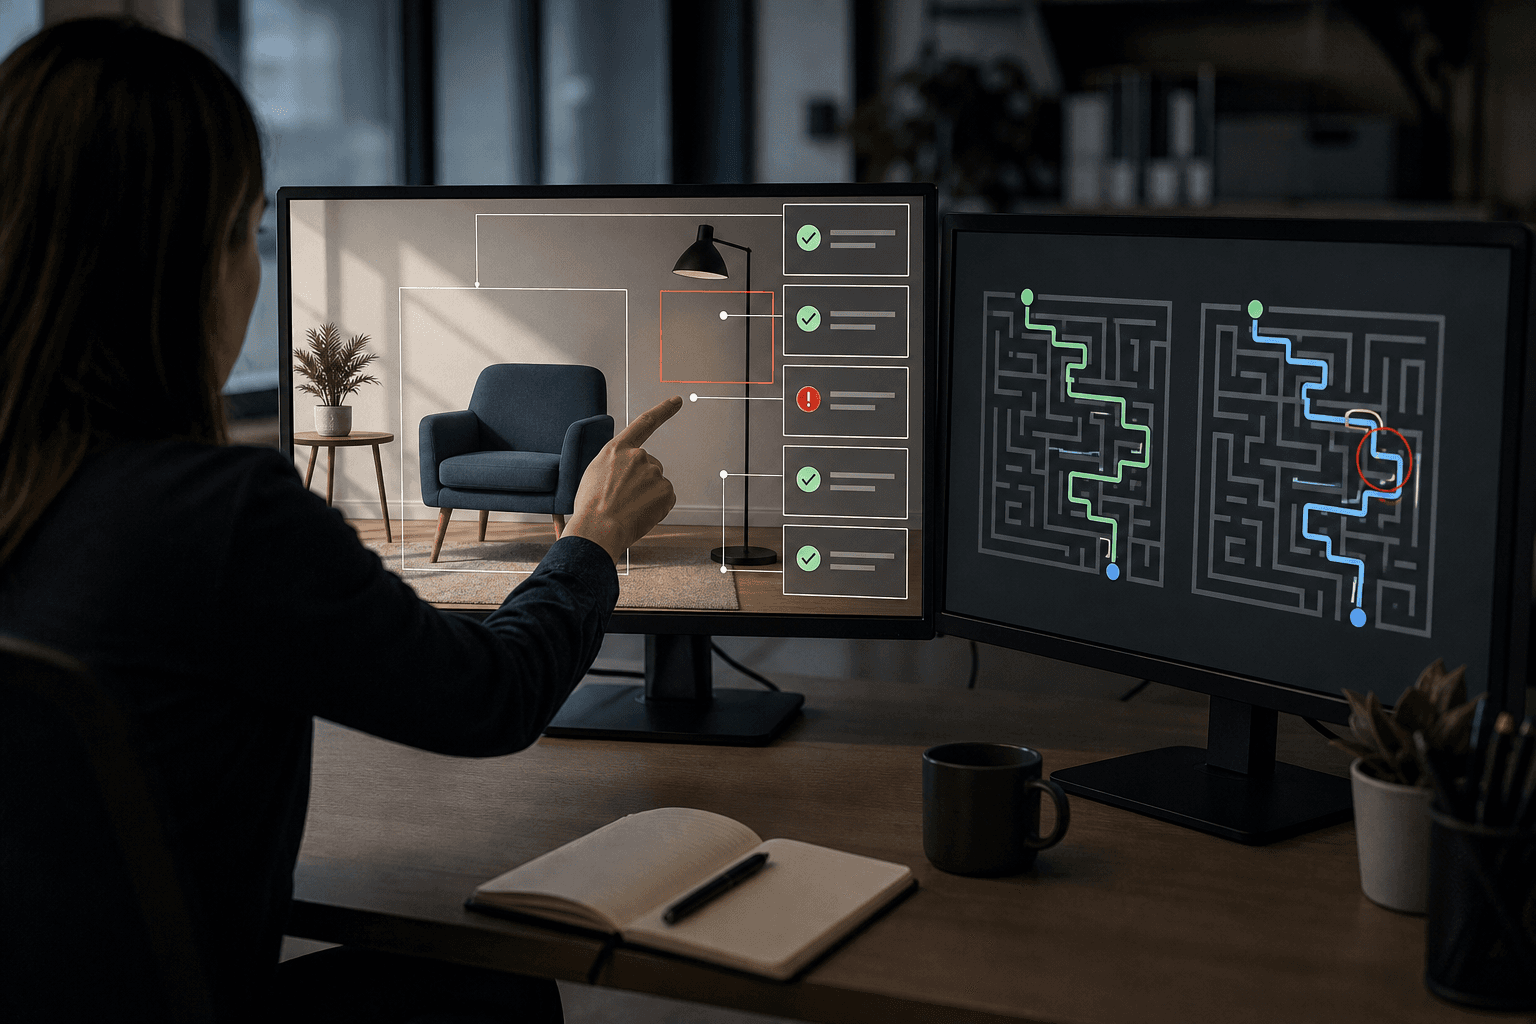
生成AIが作った画像が、依頼どおりかどうかを自動で判定する「視覚検証器(ビジュアル・ベリファイア)」は、マルチモーダルAIの信頼性を左右する基盤技術である。従来の検証器の多くは「正しい/誤り」の二値判定しか返さなかった。複数の条件が重なる複雑な依頼では、どこが違うのかが分からず、改善の手がかりにならないという弱点があった。
研究チームはこの課題に対し、複雑なプロンプトや環境ルールを細かな構成要素へ自動分解し、全体の整合度に連続的な点数(ポイントワイズ・スコア)を付ける検証器を提案した。出力が構造化され解釈しやすいため、訓練に使っていない領域の評価タスクでも汎化性能が向上したと報告している。
さらに、明示的なルールの下で生成モデルに世界の模擬(シミュレーション)や推論を行わせる「ルール支配型の世界モデリング」へ対象を広げた。正解画像が得られる場合には、2枚の画像を比べて評価するペアワイズ方式のほうが、単独採点より正確な批評を出せることを理論的に示した。迷路や数独といった構造化タスクでも有効性を確認している。
しくみをやさしく
仕組みは、採点者が答案を採点する場面に似ている。「赤い車が青い家の左にある」という依頼なら、検証器はまず「車は赤いか」「家は青いか」「車は家の左にあるか」といった小さな問いに分けて個別に判定する。その結果を踏まえ、全体として依頼にどれだけ合致しているかを点数で示す。合否だけでなく、どの条件で失点したかが分かる点が特徴である。
訓練には「分離型強化学習(Decoupled RL)」を用いる。小さな問いごとの二値判定と、全体の整合度スコアを同時に最適化する手法である。局所的な正誤で正確なフィードバックを与えることで細部を見る力を育て、それが全体スコアの信頼性を支える土台になるという設計である。
ペアワイズ方式は、目標となる正解画像と生成画像を並べて見比べる方法である。基準があるため、絶対的な点数を付けるより差異を捉えやすい。迷路なら「正解の経路と比べてどこで外れたか」を判定できる。
ビジネスへの示唆
恩恵が大きいのは、複数の条件を同時に満たす必要のある画像や図面の確認業務である。たとえばEC・広告部門では、商品画像が「背景は白、ロゴは右上、商品は中央」といった掲載規定を満たしているかを毎日確認している。この作業を誰がどれだけの時間をかけて担っているかが、自部署で検討する際の出発点になる。
製造業の品質保証部門では、生成した設計案や検査用の合成画像が仕様どおりかの確認に応用できる可能性がある。ルールが明示された業務ほど、条件ごとの採点と相性がよい。動く指標は次のとおりである。
- 広告・EC部門:素材の差し戻し率、審査にかかるリードタイム
- 品質保証部門:仕様逸脱の見逃し率、目視確認の工数
- 生成AI運用部門:出力の再生成回数、人手による修正の頻度
問うべきは「自部署で、複数条件の確認に人手を割いている業務はどれか」である。合否だけでなく失点箇所が分かれば、修正指示をAIに自動で返す循環も組みやすくなる。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:画像や図面の確認業務のうち、チェック項目が明文化されているものを洗い出す。差し戻しが多い項目や、担当者の経験頼みの判断を可視化する。到達点は、検証器に任せられる業務と人が残す業務の線引きが共有されることである。
-
差し込み先の設計:新しいツールを増やさず、既存の画像生成フローや審査ワークフローの最後段に「条件別チェック」を挟む形を優先する。社内の掲載規定や仕様書を条件リストに置き換える。到達点は、現行の運用を変えずに採点結果が審査画面に表示される状態である。
-
小さく試す(PoC):一部署、数週間の範囲で実施する。担当者が「どの条件で落ちたかが分かり助かる」と実感できるか、人の判断とのずれはどこかを確かめる。到達点は、現場の納得感と改善すべき条件の特定である。
-
運用と横展開:合格ラインや人による再確認の基準を整え、他部署の規定へ広げる。到達点は、確認業務の判断基準が属人的でなくなり、条件単位で継続的に改善できる状態である。
全体として目指すのは、AIの生成物を条件ごとに自動で点検し、人は例外判断に集中できる体制である。
今後の展望
論文は、生成モデルから構造化された世界モデリングのエージェントへ進むには、正確なペアワイズ型の視覚検証器が欠かせないと結論づける。迷路や数独は小さな題材だが、手順やルールのある業務のシミュレーションへ広がる余地がある。一方で、検証器の判定が実務の基準に合うかは、各社の規定で確かめる必要がある。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
機械学習開発を自律遂行する35Bモデル登場
中国の研究チームが、機械学習の実験を自律的に繰り返す35Bのエージェント型モデル「MLExpert」を開発した。MLE-Bench Liteのメダル獲得率は37.9%から72.7%に向上し、データ分析業務の自動化に道を開く。
動画生成AI、必要な部分だけ磨き1.5倍速に
研究チームは、動画生成AIが各部分の仕上がりを見極め、完成した部分の計算を途中で打ち切る手法を提案した。品質を保ったまま1.5倍超の高速化を示し、リアルタイム動画の運用コスト低減につながる。
顧客現場でのAI納品、評価基準が登場
導入現場の技術者が担う顧客向けAI納品を測る評価基準「FDE-Gym」が公開された。最良モデルでも全95課題中14課題の解決にとどまり、仕様書どおりの作業と実務の隔たりが浮き彫りとなった。