AI×マーケティング
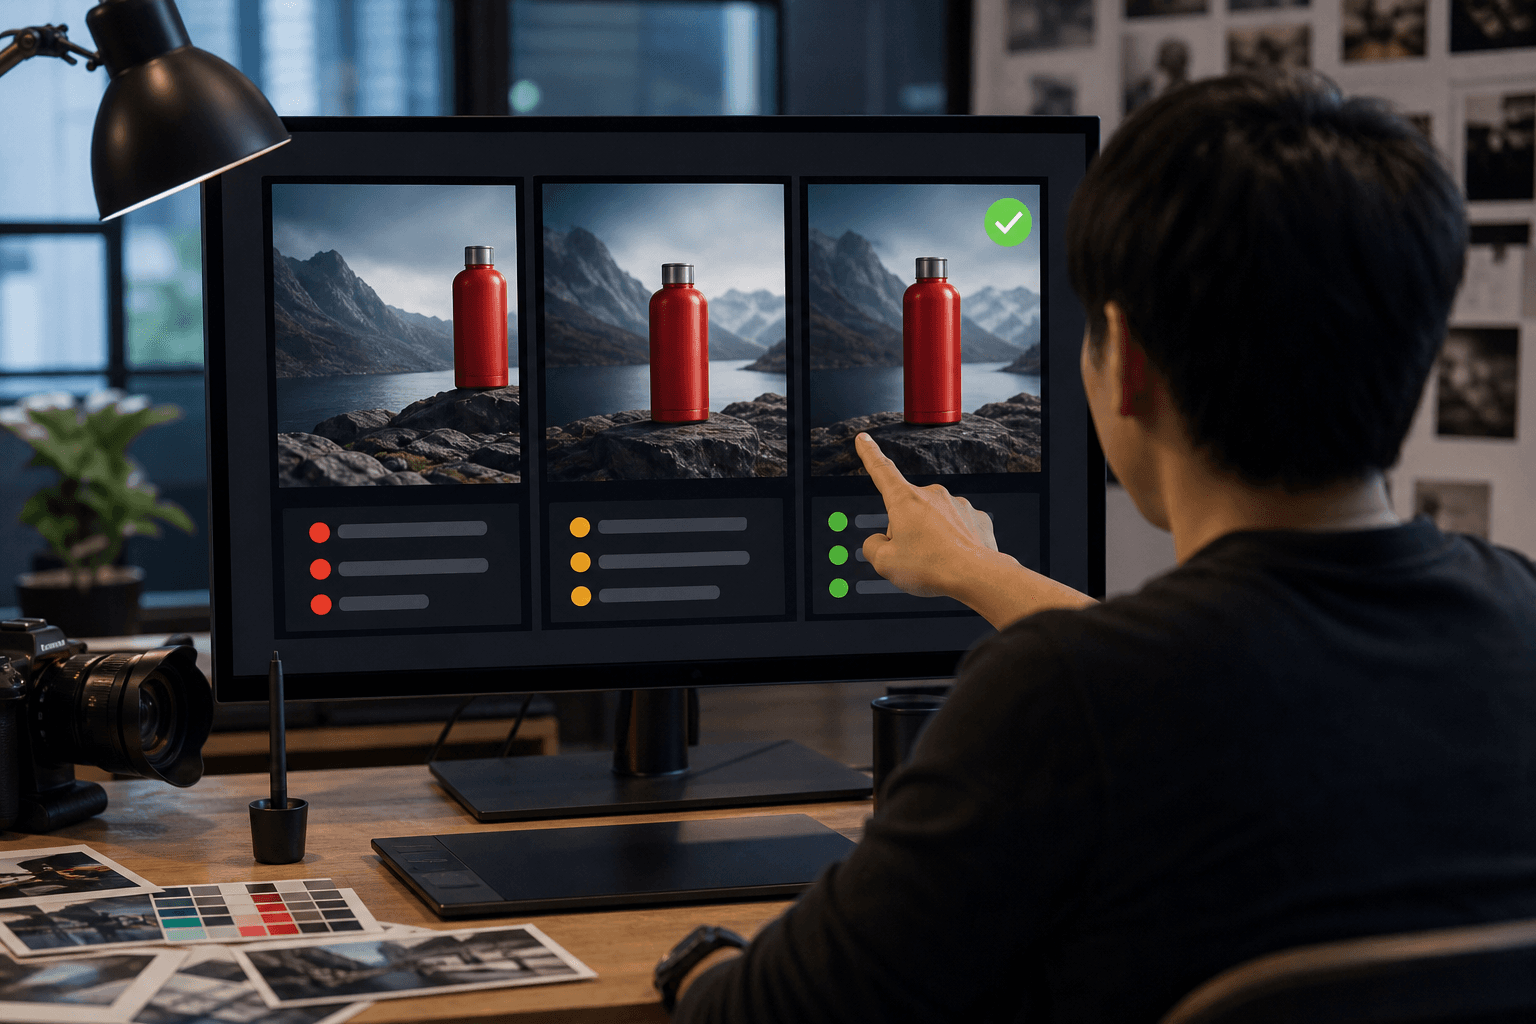
画素拡散AI、敵対的学習で細部を復元
米アドビなどの研究チームは、画素拡散モデルに敵対的学習を後付けし、構造を変えず画像の微細な質感を回復させる手法を示した。生成画像の品質向上を低コストで狙える点が注目される。
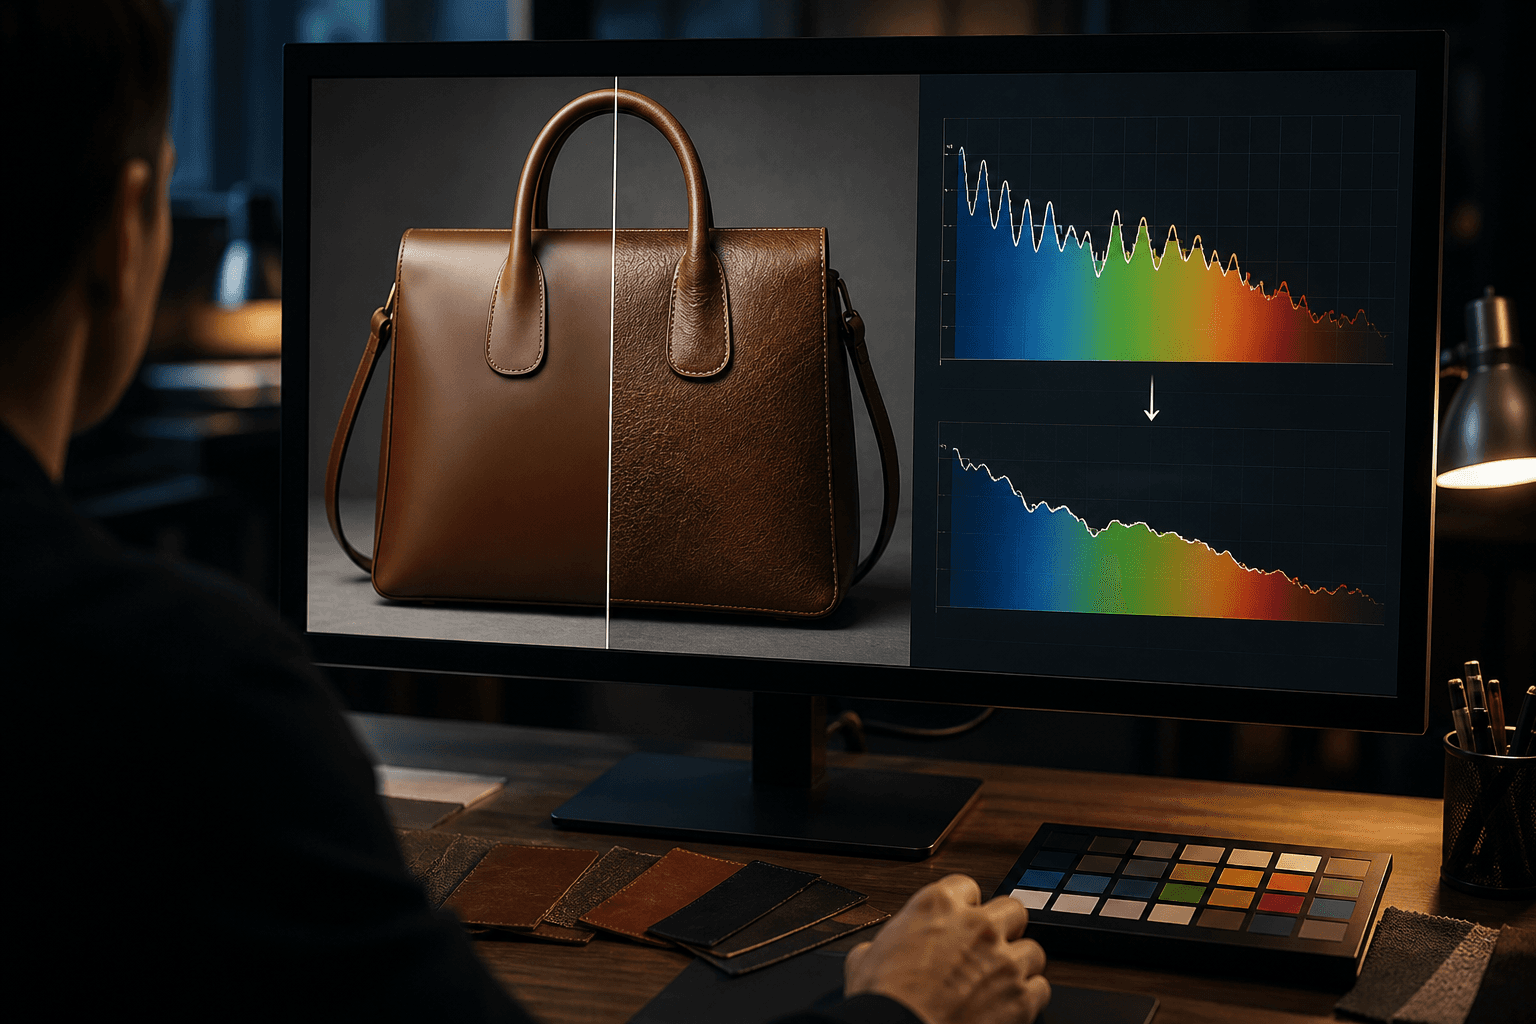
米アドビなどの研究チームは、画素拡散モデルに敵対的学習を後付けし、構造を変えず画像の微細な質感を回復させる手法を示した。生成画像の品質向上を低コストで狙える点が注目される。
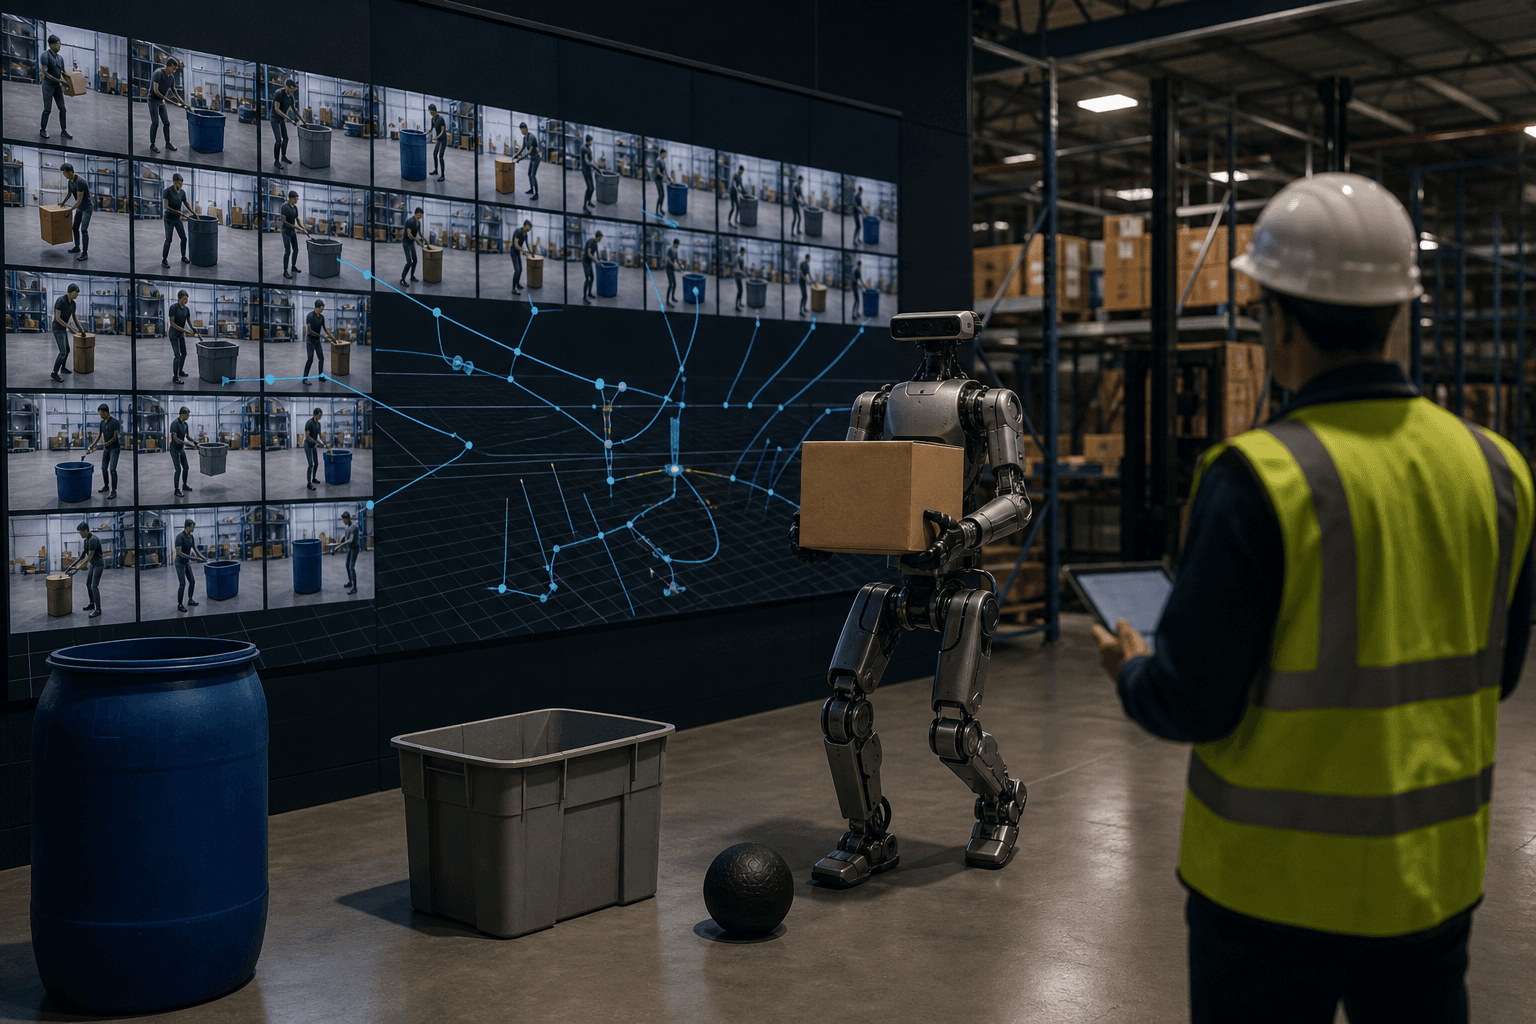
米研究チームが、少数の実映像から数百本の多様な動画を生成しヒューマノイドに物体搬送を学習させる手法PRISMを開発した。実機での追加調整は不要で、物流現場の導入コスト低減につながる。
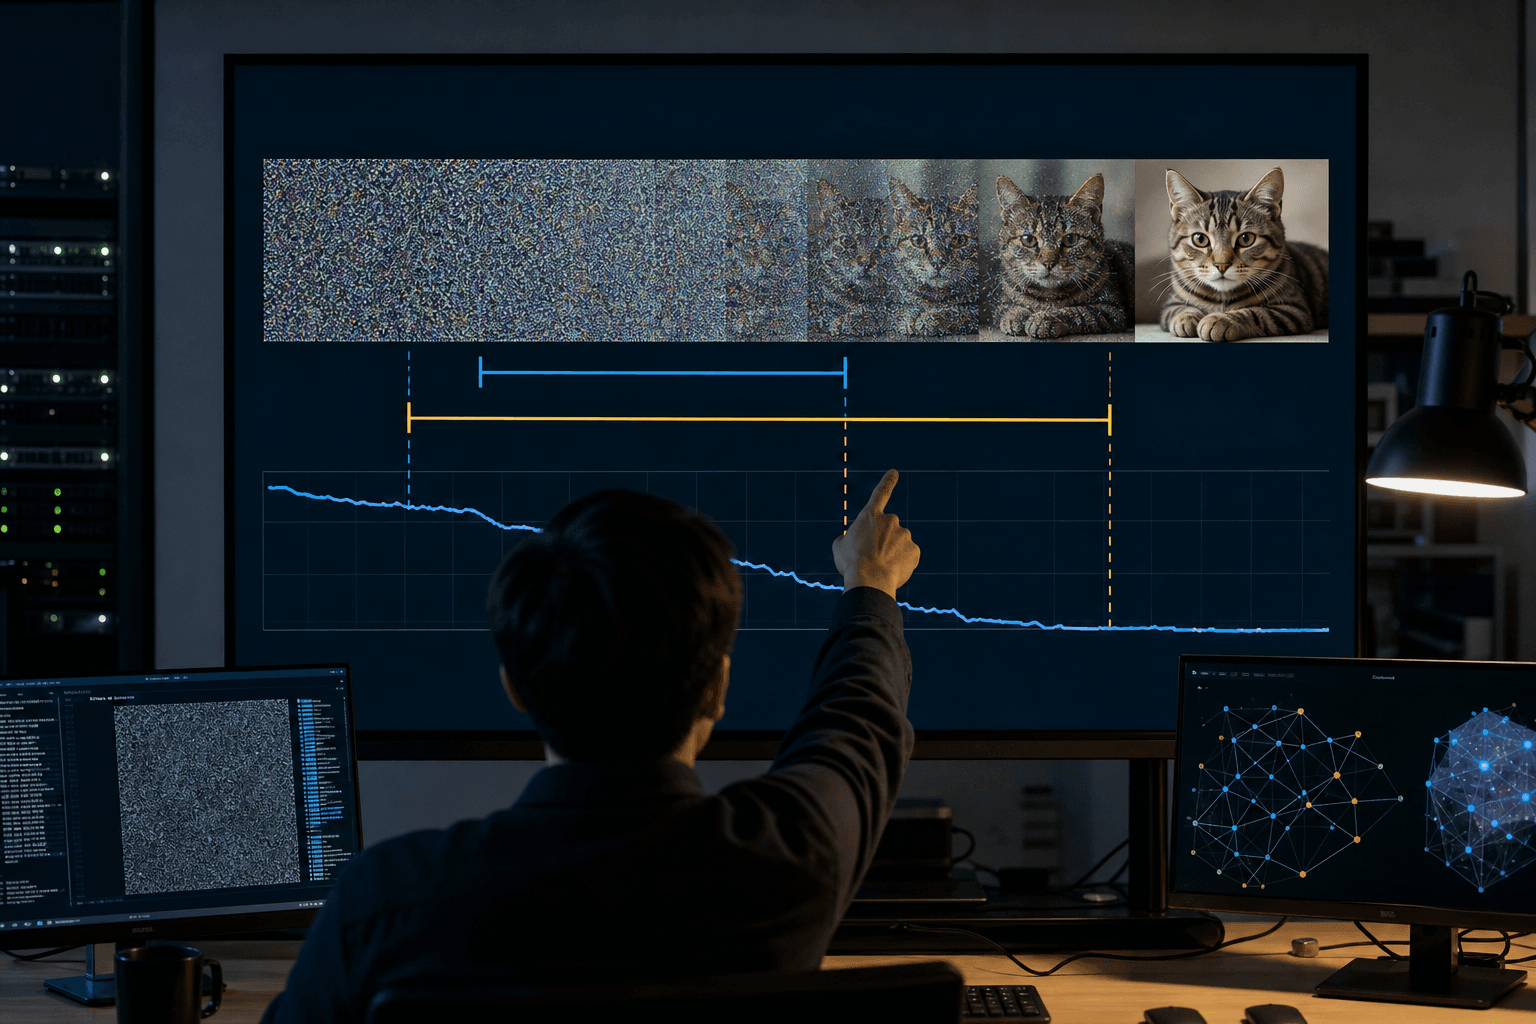
生成モデルで意味クラスが確定する時期と、局所的な文脈だけでは生成できなくなる時期が重なる理由を、理論的に証明した研究が登場した。モデル設計や推論効率の指針となる。
韓国の研究チームは、複数視点の画像から粗い3D表現を内部で組み立ててから回答するMLLM「Imagine3D-LLM」を発表した。精密な幾何情報に頼らず、空間推論で既存手法を上回った。
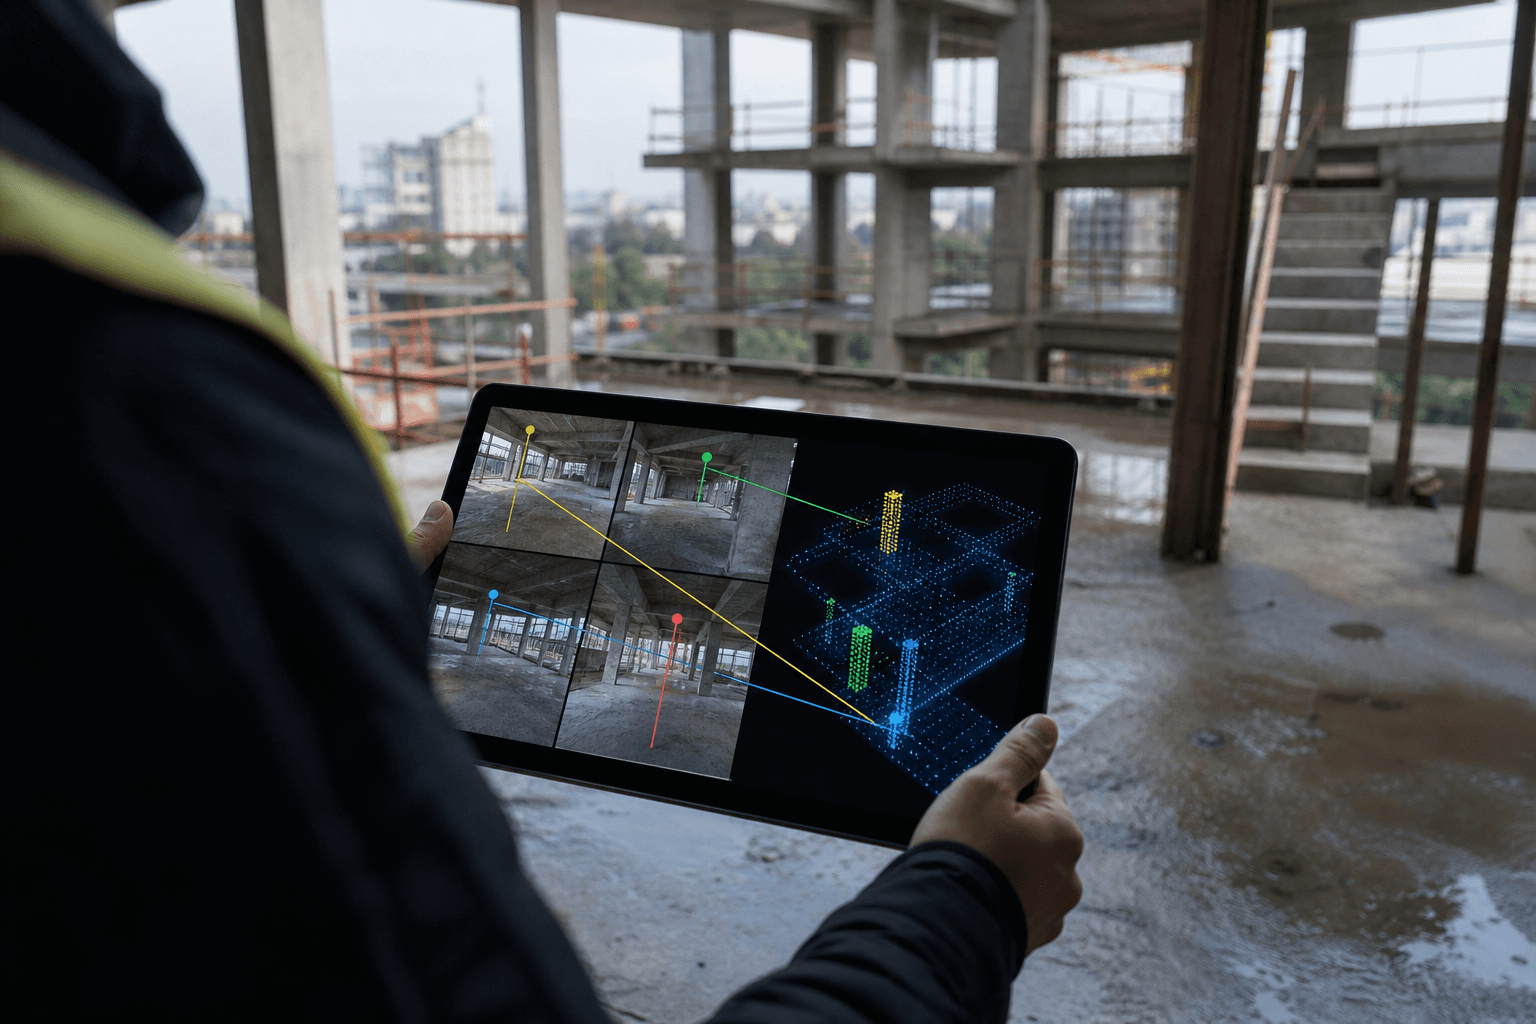
ロボットが基盤モデルの助言で既存の短い技能を試し、成功例を学習に回して失敗を自ら克服する手法が登場した。人手の実演なしに現場で性能を高められる点が、導入費用の抑制につながる。
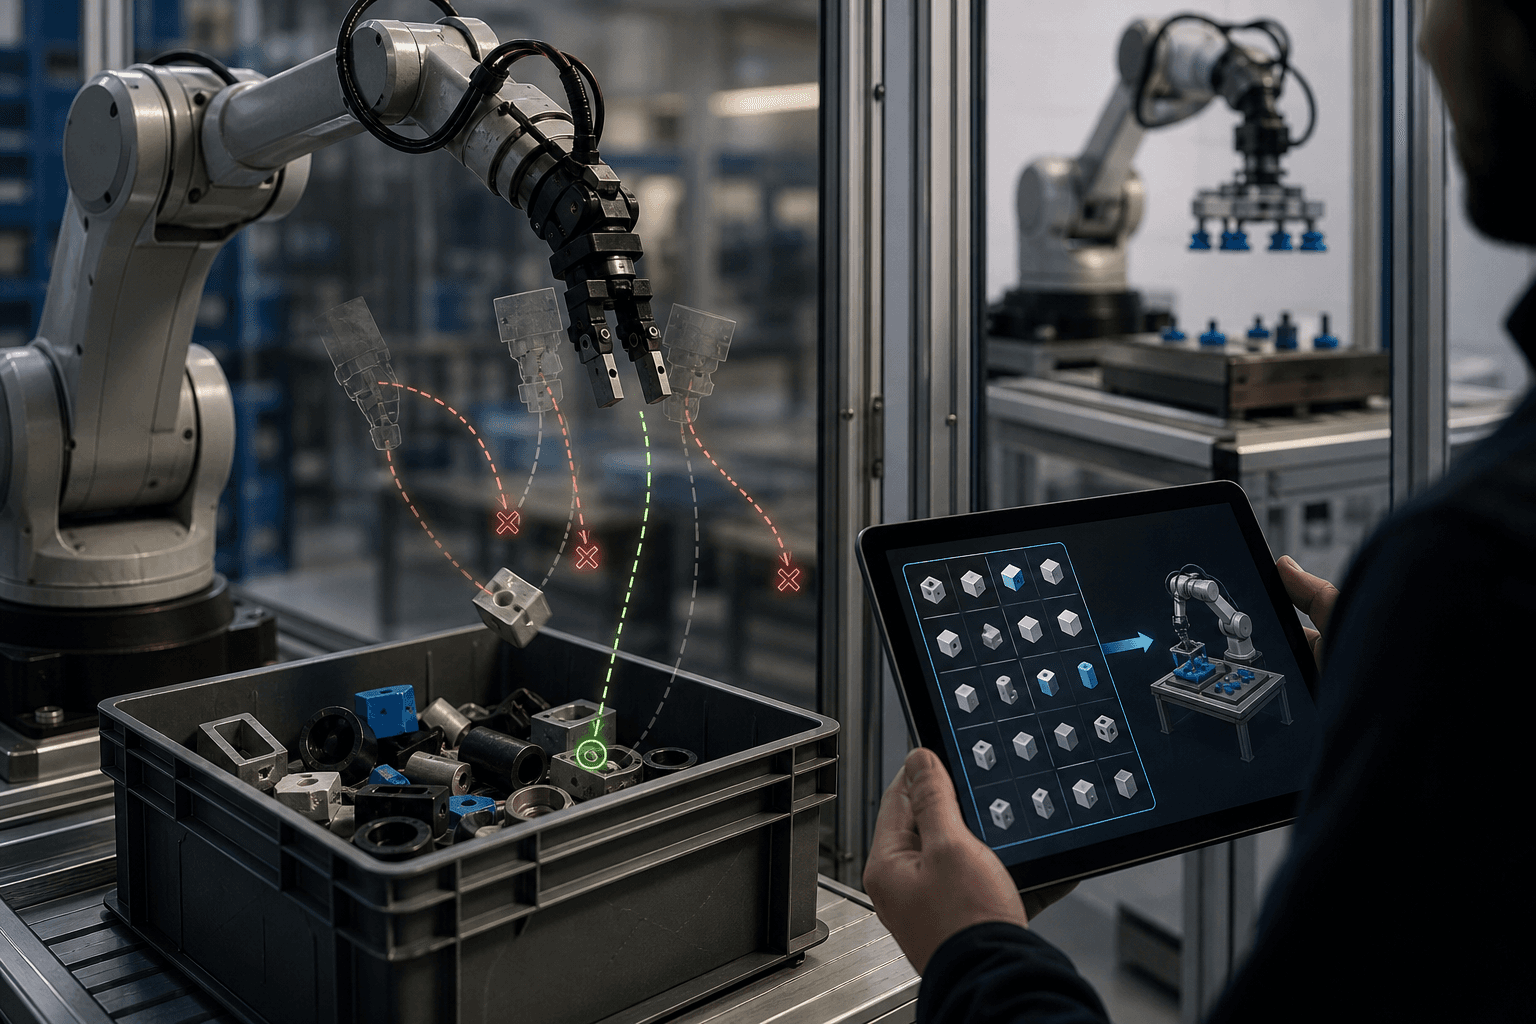
米研究チームが、点の指定だけで3D形状を重複も隙間もない部品に分割する手法Point2Partを開発した。部品間の整合性を従来比で一桁改善し、設計や制作の工程効率化に道を開く。
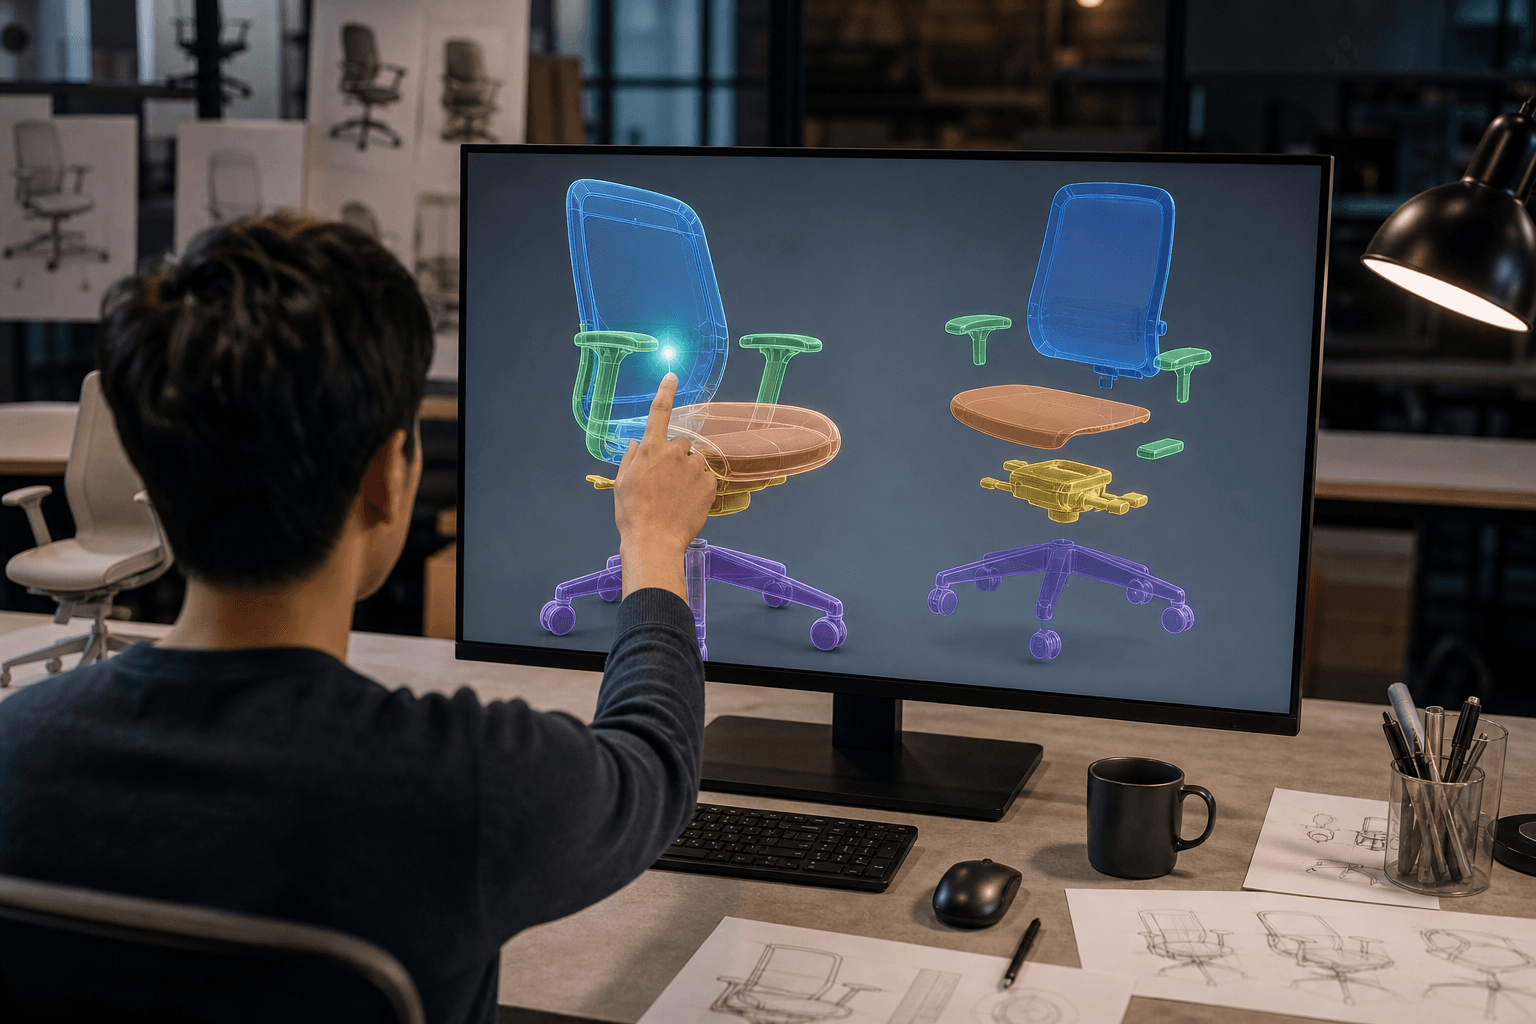
米研究チームは、外乱の時間変化を潜在状態として統計的に学習する適応制御を開発した。液体揺動を伴う車両実験で従来手法を上回り、物流や製造現場の搬送安定化に道を開く成果である。
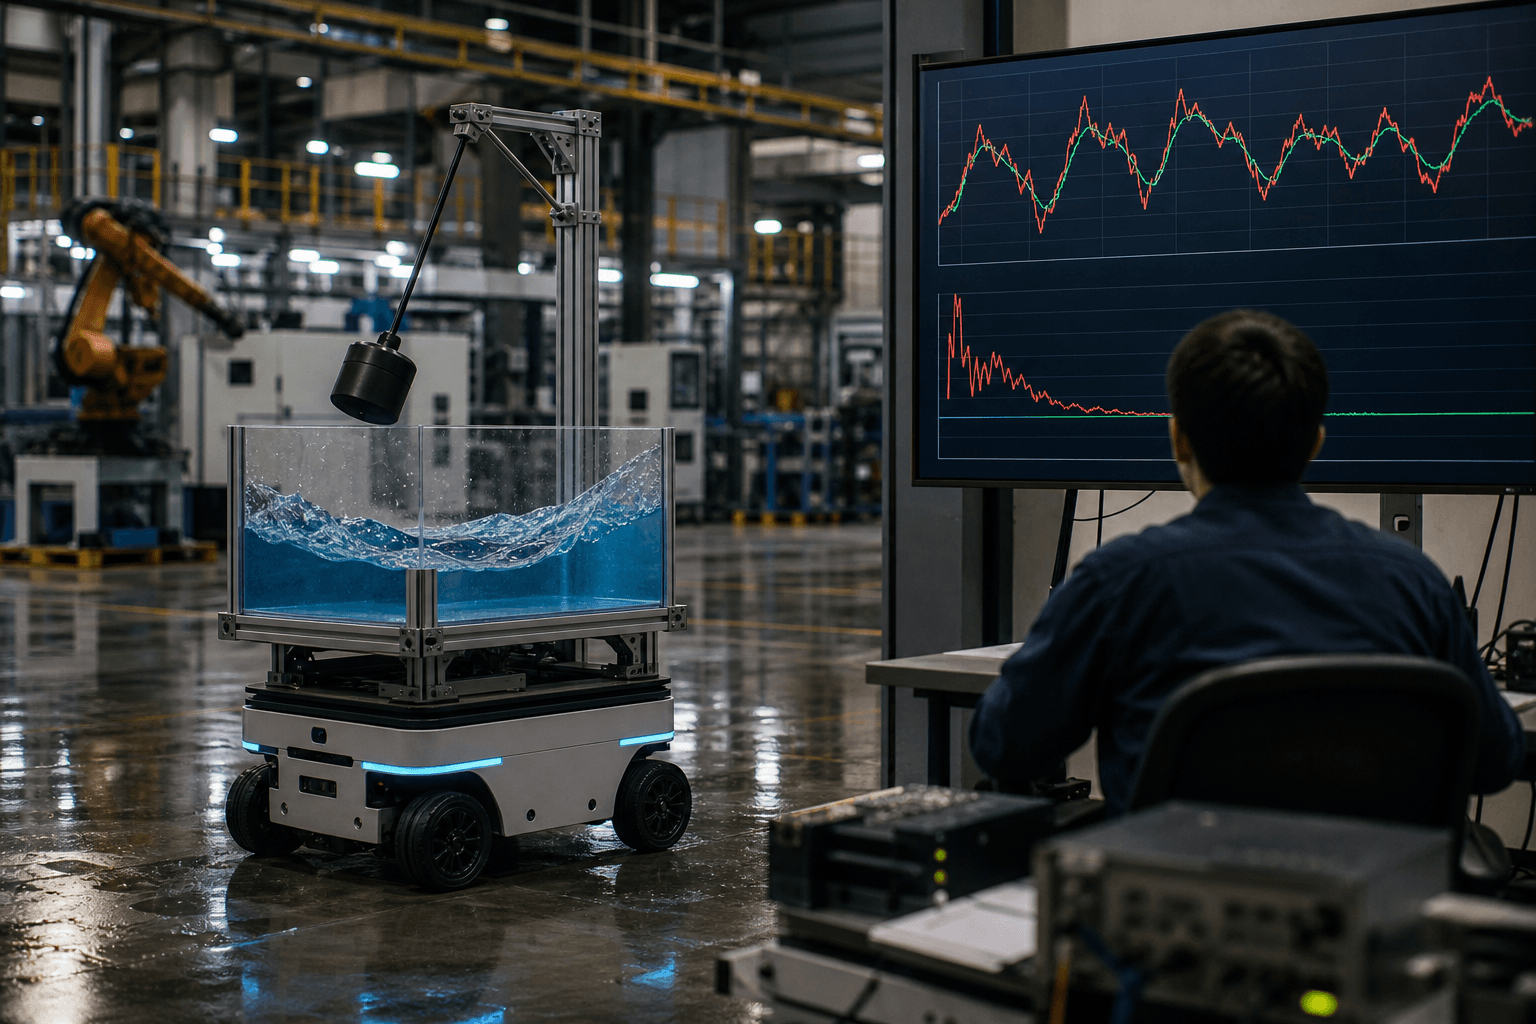
LLMエージェントの実行中にトークン消費量を予測する手法TokenCastが提案された。追加のLLM呼び出しなしで予測を更新し、予算制御でトークンを21.3%削減。運用コストの管理手段として注目される。
研究チームが、登場人物や伏線を構造化して追跡する学習不要の枠組みNstAgentを提案した。10万語規模でも整合性と文章品質が低下せず、出版・映像業界の制作工程に影響し得る。
研究チームが、画像生成AIを1回の推論で動かす学習枠組みMGFlowを発表した。FLUX.2 klein 4Bを1段階化し、4段階の元モデルを主要指標で上回り、生成コスト削減の道を開く。
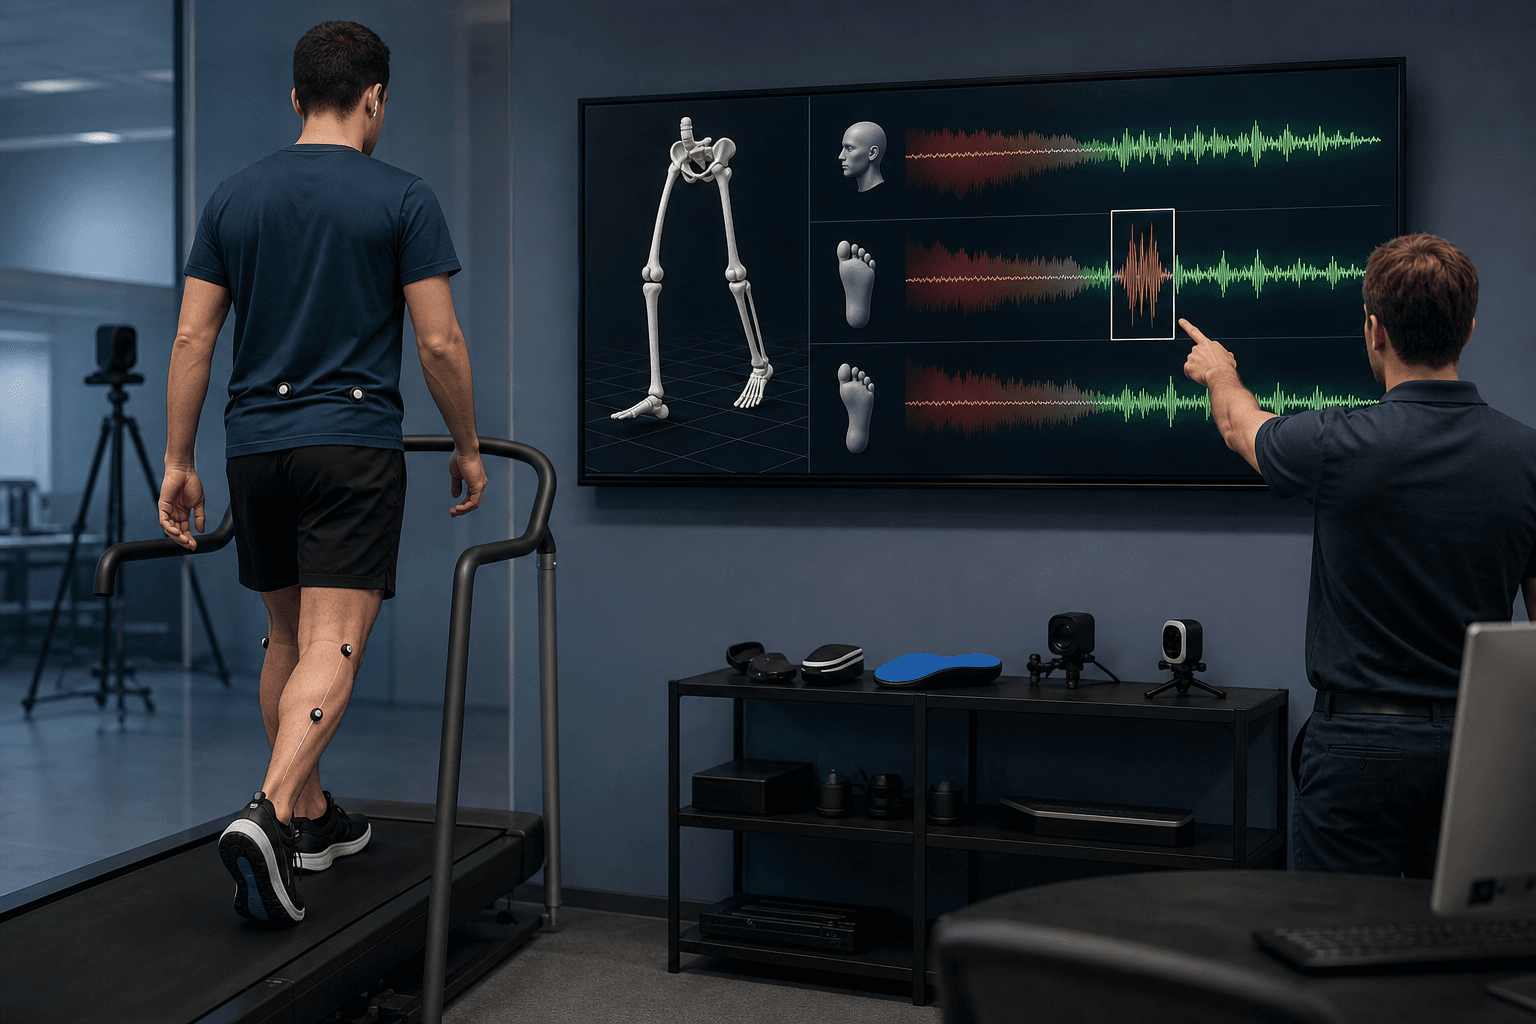
英国などの研究チームが、イヤホンとスマートインソールの慣性センサーから下半身の3D姿勢を推定する際、各信号の信頼度を学習して重み付けする手法を提示した。故障時の精度低下を抑え、実用化の壁を下げる成果である。
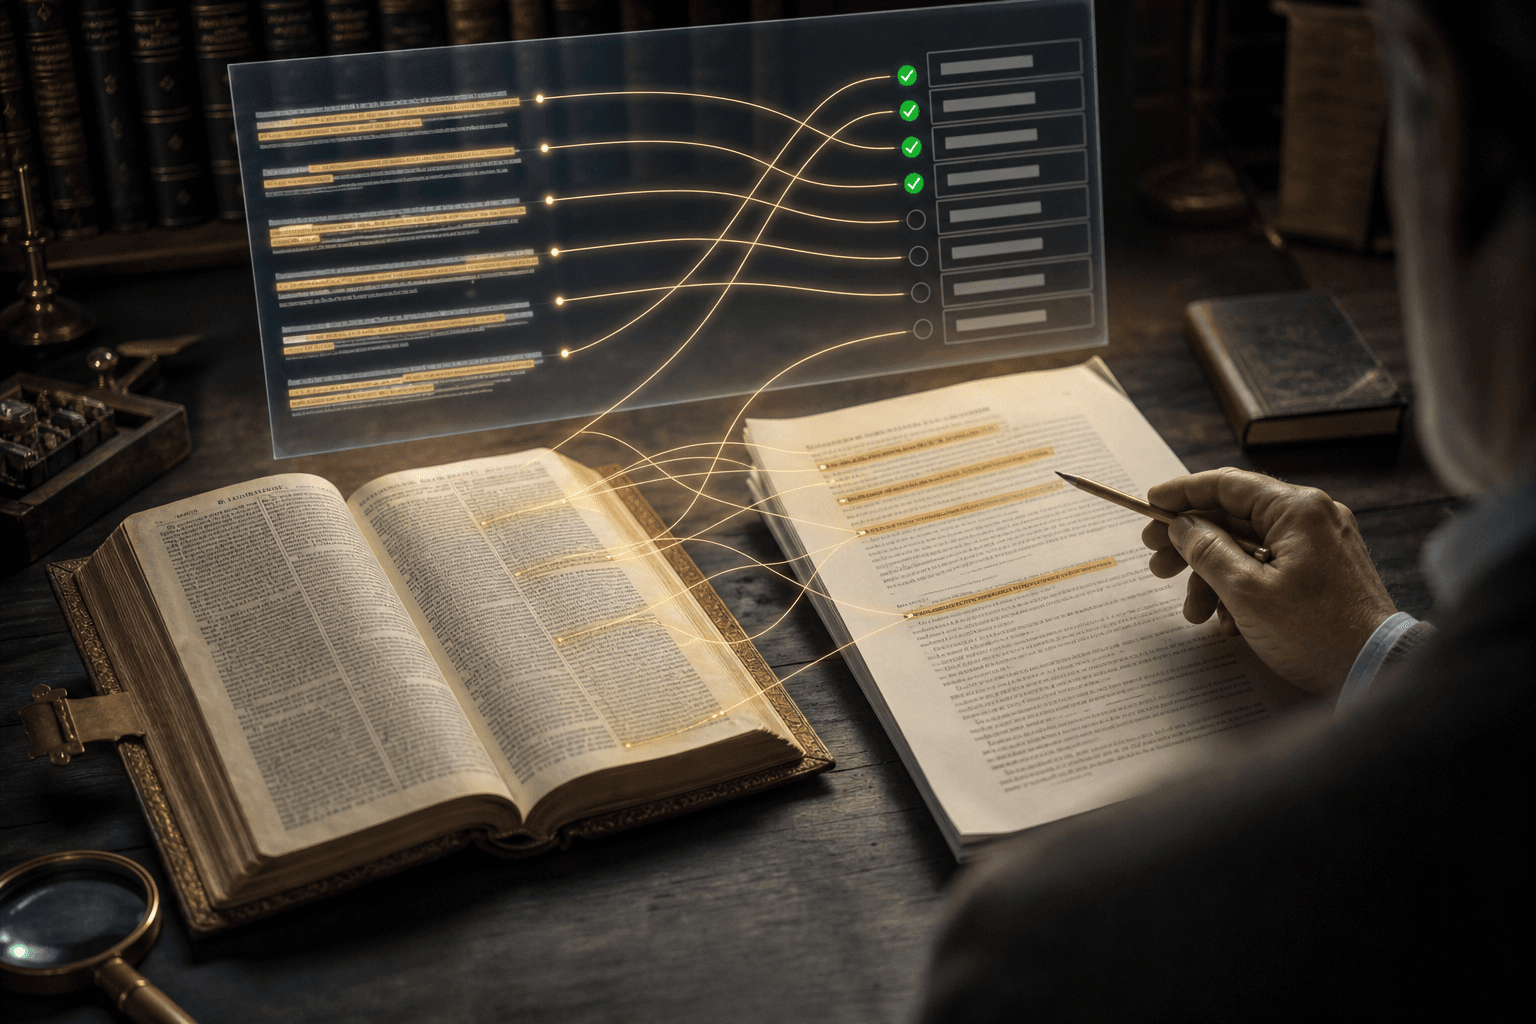
コペンハーゲン大学などの研究チームが、ブリクセン作品中の聖書参照を検索するAIを検証した。微調整で再現率は0.265から0.508へ向上し、専門家の精読を支える候補生成技術として企業の知的資産管理にも応用が見込まれる。
香港中文大学系などの研究チームは、画像を見て自ら描き直す統合モデルに強化学習を適用する手法を開発した。外部の検証器なしで生成品質が向上し、実務展開の負担軽減が期待される。
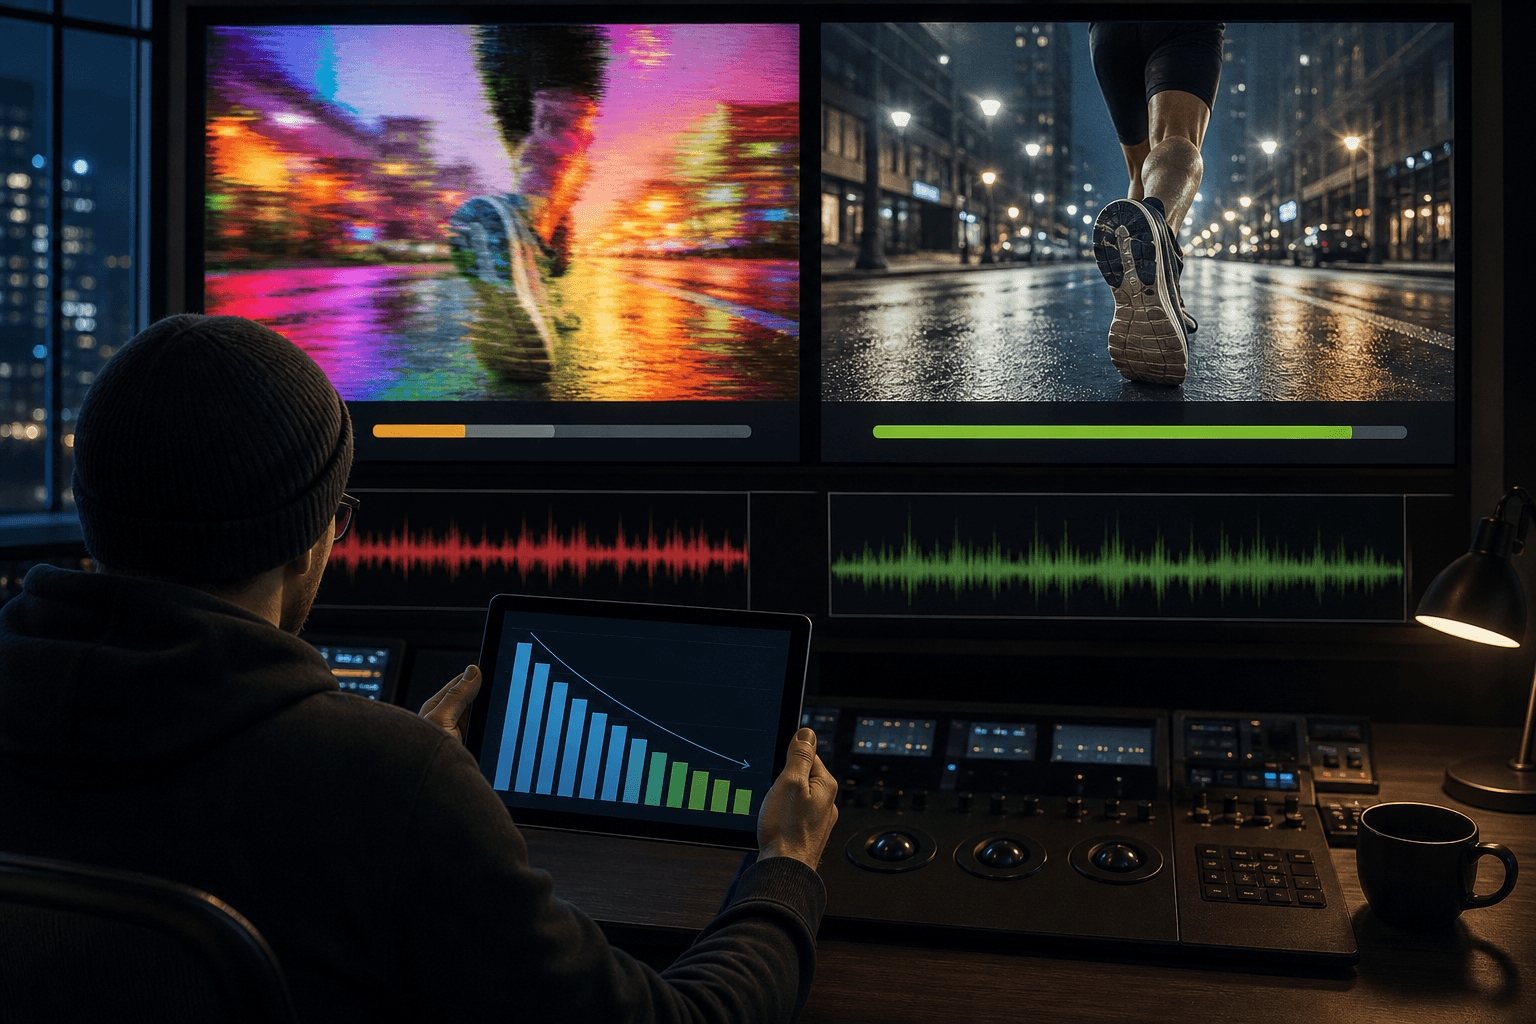
動画拡散モデルを4回の推論で動かす蒸留手法に、学習の劣化を抑える新手法PDMDが登場した。コード1行の変更で品質が向上し、動画制作の生成コスト削減に寄与する可能性がある。
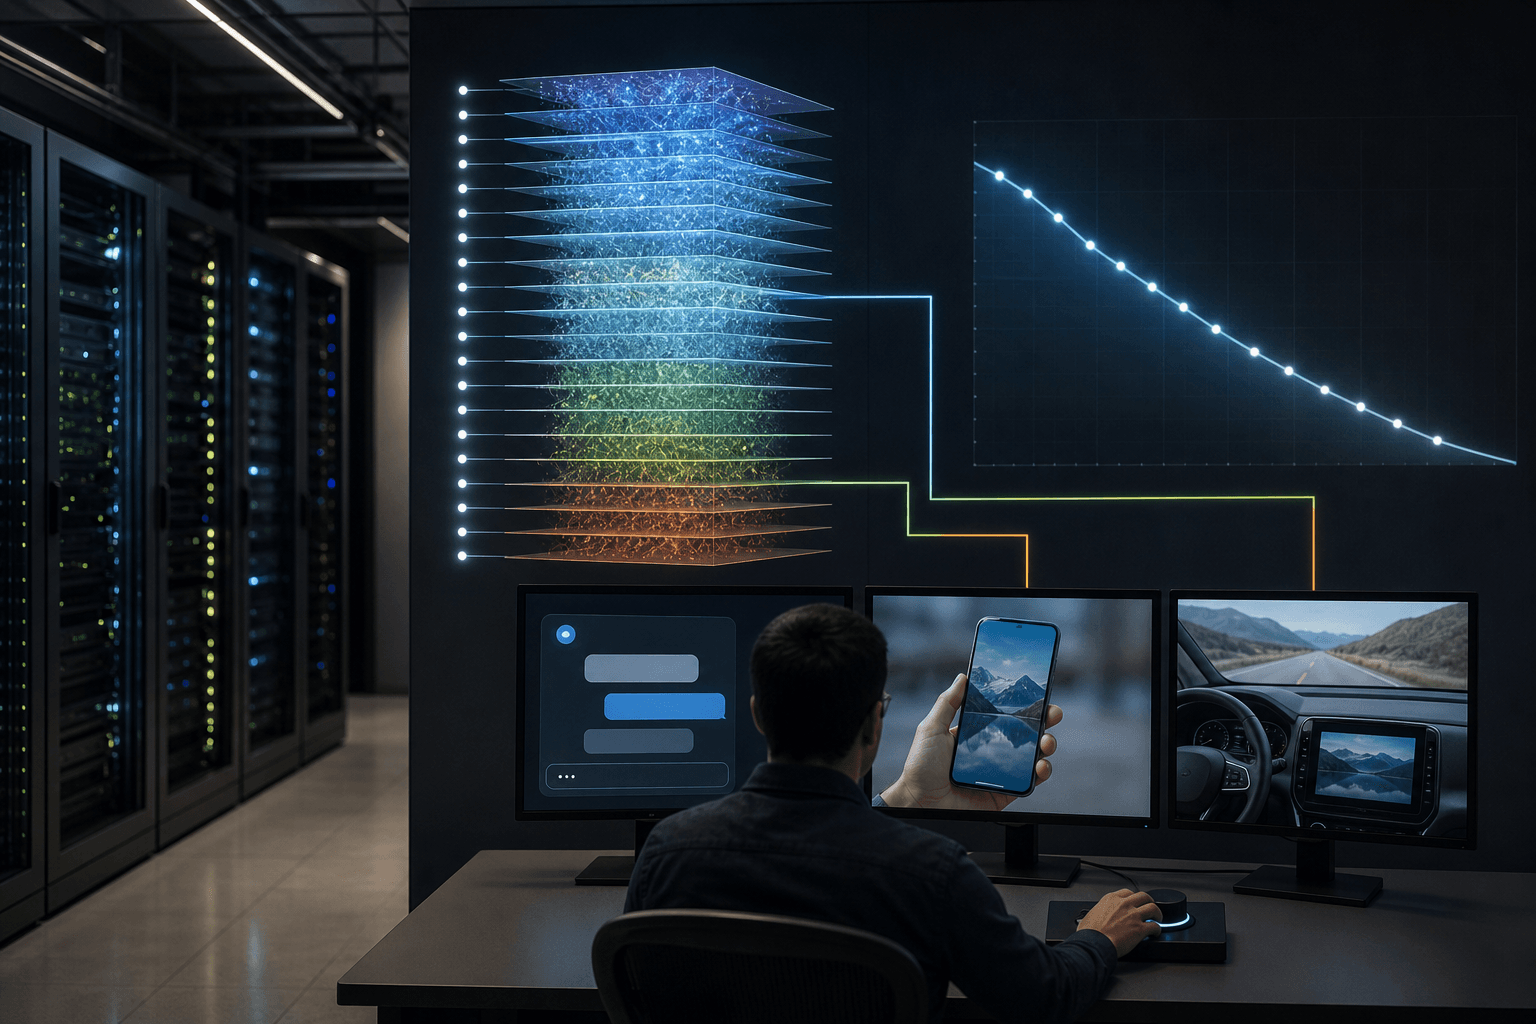
英研究チームは、1回の学習で全20層の各深度が言語モデルとして機能する「TLM」を提案した。品質と計算量の曲線下面積を43〜44%削減し、学習コストも約12%下げた。
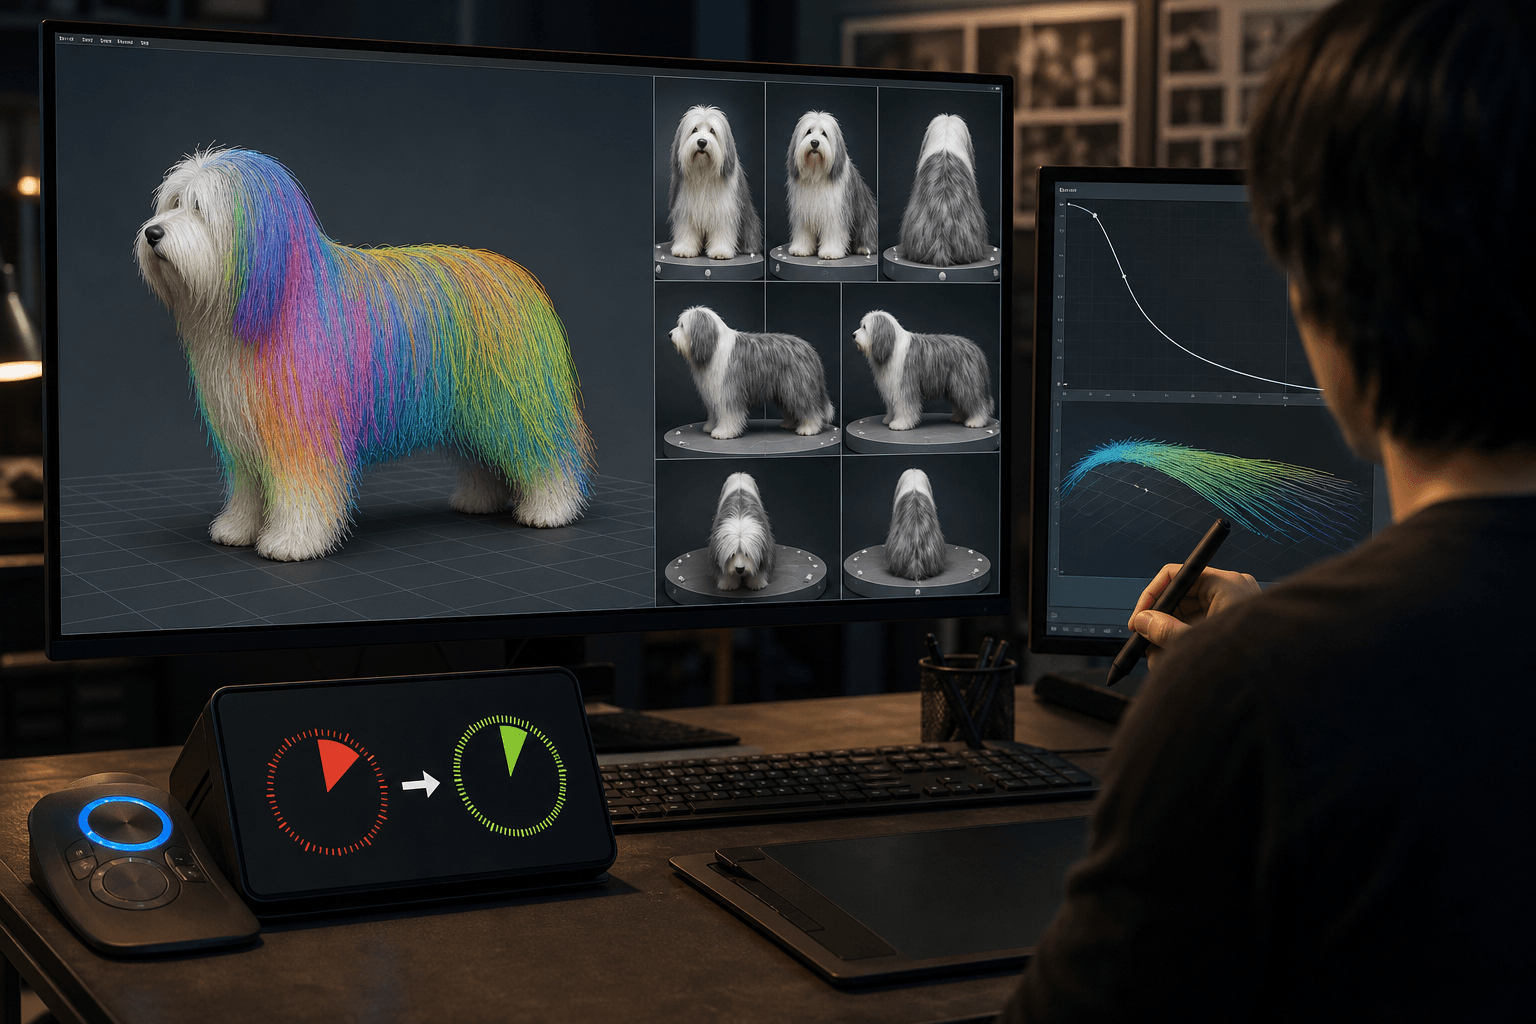
米研究チームは、複数視点の画像から動物の毛を1本ずつ編集可能な形で再構成する手法FurEを発表した。動物毛データ不要で従来比10倍の高速化を実現し、CG制作の工数削減につながる。
生物学的に妥当な学習則DFAで生じる学習停滞の原因が、誤差の共通成分にあると特定された。出力の事前補正などで停滞を抑え学習が速まり、省電力AI開発に影響し得る。
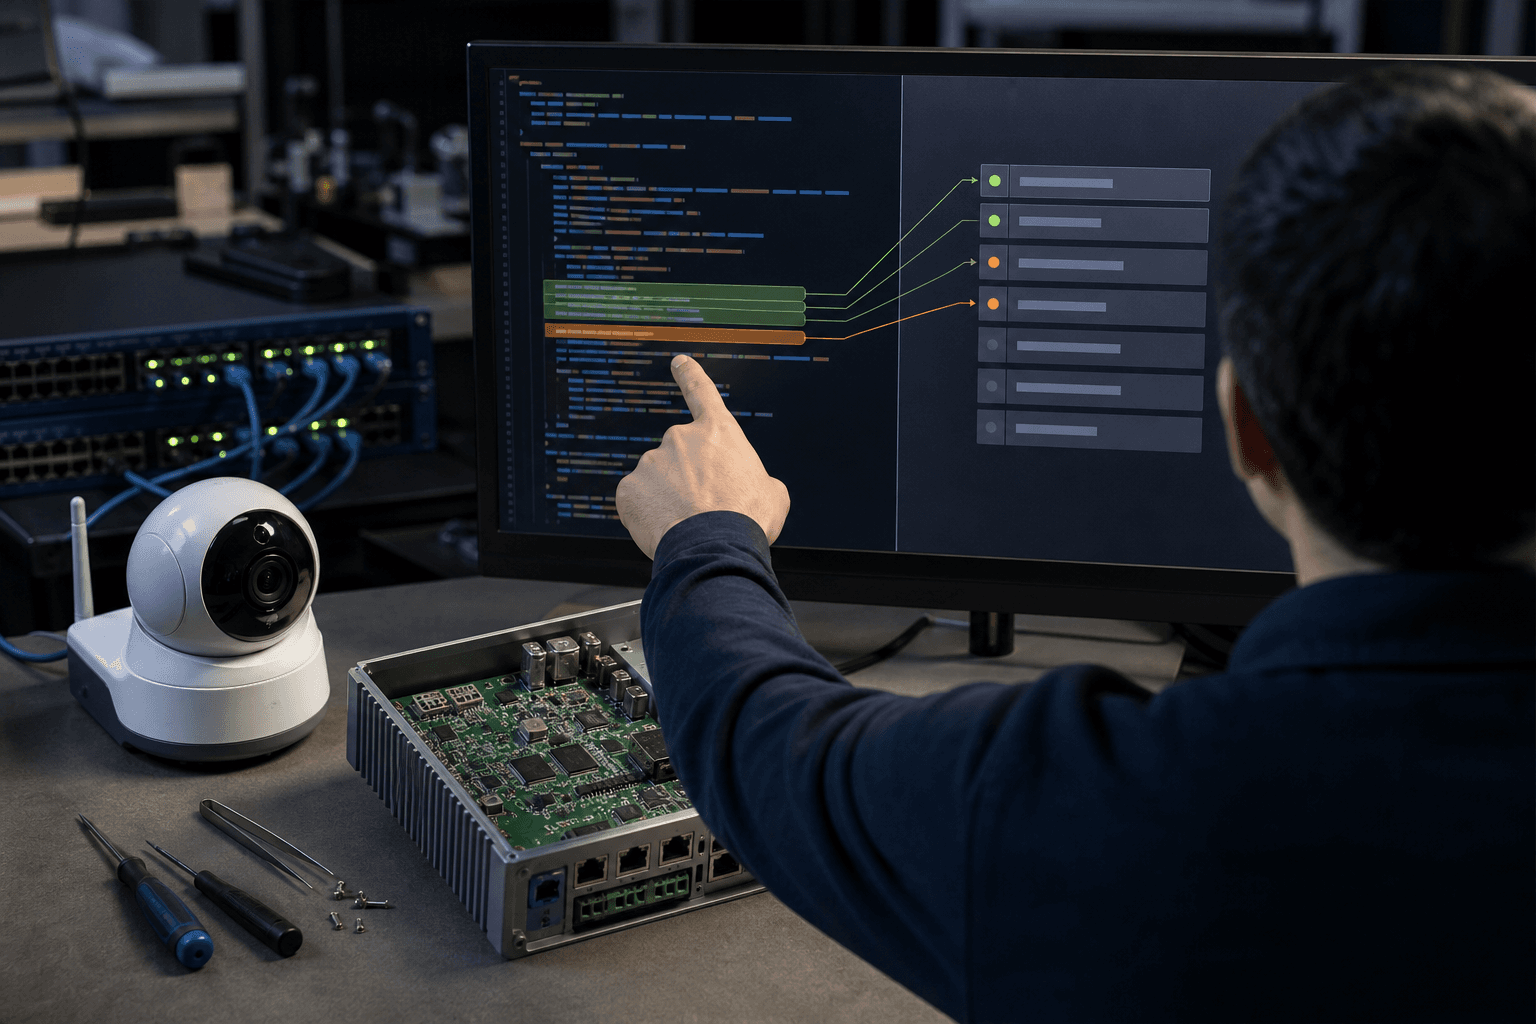
IoT機器の通信許可を定めるMUDプロファイルを、ファームウェアのソースコードから自動生成する技術AutoMUDが登場した。実機の監視が不要で、規則ごとに根拠コードを追跡できる点が特徴である。
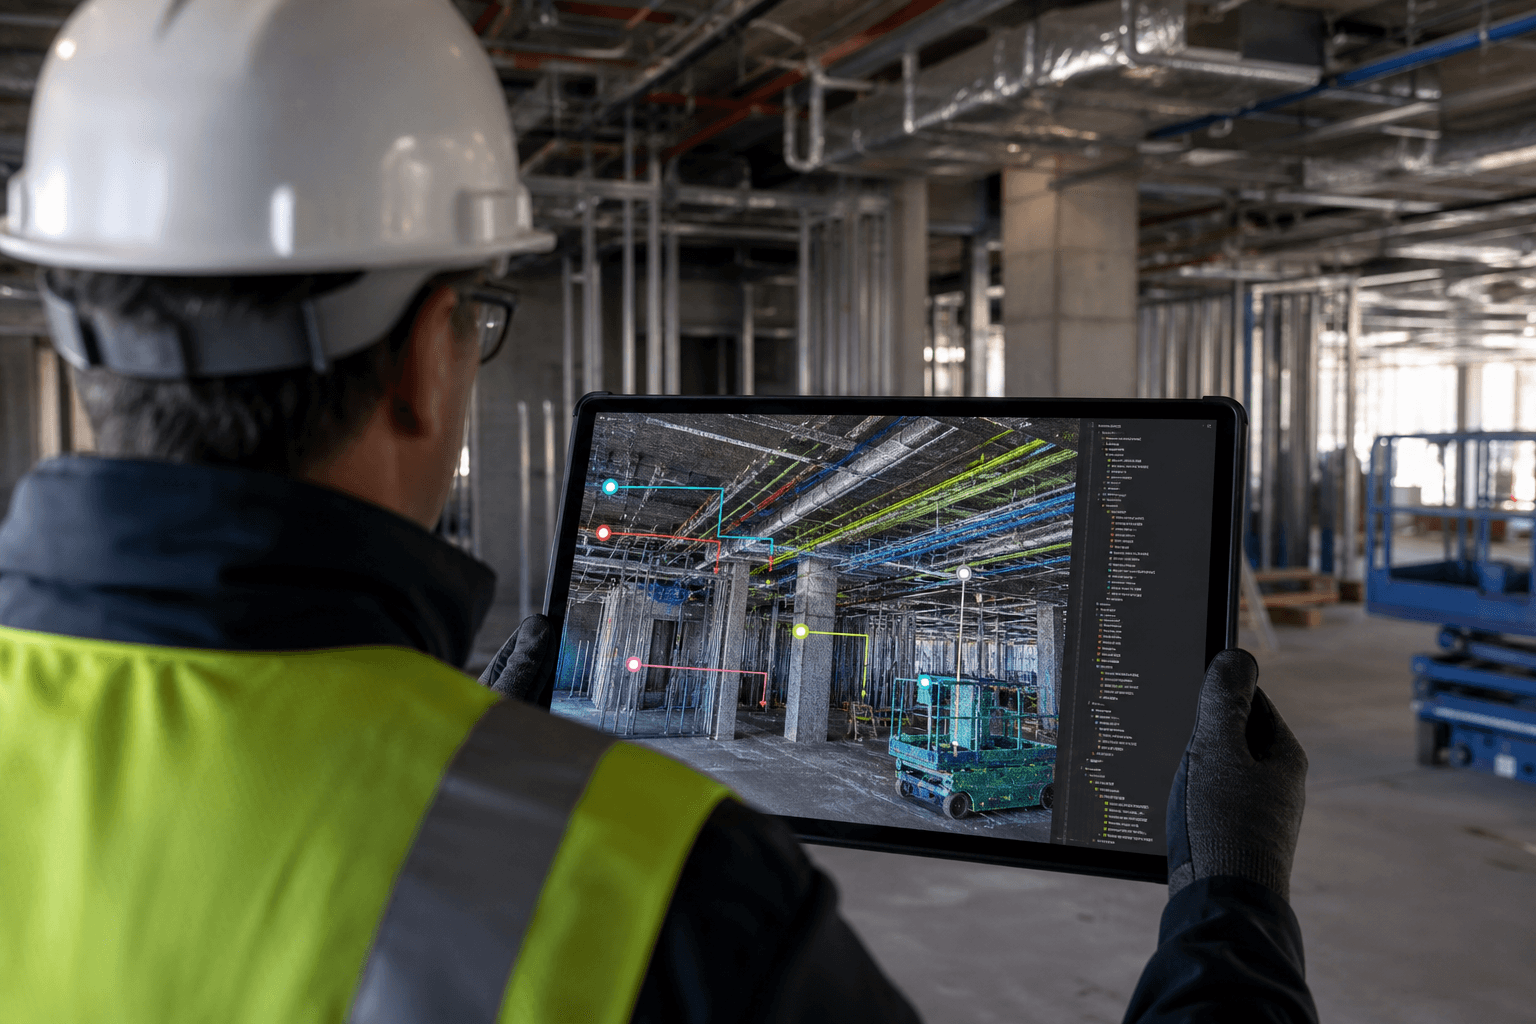
スイス連邦工科大学チームなどは、点群やガウシアン・スプラットから物体と関係を記した3Dシーングラフを一括生成するAI「GraphWrit3R」を発表した。多段処理と正解注釈への依存を排し、実用性を高めた。
複数のLoRAアダプタを推論コストなしで一つのモデルに統合する新手法READが提案された。新技能は旧技能を読むが書き換えない設計で、SuperGLUEで20点超の改善を示した。