生成AIの意味確定と非局所性が同時期に発生
生成モデルで意味クラスが確定する時期と、局所的な文脈だけでは生成できなくなる時期が重なる理由を、理論的に証明した研究が登場した。モデル設計や推論効率の指針となる。
研究の概要
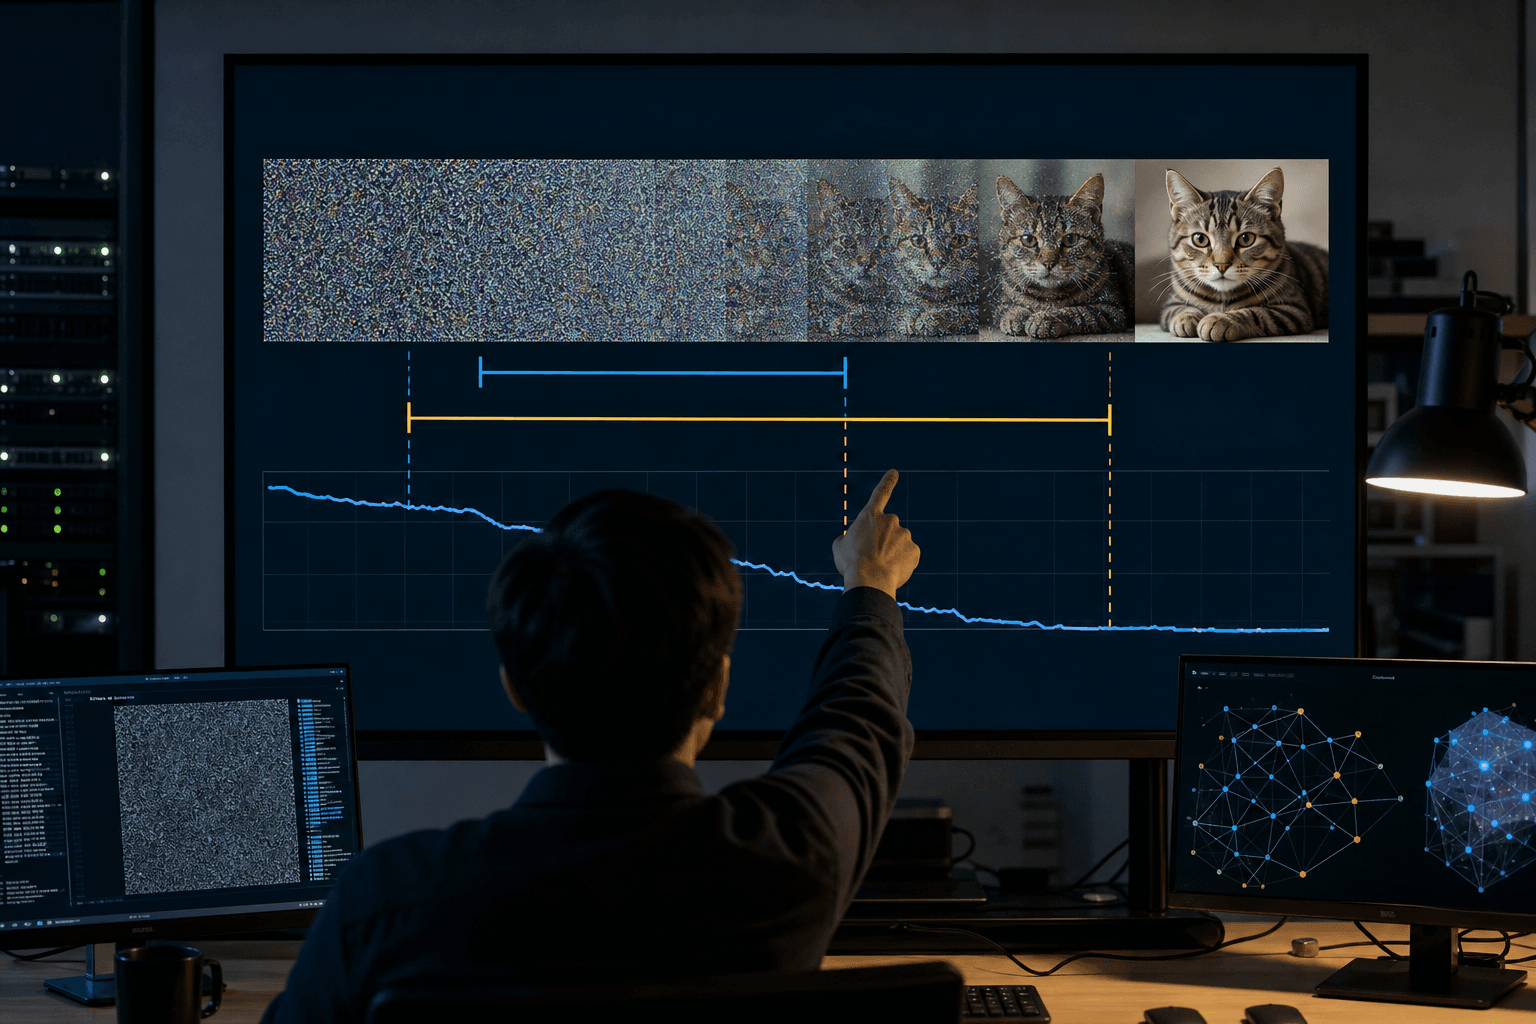
Liu氏らの研究チームは、拡散モデルなど生成モデルの生成過程に現れる二つの時間的区間の関係を理論的に解明した。第一は、生成サンプルが特定の意味クラスに確定する「種分化(スペシエーション)区間」である。第二は、近傍の文脈だけでは生成を進められなくなる「非局所性区間」である。複数の先端モデルで両者がほぼ同時期に現れることが経験的に知られていたが、その理由は明らかでなかった。
研究チームは「共通原因」仮説を置いた。意味ラベルが、離れたトークン同士の相関の一部を説明するという仮定であり、多くの実データで自然に成り立つ条件とされる。この仮説の下で、非局所性区間が種分化区間の内部に必ず収まることを数学的に証明した。
さらに、系のサイズが大きくなるにつれて両区間が単一の極限時刻へ収束する条件を示し、これを「相転移」と位置づけた。この挙動はガウス混合モデルで解析的にも検証されている。
ビジネスへの示唆
本研究は基礎理論であり、直ちに製品化される成果ではない。ただし、生成の「どの段階で意味が決まるか」を予測できる点は、実務上の指標設計に直結する。
画像・動画生成を扱うメディア・広告業界では、意味内容が決まる時間帯に計算資源を集中させることで、推論コストの削減が見込める。生成ステップ数の削減は、1枚当たりの生成単価や応答時間といったKPIの改善につながる。
製造業の設計・検査部門では、合成データ生成や異常検知に生成モデルを用いる例が増えている。意味が確定する区間を把握できれば、欠陥パターンなど制御したい属性をどの段階で条件付けるべきかを判断しやすくなる。これにより、合成データの品質や、検出モデルの再現率の向上が期待できる。
医療・創薬分野では、分子や医用画像の生成で、クラス(構造の種類)が決まる時点の制御が課題である。関連する部門は次のとおりである。
- 研究開発部門:生成候補の多様性と有効率
- AI基盤・MLOps部門:推論コストと生成遅延
- 品質保証部門:生成物の属性一致率
また、局所的な処理で足りる区間では、計算量の小さい局所モデルや並列処理を適用できる。非局所性が強まる区間にのみ大域的な注意機構を割り当てる設計は、GPUコストの抑制に寄与しうる。
今後の展望
今回の証明は、意味ラベルが遠隔相関を説明するという仮定に依存する。ラベルで説明できない相関が支配的なデータでは、結論が成り立たない可能性がある。また、解析的な検証はガウス混合に限られ、実際の大規模モデルでの定量的な検証は今後の課題である。
一方で、相転移という枠組みは、モデル規模やデータ規模を拡大する際の挙動を予測する手がかりになる。生成モデルの開発企業にとっては、経験則に頼っていたサンプリング設計やスケジュール調整を、理論に基づいて最適化する道が開ける。意味確定の時期を診断する手法が整備されれば、生成AIの品質管理や安全性評価の新たな基準として定着する可能性がある。
関連トピック
同セクションの記事
衛星画像の作物識別、新モデルが精度で先行
英研究チームは衛星画像の時系列から作物を区分けする新モデル「PAtteRNS」を開発した。主要データで既存手法を上回り、区画境界の精度も高い。データ設計の欠陥も指摘した。
LeapQuant、線形注意の推論を1.47倍高速化
米UCバークレー校などの研究チームが、線形注意型LLMの再帰状態を8ビットに量子化しても精度を保つ手法LeapQuantを開発した。長文推論の費用を下げ、実運用の採算改善に資する成果である。
STEPQuant、推論メモリを最大68.7%削減
中国の研究チームは、線形注意モデルの再帰状態を6ビットで圧縮する量子化手法STEPQuantを開発した。精度をほぼ維持し、同時処理時のサービング総メモリを最大68.7%減らす。