単一LLMが全深度で稼働、学習費12%減
英研究チームは、1回の学習で全20層の各深度が言語モデルとして機能する「TLM」を提案した。品質と計算量の曲線下面積を43〜44%削減し、学習コストも約12%下げた。
研究の概要
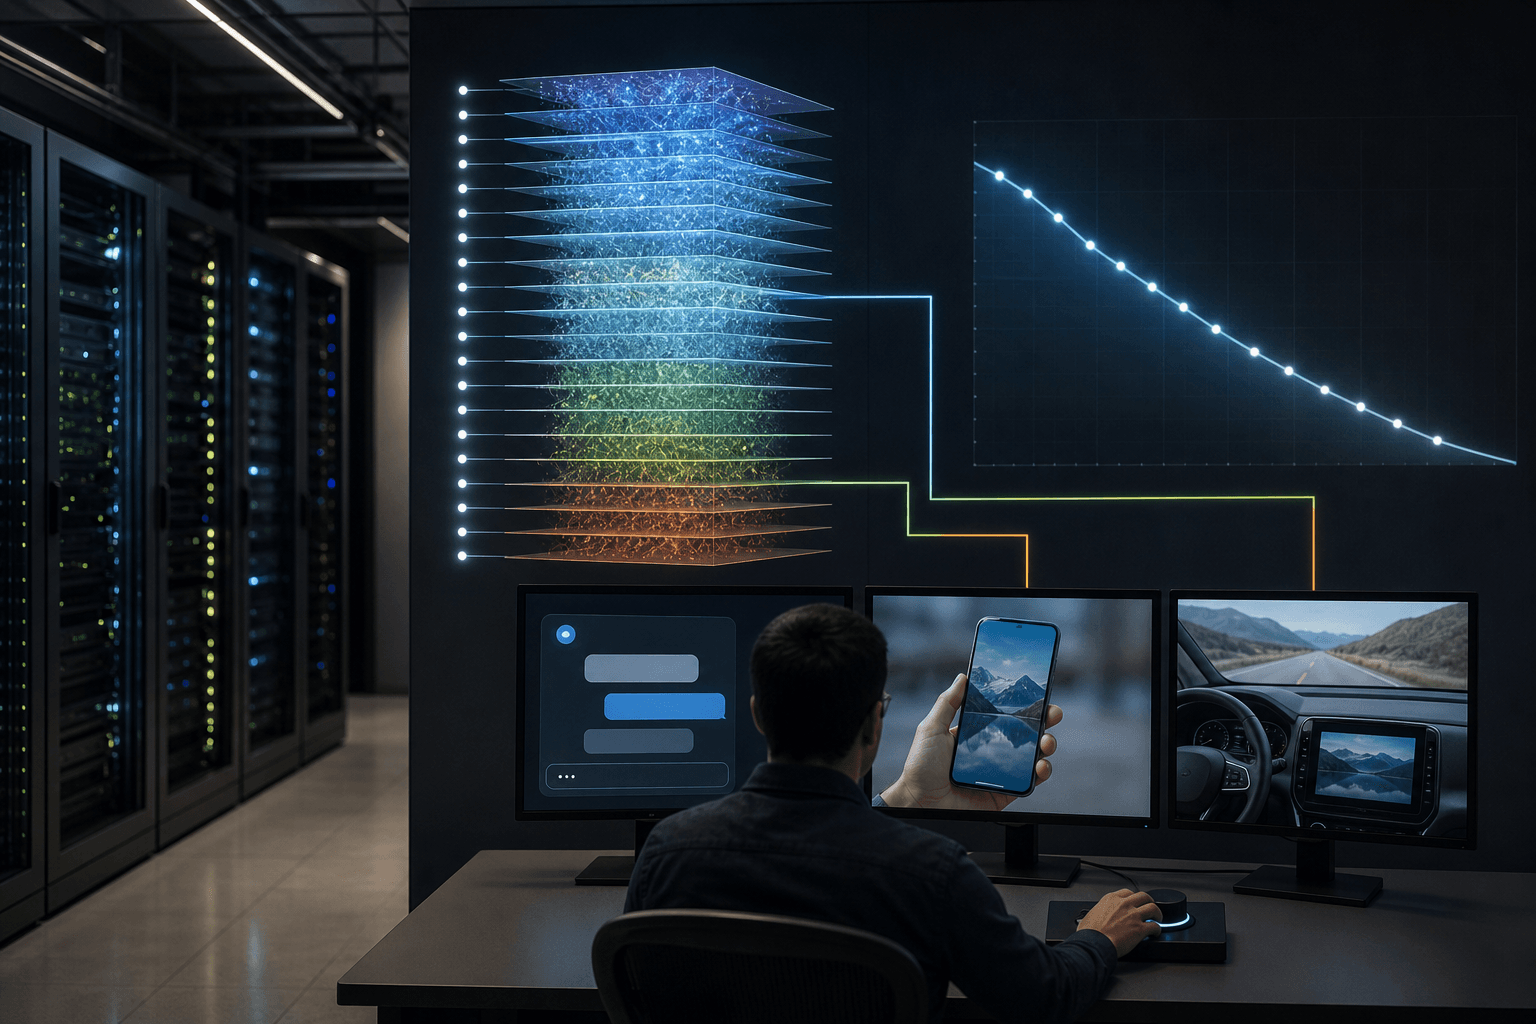
英国などの研究チームは、1つの言語モデルを多様な計算予算に対応させる手法「テレスコピック言語モデル(TLM)」を発表した。従来は計算予算ごとに別個の学習や圧縮を行う必要があり、運用負担が課題であった。
TLMは入れ子構造のTransformerを、確率的プレフィックス教師あり学習で訓練する。各ステップでランダムに切り詰めた層の深さ一つを完全な次トークン目標で学習し、あわせて全層での学習も1回行う。1ステップの順伝播・逆伝播は2回で、アーキテクチャの変更や推論時の追加処理は要らない。
比較対象は、少数の固定出口のみを教師とする「Matryoshka言語モデルスイート(MLMS)」などである。これらは監督のない深度で性能が偶然水準に落ち、パープレキシティが10^2〜10^5に達した。
2億パラメータ規模の検証(FineWeb-Edu 20Bトークン、全手法で同一データ)では、TLM単体で20の層プレフィックスすべてが有効な言語モデルとなった。パープレキシティとその影響を受けやすい下流タスクの双方で確認された。品質と予算の曲線下面積は固定出口方式より43〜44%減少し、最大容量での性能は同等、1回の学習あたりGPUコストは約12%低い。
ビジネスへの示唆
最大の影響を受けるのは、AIサービスを提供するSaaS事業者やクラウド事業者のMLOps・推論基盤部門である。現在は高性能版と軽量版を別々に学習・保守する例が多い。単一の成果物から任意の深度を切り出せれば、モデル管理数や再学習の工数を減らせる。
主な効果が見込まれる指標は次のとおりである。
- 学習GPU費用:モデル系列全体での重複学習の削減
- 推論単価:負荷や要求水準に応じた深度の動的切り替え
- 応答遅延:簡易な問い合わせでは浅い層で処理
- 運用工数:モデルの版数と検証対象の減少
コールセンターの自動応答や社内検索では、定型質問を浅い深度、複雑な要約や分析を深い深度で処理する運用が考えられる。利用が集中する時間帯に品質をわずかに落として遅延を抑える設計も可能となる。スマートフォンや車載機器など端末側の製造業でも、機種ごとの演算能力に応じて同一モデルから最適な深度を選べる。
研究チームは、プレフィックスの抽出密度を調整できると述べる。特定の少数深度に集中させれば、その深度で固定出口方式並みの品質を回復できるが、連続性は失われる。運用点の決定がアーキテクチャ設計ではなく学習時の選択になるため、事業側の要件を学習計画に反映しやすくなる。
今後の展望
本結果は2億パラメータ規模の代理的な検証に基づく。数十億から数千億パラメータの実用規模で同様の効果が得られるかは未確認であり、推論タスクや長文生成など、パープレキシティに表れにくい能力への影響も今後の評価課題である。浅い深度の品質が実際の顧客業務でどこまで許容されるかは、企業ごとの検証が欠かせない。
一方、著者らは、モデルを弾力的にするのは入れ子構造そのものではなく学習目的であると結論づける。この知見が実規模で裏付けられれば、モデル提供者は品質とコストの選択肢を1つの成果物で提示でき、AI調達における価格設計にも影響を与えるとみられる。導入企業は、自社の業務ごとに許容できる品質下限と単価目標を先に定義しておくことが、この技術を生かす前提となる。
関連トピック
同セクションの記事
TokenCast、LLM代理の消費量を実行中に予測
LLMエージェントの実行中にトークン消費量を予測する手法TokenCastが提案された。追加のLLM呼び出しなしで予測を更新し、予算制御でトークンを21.3%削減。運用コストの管理手段として注目される。
物語状態を追跡するAI、長編小説生成を実現
研究チームが、登場人物や伏線を構造化して追跡する学習不要の枠組みNstAgentを提案した。10万語規模でも整合性と文章品質が低下せず、出版・映像業界の制作工程に影響し得る。
MGFlow、1段階で画像生成し4段階モデル超え
研究チームが、画像生成AIを1回の推論で動かす学習枠組みMGFlowを発表した。FLUX.2 klein 4Bを1段階化し、4段階の元モデルを主要指標で上回り、生成コスト削減の道を開く。