MLLM、3D情景を想像し空間推論を強化
韓国の研究チームは、複数視点の画像から粗い3D表現を内部で組み立ててから回答するMLLM「Imagine3D-LLM」を発表した。精密な幾何情報に頼らず、空間推論で既存手法を上回った。
研究の概要
複数視点の画像から3D空間を理解する能力は、マルチモーダル大規模言語モデル(MLLM)にとって根本的な課題である。単一画像の処理には優れる一方、視点をまたいで証拠を統合し、一貫した3D理解を築くことが難しい。従来は、画素単位の視点間対応を強化する手法や、3D幾何基盤モデルの特徴を融合する手法が試みられてきたが、人間の推論との間には大きな隔たりが残っていた。
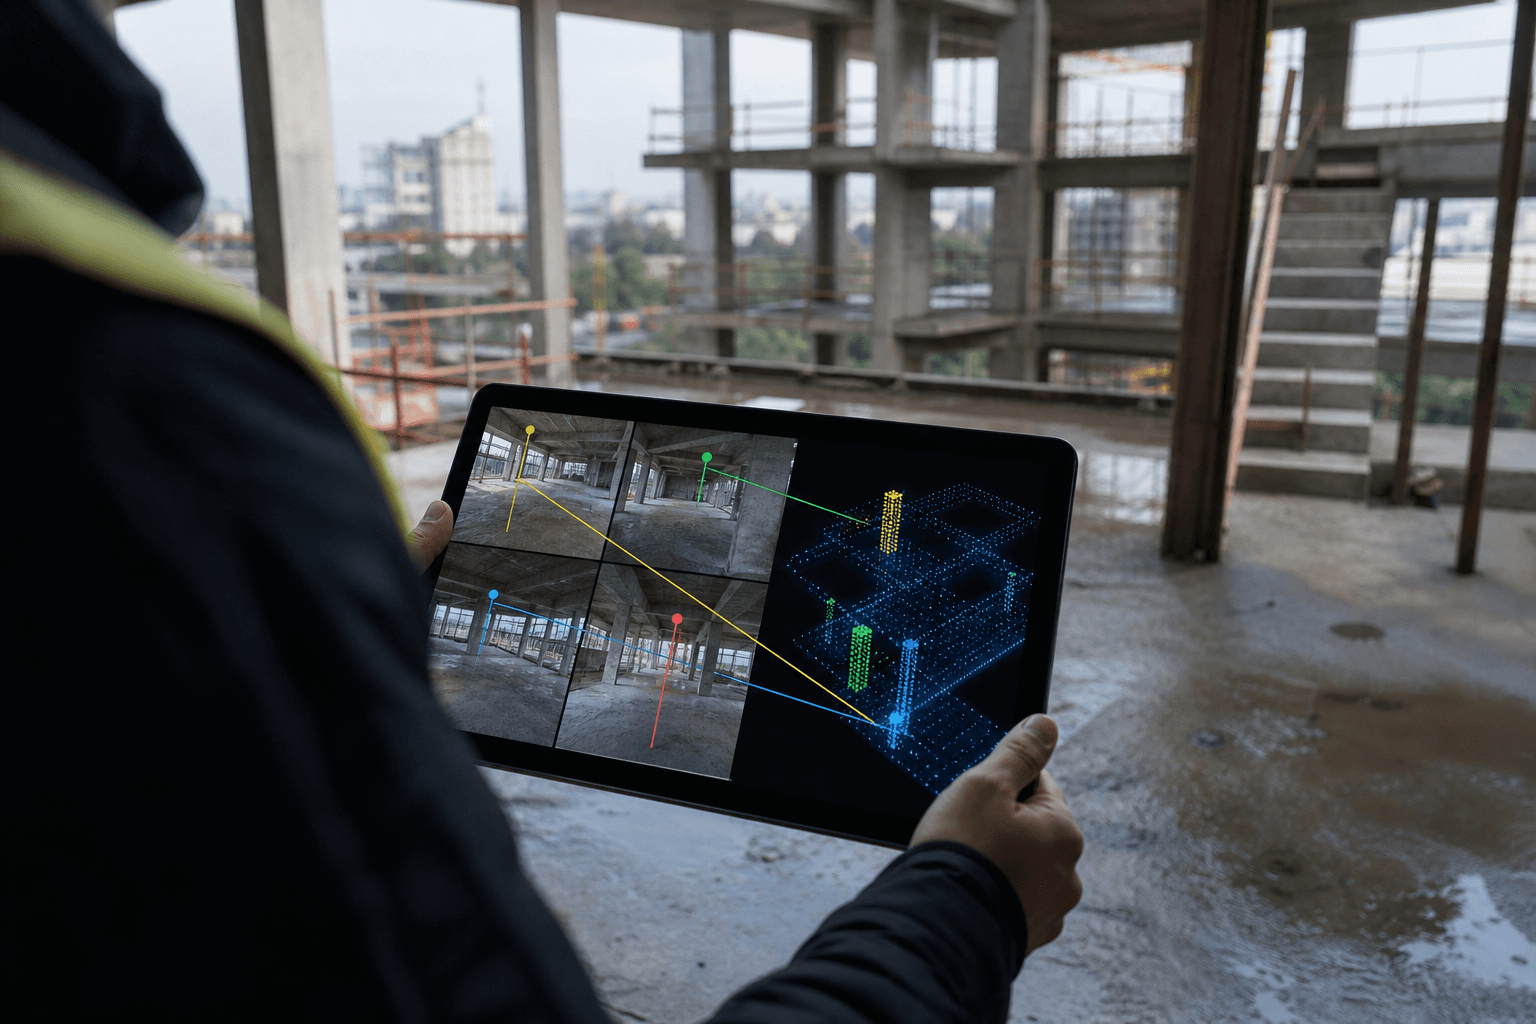
ソウル大学校などの研究チームは、人間の空間推論に着目した。人間は精緻な幾何情報に依存せず、視点間で共通する物体をおおまかに特定し、視点間の相対的な位置関係を推定して、場面の粗い3次元配置を組み立てているとされる。
これに着想を得た「Imagine3D-LLM」は、画像トークンの後ろに少数の学習可能な要約トークンを付加する。このトークンを3Dガウシアン・スプラッティングと呼ばれるコンパクトな3D表現へ復号し、測光的再構成損失で教師信号を与える。学習は通常の次トークン予測と同時に行い、モデルは自ら組み立てた3D表現を踏まえて回答を生成する。
注目すべき点は、直接の再構成教師を受けるのが要約トークンのみであるにもかかわらず、LLM内部の画像特徴において、フレーム間の対応関係も強まったことである。再構成の学習が、モデル全体へ3D認識の信号を波及させていると研究チームは分析している。結果として、複数の空間推論および3D理解のベンチマークで、従来手法を一貫して上回った。
ビジネスへの示唆
最大の特徴は、専用の3Dセンサーや高精度な幾何推定器を前提とせず、通常の複数枚の画像から空間理解を引き出せる点にある。導入コストの低減が見込まれ、次の領域で影響が想定される。
- 建設・不動産:現場の写真から空間配置を把握し、進捗確認や出来形検査を省力化する。現場監督部門の巡回工数や、手戻り発生率の低減が指標となる。
- 物流・倉庫:庫内の複数カメラ映像から棚や荷の位置関係を推論し、ピッキング誤り率や在庫照合時間の改善に結びつく。
- ロボティクス・製造:組立や検査工程で、物体間の配置関係を言語で指示・確認できれば、ティーチング時間の短縮につながる。
- 保険・損害査定:事故や災害現場の複数写真から状況を把握し、査定リードタイムの短縮が期待される。
いずれの場合も、担当部門が評価すべき指標は、空間関係に関する回答精度、人手による確認工数、現場撮影から判断までの所要時間である。既存の画像解析パイプラインに追加の3D計測機器を導入せずに済めば、投資回収期間も短くなりうる。
また、再構成を補助課題として学習させる設計は、自社データでMLLMを追加学習する企業にとって参考になる。社内で蓄積した多視点画像を活用し、自社現場に特化した空間理解モデルを構築する際の設計指針となりうる。
今後の展望
今回の成果は、詳細な幾何情報を外部から与えるよりも、モデル自身に場面を再構成させる方が有効である可能性を示した。ただし、評価はベンチマーク上の結果であり、照明条件の悪い現場や動的に変化する環境、大規模な屋外空間での頑健性は、実運用に向けて検証が必要である。推論時の計算負荷や応答遅延も、リアルタイム用途では導入判断の要素となる。
今後は、ロボットの行動計画や拡張現実、自動運転支援など、空間理解と言語指示を結びつける用途への展開が焦点となる。実務側では、自社の撮影条件に近いデータでの概念実証を通じ、精度と運用コストの両面から適用範囲を見極めることが求められる。
関連トピック
同セクションの記事
衛星画像の作物識別、新モデルが精度で先行
英研究チームは衛星画像の時系列から作物を区分けする新モデル「PAtteRNS」を開発した。主要データで既存手法を上回り、区画境界の精度も高い。データ設計の欠陥も指摘した。
LeapQuant、線形注意の推論を1.47倍高速化
米UCバークレー校などの研究チームが、線形注意型LLMの再帰状態を8ビットに量子化しても精度を保つ手法LeapQuantを開発した。長文推論の費用を下げ、実運用の採算改善に資する成果である。
STEPQuant、推論メモリを最大68.7%削減
中国の研究チームは、線形注意モデルの再帰状態を6ビットで圧縮する量子化手法STEPQuantを開発した。精度をほぼ維持し、同時処理時のサービング総メモリを最大68.7%減らす。