AI×製造
ロボット、重み更新なしで成功率95%に自己改善
Yen-Jen Wang氏らは、モデルの重みを更新せず、シミュレーション上の練習でロボットの作業スキルを自律的に改善する枠組みRPGを発表した。22タスクの成功率は28.6%から95.0%に向上した。
Yen-Jen Wang氏らは、モデルの重みを更新せず、シミュレーション上の練習でロボットの作業スキルを自律的に改善する枠組みRPGを発表した。22タスクの成功率は28.6%から95.0%に向上した。
研究チームが、プログラムで定めた世界の出来事を動画生成AIがどこまで正確に描くかを測る新評価基準PROWBenchを公開した。ゲーム開発の品質管理に影響し得る。
Kali Linux上のコマンド生成力を測る新ベンチマーク「KaliBench」が公開された。ヒントなしの条件では完全一致精度が42%を超えるオープンモデルはなかった。専用の報酬による学習で8Bモデルが685B級に迫った。
3Dガウシアンアバターの動作計算を線形近似へ蒸留する手法GALAが登場した。CPU負荷を最大3桁削減し、モバイルで60fpsを実現する。メタバースや接客分野の導入費用を左右し得る。
Tom Goldstein氏らの研究チームは、球面の潜在空間から画像を生成するオートエンコーダ「Sphere Encoder 2」を発表した。生成の速さと単純さを保ちつつ画質を高め、低コストな画像生成の実用化に寄与する。
米研究者らが、学習済みの画像生成AIに手を加えず、エッシャー「プリント・ギャラリー」風の自己参照構図を生成する手法を提案した。画像と歪みを同時に生成する点が特徴である。
中国の研究チームが、人間の一人称視点データがロボット学習に効く条件を検証した。データ量より動作の整合性や多様性が重要と判明し、ロボット導入費用の抑制につながる。
実験設計なしで既存データから入力変数の影響度を推定する手法MM-GSAが提案された。二つの指標で変数の重要性を捉え、実務の要因分析や変数選択の精度向上に資する可能性がある。
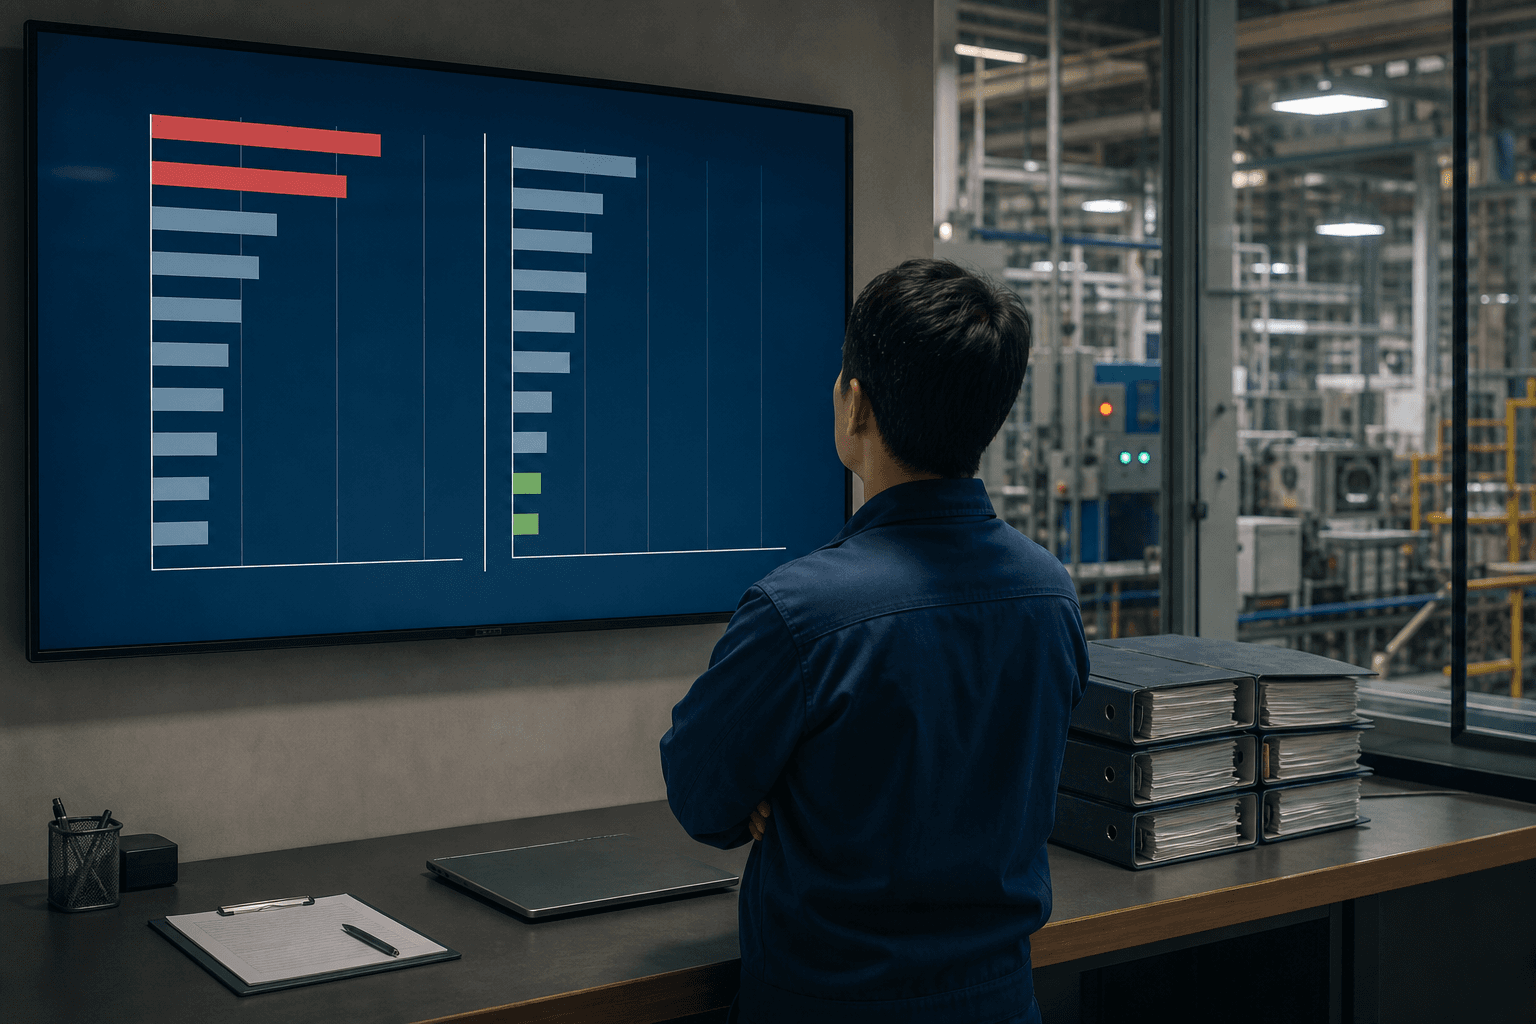
画像用ViTを転用し、ラベルなし動画から特徴を学ぶ手法VideoMSNが登場した。事前学習の回数を最大160分の1に抑えつつ主要ベンチマークで最高性能を達成し、動画AIの開発コストを下げる可能性がある。
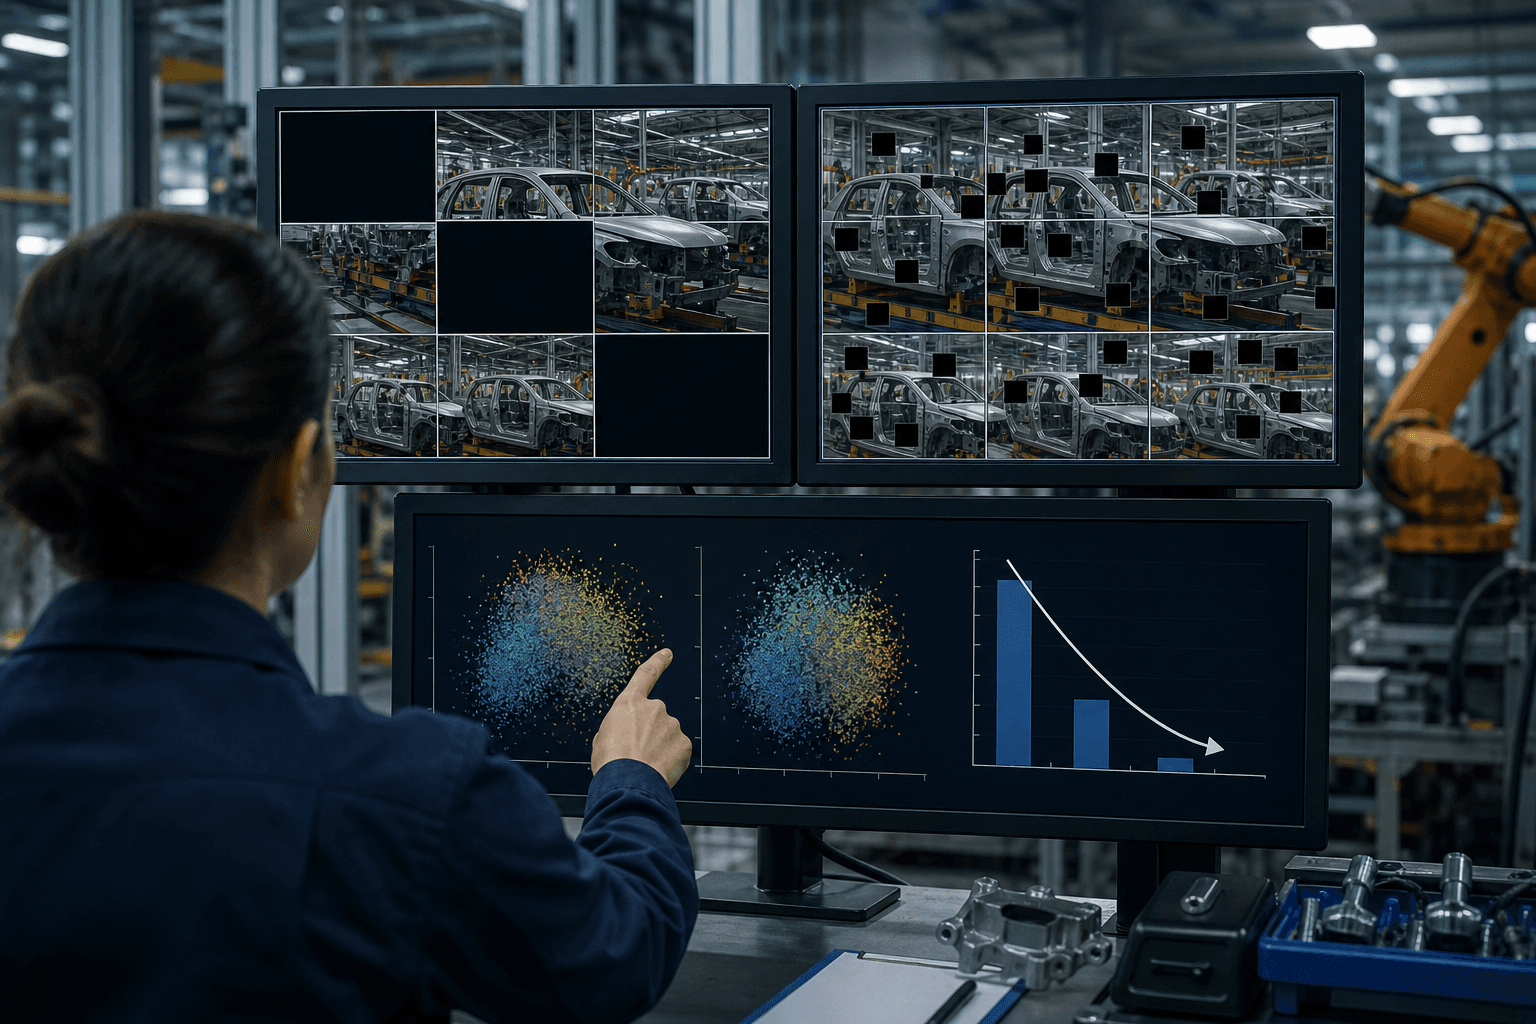
汎用AIエージェントに視覚操作で3D部品を組み立てさせる評価環境が公開された。最良系統でも部品単位の正答率は80.9%、完成品の成功率は59.4%にとどまり、製造現場への適用には精度面の課題が残る。
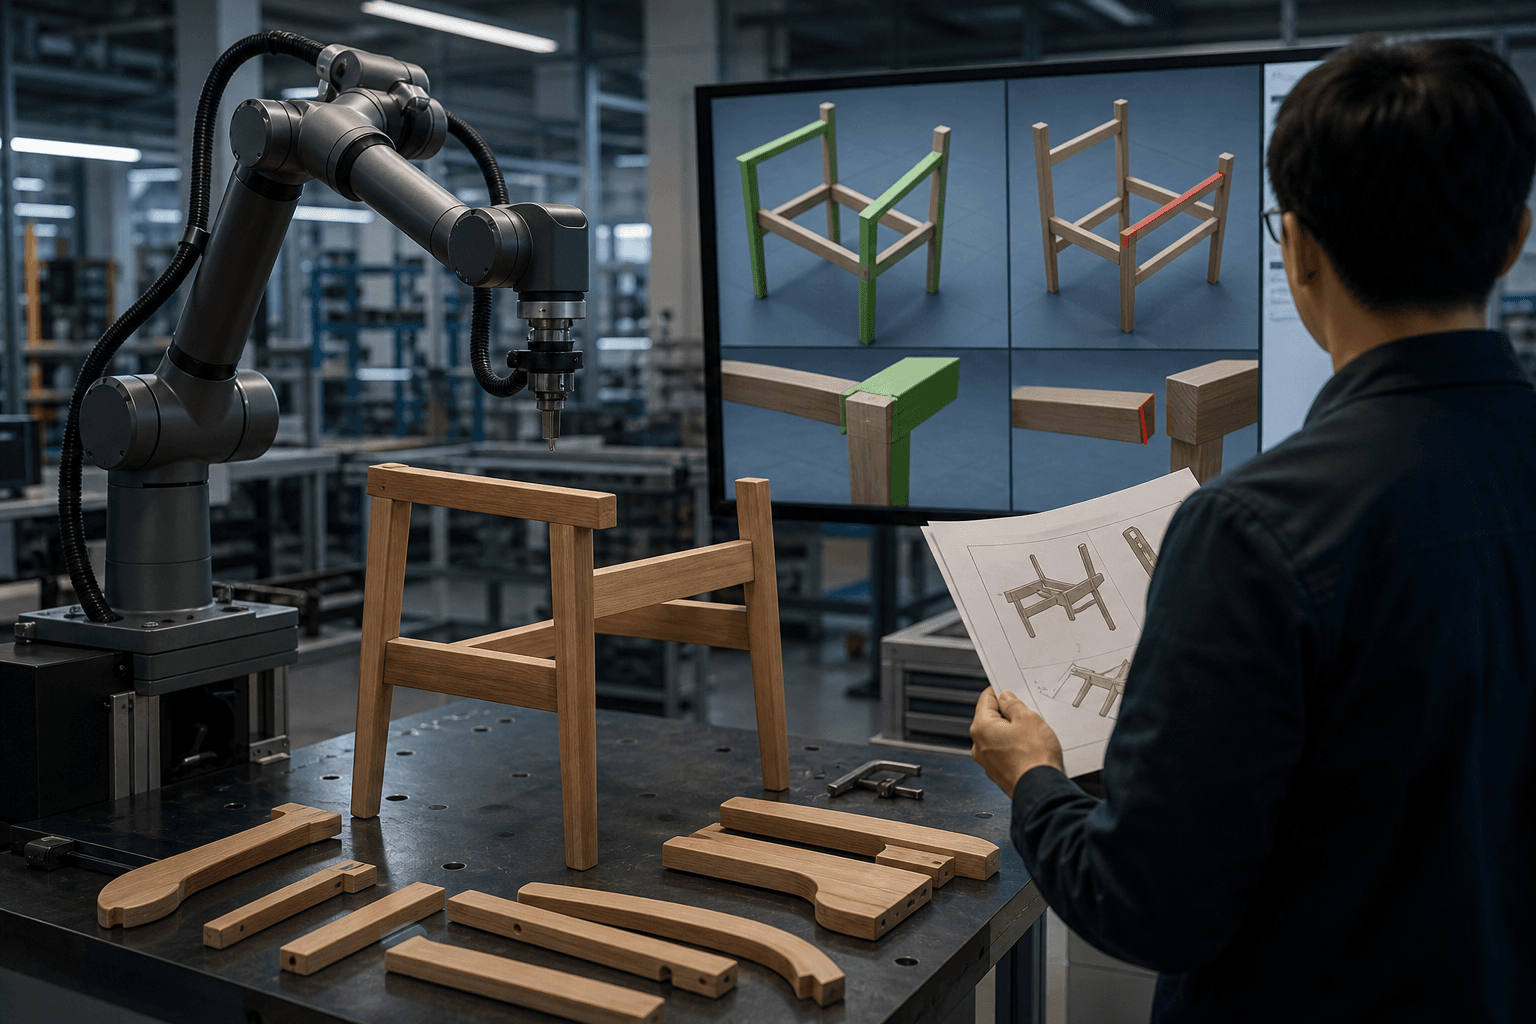
動画内の看板やラベルの文字を、背景の動きを保ったまま差し替える技術の評価基準「ViTeX-Bench」が公開された。広告やEC、多言語展開の制作工程を変え得る基盤として注目される。
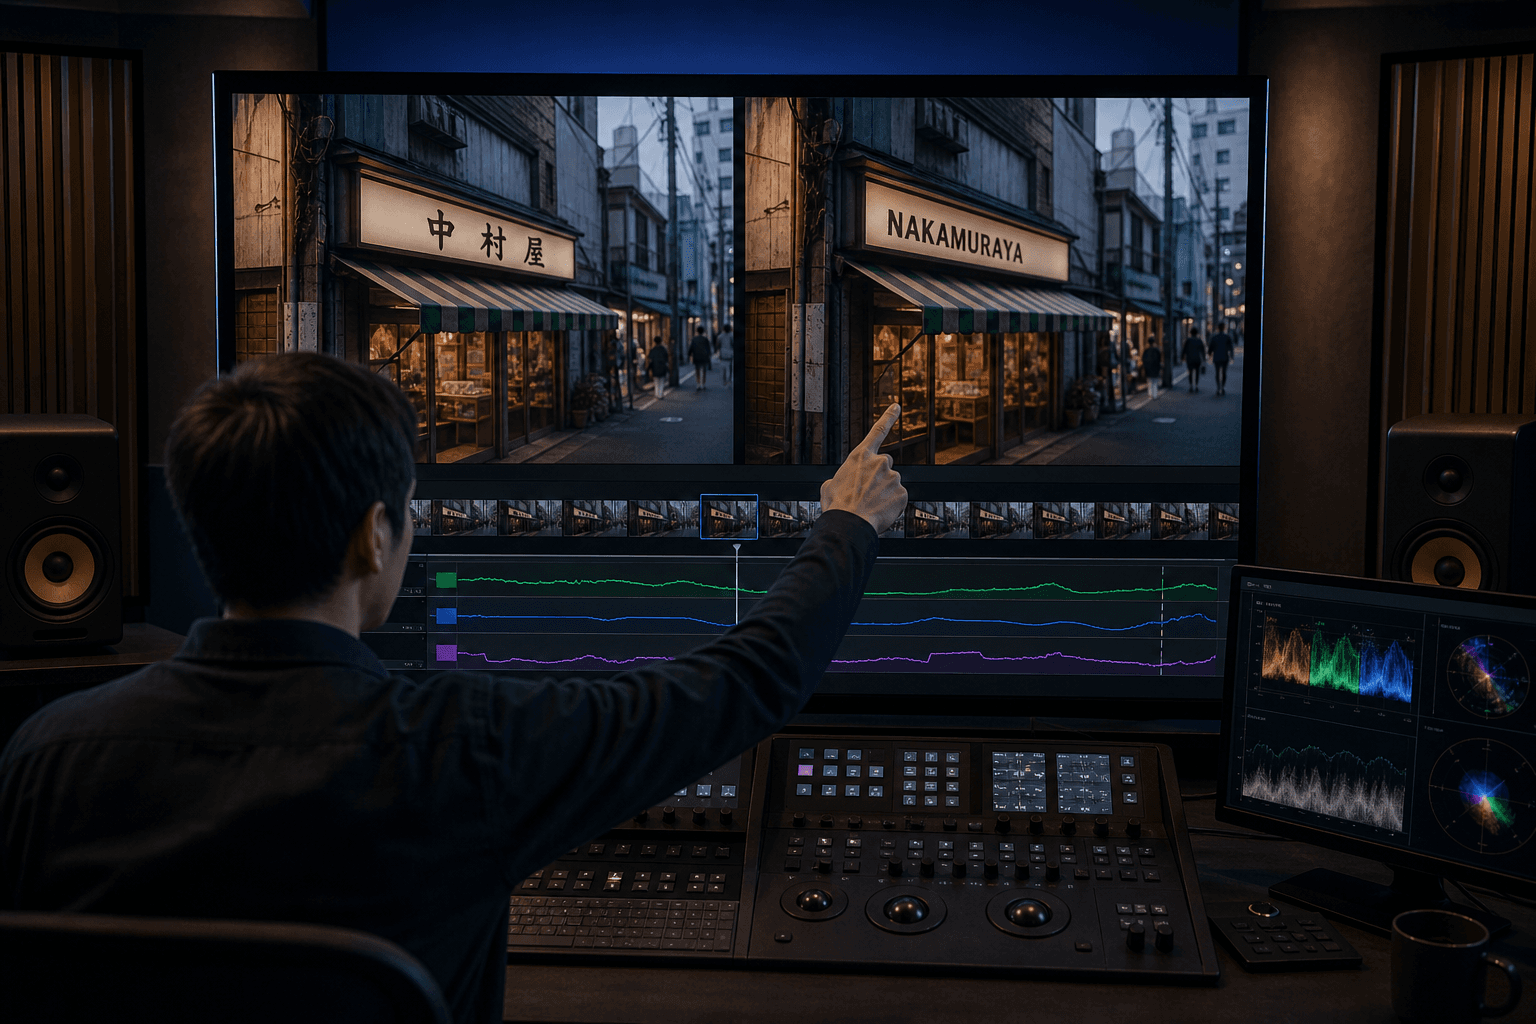
動画生成AIの物理的な不整合を、物理現象を記述する言語表現の自己改善で抑える枠組みPhysis-Langが提案された。オープンモデルが商用最上位のVeo 3.1を上回り、製造やロボティクスの合成データ活用に影響する。
非侵襲の脳波などから単語を復元する有力手法の精度向上は、脳データなしでもほぼ再現できることが判明した。研究チームは近道を除く簡素な改良で、単語誤り率36.6%を達成した。
中国の研究チームが、問題の本質と無関係な表現変化に弱いAIの癖を抑える強化学習手法SCAPOを提案した。小型モデルでも数学推論の精度が向上し、業務AIの安定運用に道を開く。
医療向けマルチモーダルAIのプロンプト改善で、正解率ではなくAUROCを最適化する手法Ranking-PEが提案された。不均衡な臨床データで診断の順位付け精度を最大16.2ポイント高めた。
華中科技大学などの研究チームが、言語と画像を連続的な埋め込み空間で一体的に扱う生成モデル「Multimodal Flow」を発表した。1500億トークンの学習で競合に迫り、基盤モデル開発費の抑制につながる可能性がある。
中国の研究チームが、ロボットの行動と未来予測を同時に学ぶ世界行動モデル「ReWAM」を発表した。動画生成の事前学習なしで高い成功率を示し、開発コスト低減の道を開く。
英研究チームは衛星画像の時系列から作物を区分けする新モデル「PAtteRNS」を開発した。主要データで既存手法を上回り、区画境界の精度も高い。データ設計の欠陥も指摘した。
米UCバークレー校などの研究チームが、線形注意型LLMの再帰状態を8ビットに量子化しても精度を保つ手法LeapQuantを開発した。長文推論の費用を下げ、実運用の採算改善に資する成果である。
中国の研究チームは、線形注意モデルの再帰状態を6ビットで圧縮する量子化手法STEPQuantを開発した。精度をほぼ維持し、同時処理時のサービング総メモリを最大68.7%減らす。