TokenCast、LLM代理の消費量を実行中に予測
LLMエージェントの実行中にトークン消費量を予測する手法TokenCastが提案された。追加のLLM呼び出しなしで予測を更新し、予算制御でトークンを21.3%削減。運用コストの管理手段として注目される。
研究の概要
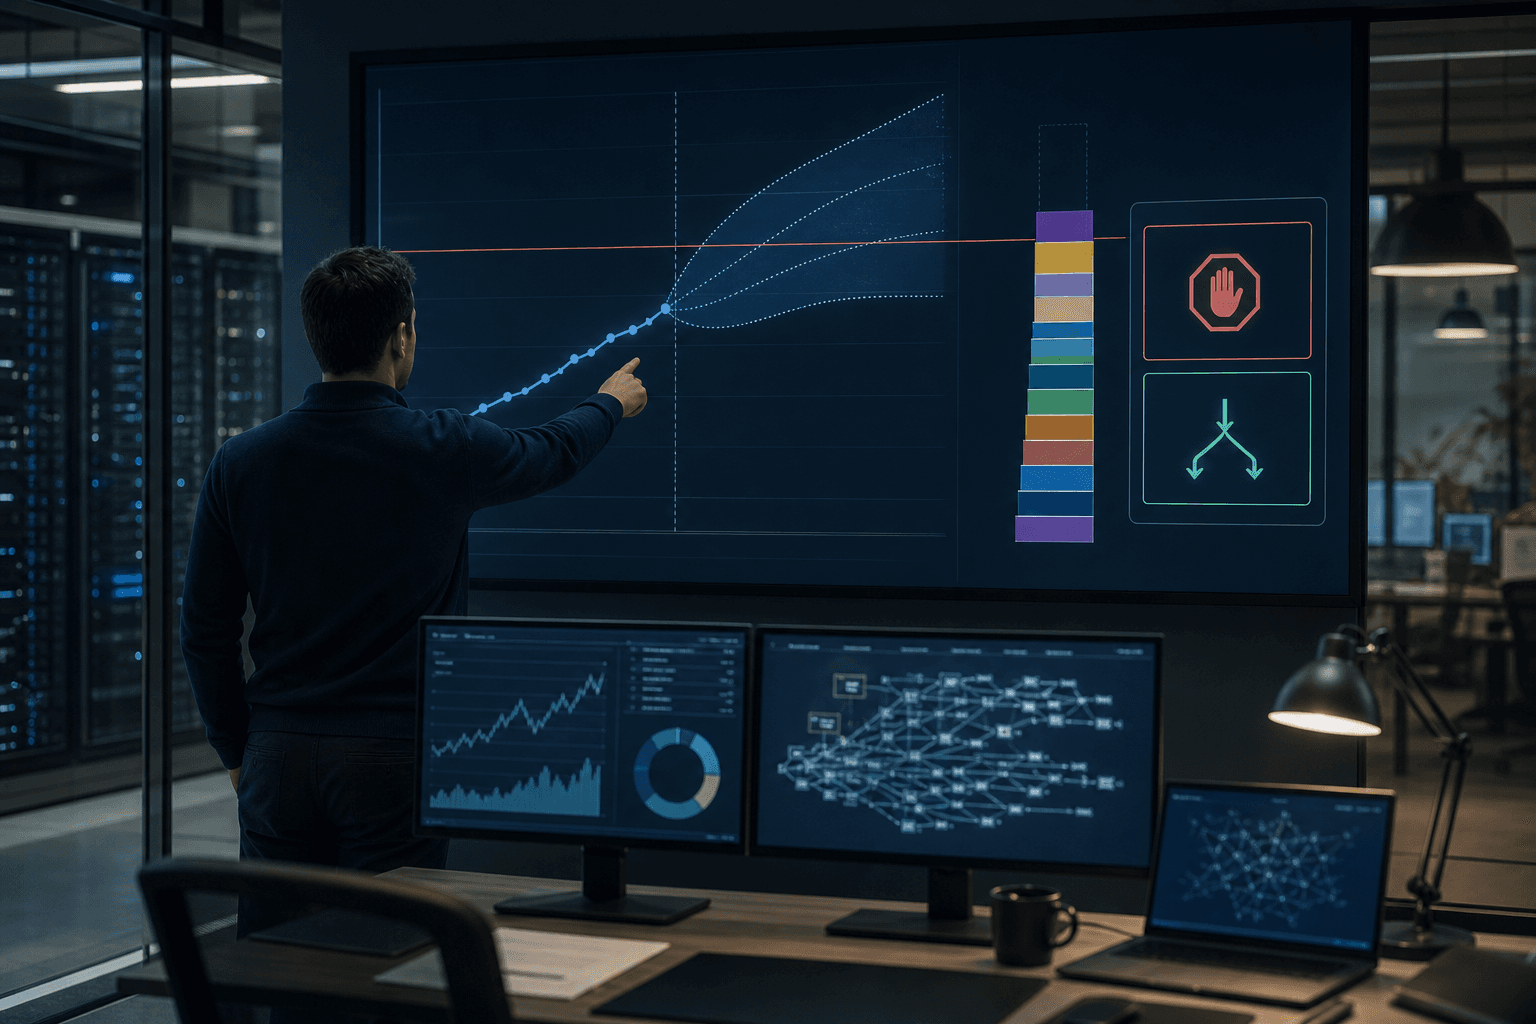
東南大学などの研究チームは、大規模言語モデル(LLM)を用いたエージェントが同一タスクを実行する際のトークン消費量を、実行しながら予測する手法「TokenCast」を提案した。エージェントはツールからの応答や中間結果に応じて次の行動を決めるため、同じタスクでも実行ごとの消費量が10倍以上変動することがある。加えて、文脈が蓄積するにつれ後続の呼び出しごとに入力量が膨らむ。このため、総消費量を実行前に見積もることは難しく、実行の進行に合わせた修正も必要であった。
TokenCastは、実行を区切った各区間について、その区間自身の消費量と、それが文脈に加える増分を「合成可能なコスト表現」として学習する。隣接する区間を合成することで、過去の文脈が後続の呼び出しのたびに再読み込みされることによる追加の入力コストも含めた累積推定が得られる。実行が進んで新たな観測が得られるたびに予測は更新され、この処理に追加のLLM呼び出しは不要である。SWE-bench Verifiedでの実行1回あたりの累積予測時間は平均32.8ミリ秒にとどまる。
評価では、4種類のタスク群と6種類のエージェントモデルによる計96通りの組み合わせで、最も優れた比較手法に対する平均絶対誤差の削減率が平均**14.5%であった。過去の実行記録を再生するオフライン検証では、実行完了率を同水準に保ったまま、固定予算方式より平均21.3%**少ないトークンで済んだ。
ビジネスへの示唆
エージェント型AIの本格導入が進む企業では、従量課金のAPI費用が予測しにくい点が課題となっている。TokenCastのような予測技術は、次の部門と指標に影響し得る。
- 情報システム・開発部門:ソフトウェア修正や保守を担うコーディングエージェントの1タスクあたりコスト、月次のAPI費用予算に対する乖離率
- カスタマーサポート部門:問い合わせ自動対応の1件あたり処理コスト、自動解決率とコストの両立
- 経理・財務部門:AI関連費用の予算差異、費用見通しの精度
- 事業企画部門:AI機能の粗利率、価格設計の妥当性
特にAIエージェントを月額定額や成果報酬で顧客に提供するSaaS事業者にとって、実行前に費用の見込みを得られることは採算管理の要となる。消費量が急増しそうなタスクを早期に検知し、打ち切りや人手への引き継ぎ、軽量モデルへの切り替えを判断できれば、赤字案件の発生を抑えられる。固定予算方式に比べ同じ完了率で約2割少ないトークンで済んだ結果は、こうした運用でコスト削減につながる可能性を示す。
予測の追加負荷が小さい点も実務上の利点である。予測のために別途LLMを呼び出す方式では、監視のコストが本体の費用を押し上げかねない。ミリ秒単位で処理が完了するため、既存のエージェント基盤に組み込みやすい。
今後の展望
今回の成果は過去の実行記録を用いたオフライン検証であり、実運用で予算制御を行った場合の効果は今後の確認事項である。社内の業務特化型エージェントでは、タスクの性質やツール構成が公開ベンチマークと異なるため、自社の実行ログによる再学習や精度検証が必要になる。
一方、コードは公開されており、導入企業は自社環境での試験を始めやすい。AIエージェントの利用が広がるほど、性能だけでなく費用の予見可能性が調達や契約の判断基準になると考えられる。実行ログの蓄積とコスト可視化の体制づくりが、競争力を左右する要素となりそうである。
関連トピック
同セクションの記事
物語状態を追跡するAI、長編小説生成を実現
研究チームが、登場人物や伏線を構造化して追跡する学習不要の枠組みNstAgentを提案した。10万語規模でも整合性と文章品質が低下せず、出版・映像業界の制作工程に影響し得る。
MGFlow、1段階で画像生成し4段階モデル超え
研究チームが、画像生成AIを1回の推論で動かす学習枠組みMGFlowを発表した。FLUX.2 klein 4Bを1段階化し、4段階の元モデルを主要指標で上回り、生成コスト削減の道を開く。
単一LLMが全深度で稼働、学習費12%減
英研究チームは、1回の学習で全20層の各深度が言語モデルとして機能する「TLM」を提案した。品質と計算量の曲線下面積を43〜44%削減し、学習コストも約12%下げた。