AI推論の学習法、無関係な揺らぎを抑制
中国の研究チームが、問題の本質と無関係な表現変化に弱いAIの癖を抑える強化学習手法SCAPOを提案した。小型モデルでも数学推論の精度が向上し、業務AIの安定運用に道を開く。
研究の概要
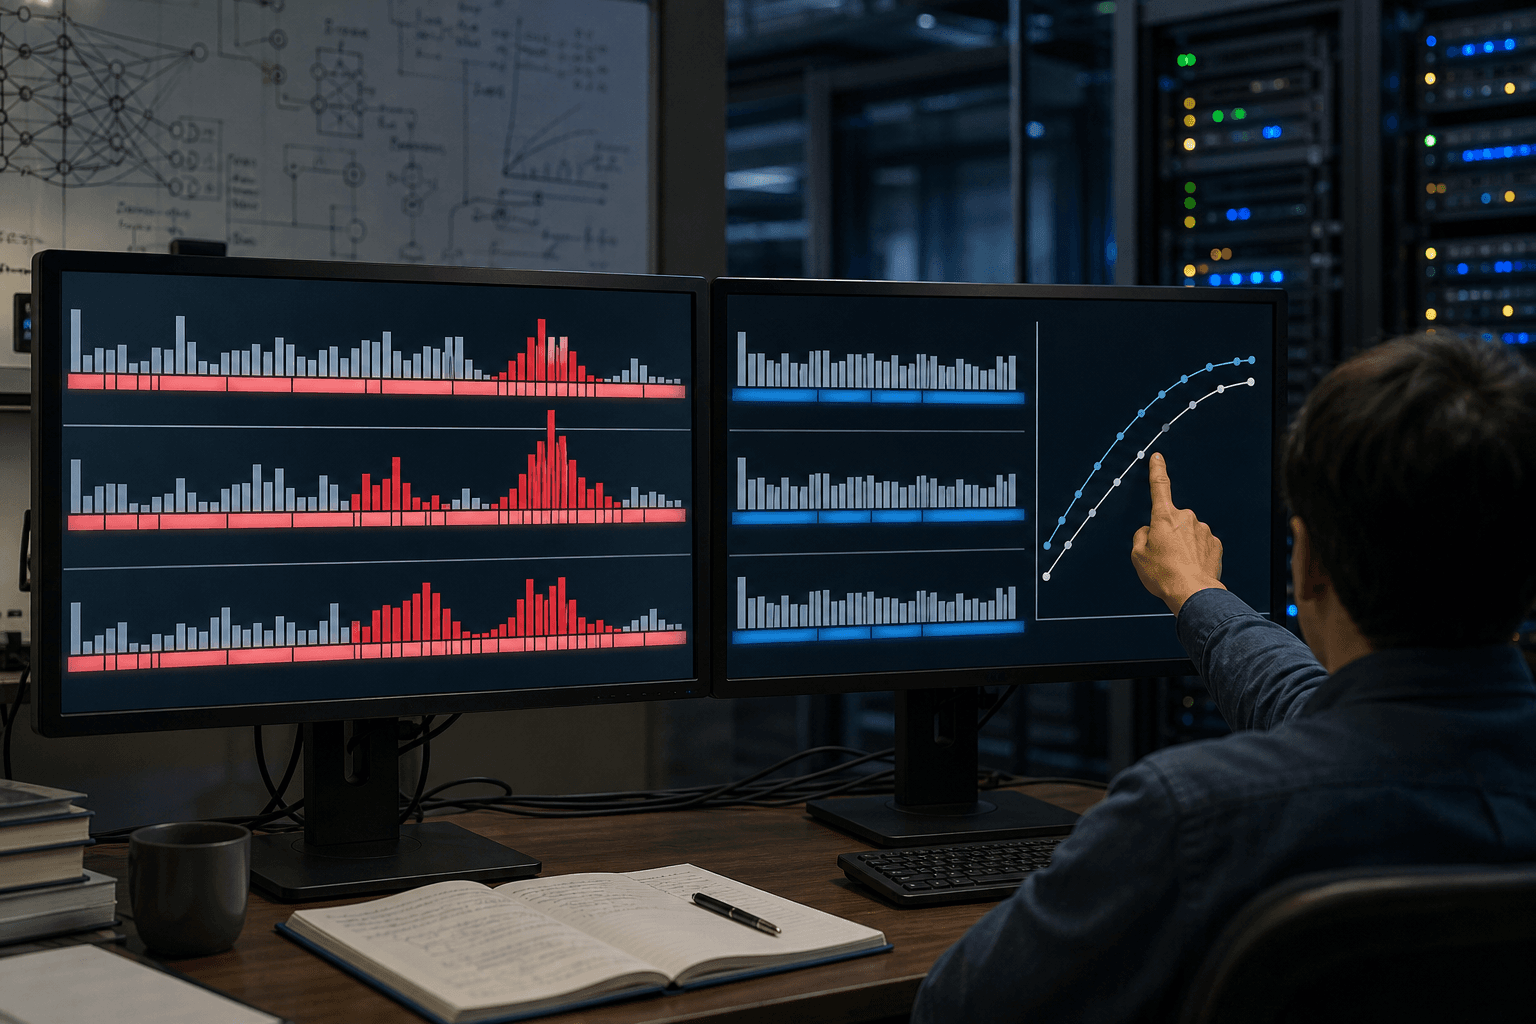
Pan Junshu氏らの研究チームは、大規模言語モデル(LLM)の強化学習における新たな学習手法「SCAPO(半事実的クレジット拡張方策最適化)」を発表した。回答の正誤だけを報酬とする「検証可能な報酬による強化学習(RLVR)」は推論能力を高めてきたが、モデルの予測が問題の本質と無関係な表現に左右される弱点が残っていた。
研究チームはまず、問題の内容と答えを保ったまま表現だけを変える「半事実的介入」を用いて、この感度を分析した。その結果、回答を構成する単語単位(トークン)ごとに、表現変化への敏感さが大きく異なることが判明した。さらに、敏感さの高いトークン候補を生成時に抑えるだけで、モデルの重みを更新せずに推論精度が改善することも確認された。
従来の標準的手法であるGRPOは、正解した回答のすべてのトークンに同じ評価を与える。このため、有用な推論過程と並んで、偶然の手がかりへの依存まで強化してしまう恐れがある。SCAPOは、固定した回答に対する各トークンの確率変動を介入下で測定し、正規化した安定性スコアに基づいて、不安定なトークンの評価を学習初期に引き下げる。安定しているだけでは追加の評価を与えない設計である。
実験結果
Qwen3-4B-BaseとQwen3-1.7B-Baseを用いた実験では、AIME 2024〜2026の正答率がGRPO比でそれぞれ5.63ポイント、4.17ポイント向上した。両規模のモデルで、評価した数学ベンチマークの大半と、分布外ベンチマークのすべてにおいて、比較手法の中で最良の結果を記録した。学習時に見ていない種類の問題でも効果が出た点は、実務適用を考えるうえで重要である。
ビジネスへの示唆
最大の意義は、推論の安定性を学習段階から高められる点にある。表現の違いで回答が変わるAIは、実務で信頼を得にくい。想定される影響領域は次の通りである。
- 金融:与信審査や契約書の要件確認で、同一案件の言い回し違いによる判定ぶれを抑え、再審査率や例外処理件数の削減につながる
- カスタマーサポート:同じ問い合わせの表現差に対する回答一貫性が高まり、一次解決率や誤案内率の改善が見込まれる
- 製造業の品質管理・保守部門:報告書の書式や記述癖に影響されない不具合原因の推定が可能になり、診断精度の向上が期待される
- 法務・コンプライアンス:条文解釈の安定により、レビュー工数と見落とし率の低減が見込まれる
また、1.7Bや4Bといった小型モデルで効果が示された点は、コスト面で重要である。自社データで推論特化モデルを追加学習する企業にとって、大型モデルの利用料に頼らず、オンプレミスや自社クラウド上で運用できる選択肢が広がる。推論コストや応答遅延の抑制は、AI導入のROIを左右する指標である。
実務での評価指標としては、同一問題を言い換えた入力群での回答一致率を新たに設けることが有効と考えられる。研究が示した半事実的介入は、そのまま品質検証のテスト設計にも転用できる。AIガバナンス部門にとっては、精度だけでなく頑健性を監査項目に加える根拠となる。
今後の展望
課題も残る。今回の検証は数学推論が中心であり、契約文書や顧客対応のような自然言語業務で同等の効果が得られるかは未確認である。また、介入のために追加の計算が必要となり、学習コストの増加が事業採算に与える影響は個別に見極める必要がある。モデル規模も小型に限られ、より大規模なモデルでの有効性は今後の検証課題である。
一方、研究チームはコードをGitHubで公開しており、自社での再現と検証は容易である。AIの性能競争が精度から信頼性へ軸足を移すなか、トークン単位で学習信号を精緻化する発想は、業務特化型AIの開発手法として注目を集める可能性が高い。
関連トピック
同セクションの記事
観測データから変数の重要度を測る新手法
実験設計なしで既存データから入力変数の影響度を推定する手法MM-GSAが提案された。二つの指標で変数の重要性を捉え、実務の要因分析や変数選択の精度向上に資する可能性がある。
物理言語で動画生成、Veo3.1を上回る
動画生成AIの物理的な不整合を、物理現象を記述する言語表現の自己改善で抑える枠組みPhysis-Langが提案された。オープンモデルが商用最上位のVeo 3.1を上回り、製造やロボティクスの合成データ活用に影響する。
画像と言語を一体生成する新基盤モデル登場
華中科技大学などの研究チームが、言語と画像を連続的な埋め込み空間で一体的に扱う生成モデル「Multimodal Flow」を発表した。1500億トークンの学習で競合に迫り、基盤モデル開発費の抑制につながる可能性がある。