動画生成AI、ゲーム規則への忠実度を測る指標
研究チームが、プログラムで定めた世界の出来事を動画生成AIがどこまで正確に描くかを測る新評価基準PROWBenchを公開した。ゲーム開発の品質管理に影響し得る。
研究の概要
Zheng-Hui Huang氏らの研究チームは、動画生成モデルがプログラムで指定された世界の規則や出来事をどこまで忠実に映像化できるかを検証するベンチマーク「PROWBench」を発表した。論文はarXivに公開されている。
近年、実行可能な物理・ゲーム規則と映像生成を分離する「プログラム可能な世界モデル」が、次世代ゲームエンジンの基盤として注目されている。しかし従来の評価基準は、画質、操作性、指示への適合、物理的な妥当性を測るにとどまり、細かな世界の出来事が指定どおりに描かれているかは十分に検証されてこなかった。
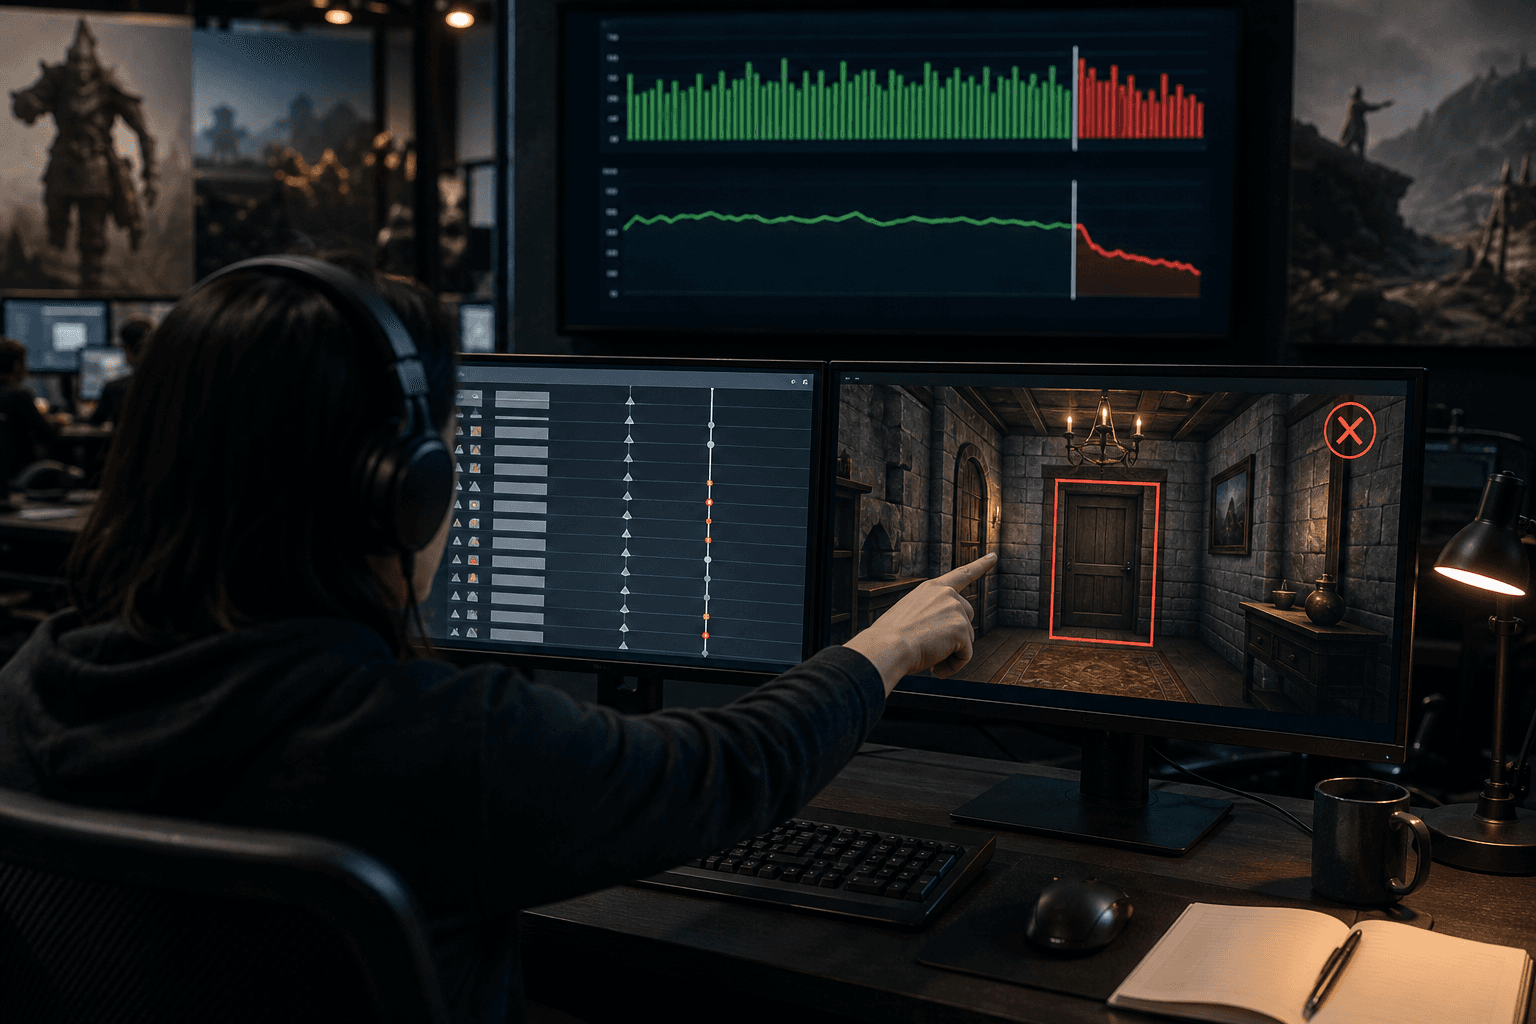
PROWBenchは、プログラムで構築した170のエピソードと600の代理動画で構成される。各エピソードでは、エンティティの状態と時刻付きの出来事を、カメラの視野外で起きたものも含めて「再生可能な世界記録」として保存する。この記録から同期した複数視点の映像を生成し、粗い3Dや境界ボックスなど異なる表現で出力できる。これにより、生成された動画を、プログラム実行の結果として観察されるはずの内容と照合できる。一人称と三人称の視点を扱い、一部のエピソードでは複数視点の同期観測も提供される。
評価項目は、エンティティの制御、長期の記憶、そして2種類のVLM(視覚言語モデル)ベースの指標である。Logic-Render Alignmentは規定された時系列への適合を、Interaction Success Rateは記録された出来事の視覚的な実現度を測定する。
ビジネスへの示唆
最も直接的な影響を受けるのはゲーム産業である。ゲームでは、アイテムの取得、扉の開閉、敵の撃破といった規則上の出来事が画面上で正しく表示されなければ、プレイヤーの不信を招く。生成AIをレンダリング層に採用する場合、画質だけでなく規則との一致を定量確認する手段が必要になる。PROWBenchの指標は、その品質保証(QA)工程の自動化に応用し得る。
影響が見込まれる部門と指標は次のとおりである。
- 開発・QA部門:不具合検出率、リグレッションテストの工数、リリース前の手戻り件数
- 技術選定を担う研究開発部門:候補モデルの比較に用いる規則忠実度スコア
- 運営・サポート部門:表示不整合に起因する問い合わせ件数、プレイ継続率
応用は娯楽に限られない。工場や物流倉庫のデジタルツイン、自動運転やロボットの学習用シミュレーションでは、シミュレータの状態と生成映像の整合が学習データの信頼性を左右する。製造業の生産技術部門や自動運転の開発部門では、映像が物理イベントを正しく反映しているかの検証が、学習データの品質管理指標になる可能性がある。視野外の出来事を含む長期記憶の評価は、状況が長時間にわたり継続する監視や訓練用途で特に意味を持つ。
また、映像生成ツールを導入する広告・映像制作の現場でも、台本どおりの演出が再現されているかを確認する基準として、同様の考え方を転用できる。
今後の展望
本ベンチマークは拡張可能な枠組みとして設計されており、シーン構築や挙動制御を追加できる。今後、評価対象のモデルが増えれば、モデル選定の共通尺度として定着する可能性がある。
一方で、評価の一部をVLMに依存するため、判定器自体の誤りが結果に影響し得る点には留意が必要である。170エピソードという規模も、実運用の多様な状況を網羅するには限りがある。企業が導入する際は、自社の規則や対象領域に合わせたエピソードの追加と、人手による検証の併用が現実的な運用となる。
関連トピック
同セクションの記事
SILSA、3D生成のトークンを98%超削減
米研究チームは、3D形状を重なり合う断面の潜在表現で捉える生成手法SILSAを発表した。トークン数を大幅に減らし、推論時間を58.5%短縮する。3D資産制作のコスト構造を変え得る成果である。
ロボット、重み更新なしで成功率95%に自己改善
Yen-Jen Wang氏らは、モデルの重みを更新せず、シミュレーション上の練習でロボットの作業スキルを自律的に改善する枠組みRPGを発表した。22タスクの成功率は28.6%から95.0%に向上した。
人間視点映像でロボット学習、効く条件を解明
中国の研究チームが、人間の一人称視点データがロボット学習に効く条件を検証した。データ量より動作の整合性や多様性が重要と判明し、ロボット導入費用の抑制につながる。