画像AIの転用で動画学習を大幅効率化
画像用ViTを転用し、ラベルなし動画から特徴を学ぶ手法VideoMSNが登場した。事前学習の回数を最大160分の1に抑えつつ主要ベンチマークで最高性能を達成し、動画AIの開発コストを下げる可能性がある。
研究の概要
Owais Iqbal氏らの研究チームは、ラベルのない動画から時空間の特徴を学ぶ自己教師あり学習の枠組み「VideoMSN」を発表した。重い3次元アーキテクチャーや、画像を再構成するオートエンコーダーに頼らず、標準的な画像用Vision Transformer(ViT)をそのまま活用する点に特徴がある。
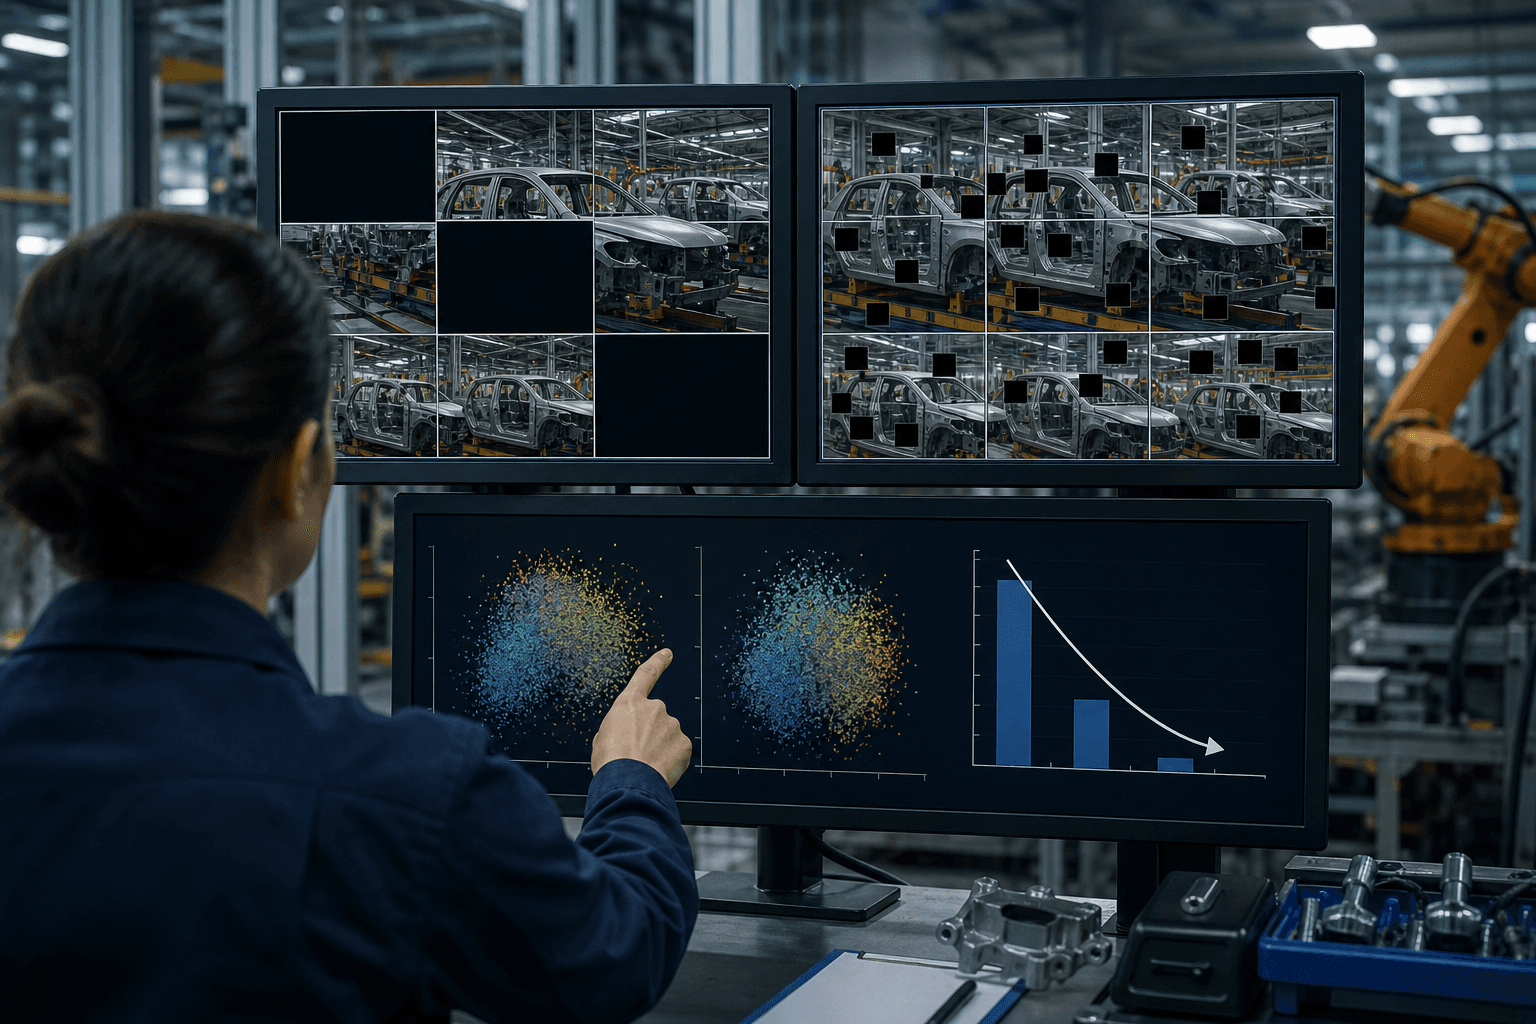
手法の核は、動画から抽出した複数のフレームを格子状に並べて1枚の画像として扱う「スーパー画像」である。この1枚から2種類の見方を作る。一方は空間方向のパッチを隠し、他方は時間方向のフレームを隠す。両者を共有のViTエンコーダーに通し、埋め込み表現が一致するようにMasked Siamese損失で学習させる。フレーム間で情報が漏れない設計により、動きと見た目の両方の手がかりを、再構成なしで獲得できる。
デコーダーを持たない構成で、既存の画像基盤モデルであるDINO-v3とDeiT-v3を出発点とする。その結果、行動認識の代表的指標であるKinetics-400、UCF101、HMDB51で最高水準の性能を記録した。従来の動画自己教師あり学習と比べ、動画での事前学習エポック数は最大32分の1から160分の1で済む。ラベルが乏しい低ショット分類でも高い性能を示し、学習した表現の転用性が確認された。
ビジネスへの示唆
最大の意義は、動画AIの学習に要する計算資源と時間を大きく削減できる点にある。動画の事前学習は、画像に比べて計算量が桁違いに大きく、資金力のある大手に有利とされてきた。エポック数が数十分の1から百数十分の1になれば、中堅企業や研究部門でも自社データによる事前学習が現実的な選択肢となる。
影響が見込まれる主な領域は次のとおりである。
- 製造業の品質管理・設備保全部門:ラインの映像から作業の異常や不良の兆候を検知する際、正解ラベルの付与工数を減らせる。KPIは検査の見逃し率、ラベリング費用、モデル立ち上げ期間である。
- 小売・物流の現場運営部門:店舗や倉庫のカメラ映像から、顧客動線や作業手順の逸脱を把握する。KPIは作業時間、棚前滞留の分析精度、事故件数である。
- 医療・介護:歩行や動作の映像から転倒リスクを評価する用途が考えられる。専門家によるラベル付けが高コストな領域ほど、低ショットでの性能が効く。
- メディア・マーケティング部門:動画コンテンツの分類やタグ付け、推薦に使い、運用工数と検索精度を改善できる。
既存の画像モデルの資産を活用できる点も重要である。画像用ViTを運用している企業は、モデル構造を大きく変えずに動画対応へ拡張できる可能性がある。専用の3次元モデルを新規に導入する場合に比べ、推論基盤や開発体制の見直しが小さくて済み、導入までの期間短縮が期待される。
今後の展望
留意すべき点もある。評価は公開ベンチマークでの行動認識が中心であり、工場や店舗といった実環境の映像、長時間の動画、固定カメラ特有の偏りへの適合は、個別の検証が必要である。スーパー画像は抽出できるフレーム数に限りがあり、長い工程の把握には工夫を要する可能性がある。また、基盤となるDINO-v3などのライセンス条件は、商用利用の前に確認すべきである。
一方で、画像基盤モデルを動画へ低コストで広げる方向性は、今後の競争軸になるとみられる。企業にとっては、まず自社の未ラベル動画の蓄積状況を点検し、少量のラベルで効果を測る小規模な検証から着手することが現実的である。ラベリング費用と立ち上げ期間の削減幅を指標とした費用対効果の把握が、本格導入の判断材料となる。プロジェクトページも公開されており、実装の入手可否が普及の速度を左右するとみられる。
関連トピック
同セクションの記事
人間視点映像でロボット学習、効く条件を解明
中国の研究チームが、人間の一人称視点データがロボット学習に効く条件を検証した。データ量より動作の整合性や多様性が重要と判明し、ロボット導入費用の抑制につながる。
汎用AI、3D組立で完全成功は6割にとどまる
汎用AIエージェントに視覚操作で3D部品を組み立てさせる評価環境が公開された。最良系統でも部品単位の正答率は80.9%、完成品の成功率は59.4%にとどまり、製造現場への適用には精度面の課題が残る。
ロボット制御の表現設計、成功率93.6%達成
中国の研究チームが、ロボットの行動と未来予測を同時に学ぶ世界行動モデル「ReWAM」を発表した。動画生成の事前学習なしで高い成功率を示し、開発コスト低減の道を開く。