物理言語で動画生成、Veo3.1を上回る
動画生成AIの物理的な不整合を、物理現象を記述する言語表現の自己改善で抑える枠組みPhysis-Langが提案された。オープンモデルが商用最上位のVeo 3.1を上回り、製造やロボティクスの合成データ活用に影響する。
研究の概要
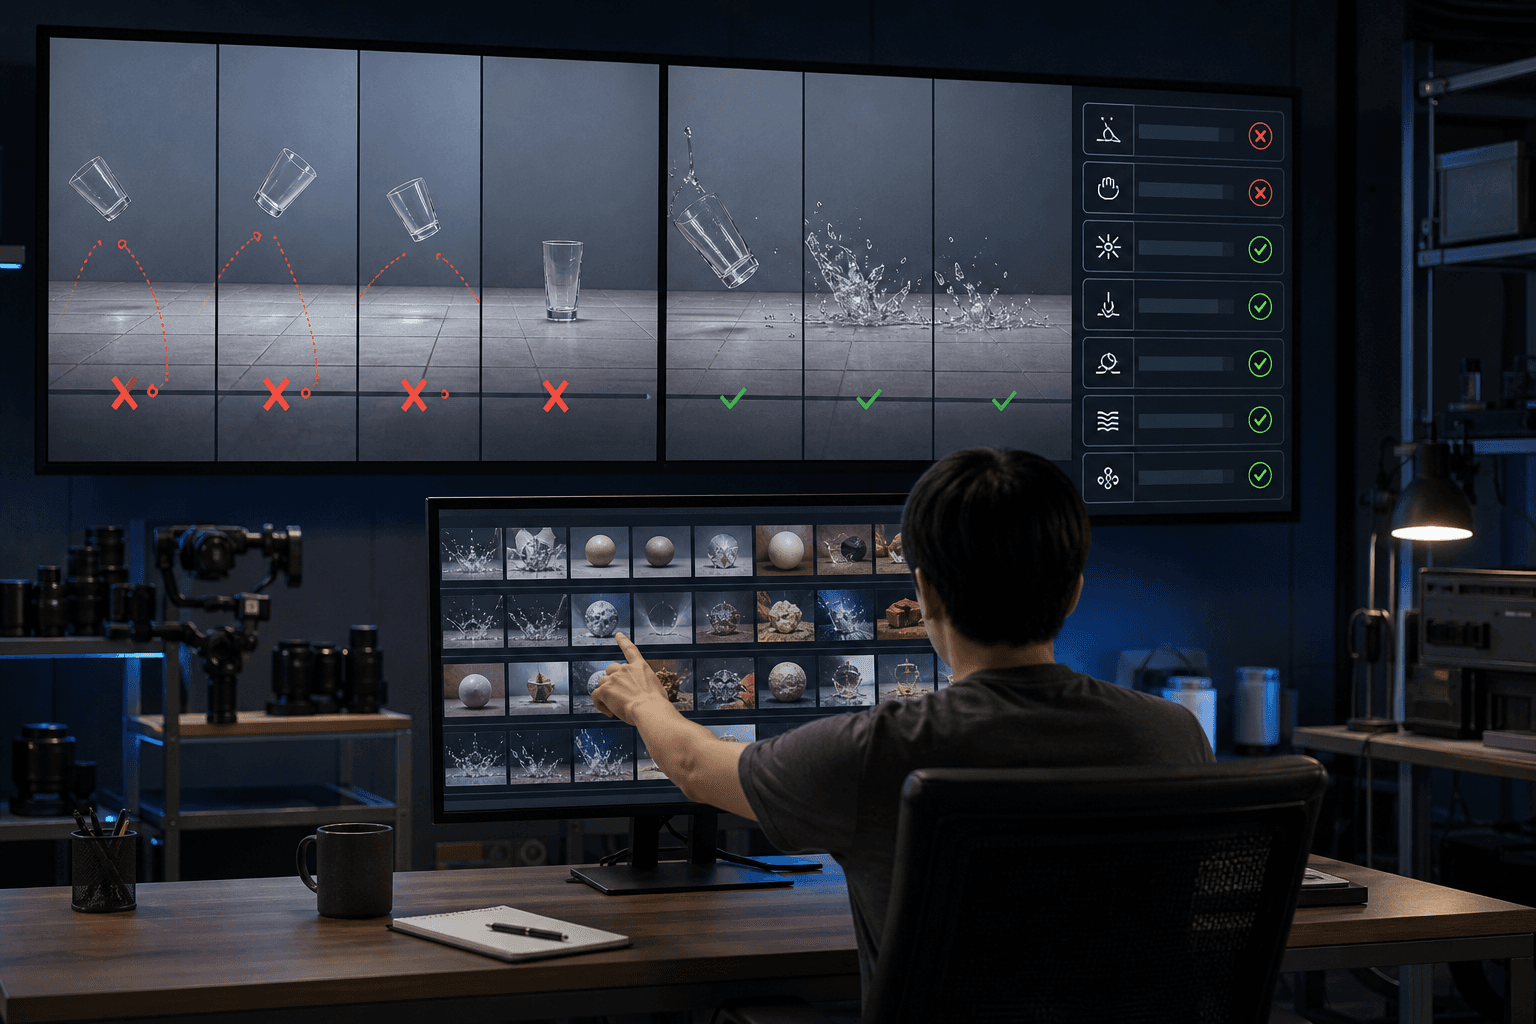
Liming Lu氏、Song Han氏、Han Cai氏ら17人の研究チームは、動画世界モデルの物理的な破綻を抑える枠組みPhysis-Langを発表した。動画世界モデルとは、物理世界の時間的な変化を予測して映像として生成するAIである。見た目は自然でも、物体が不自然に変形したり、因果関係が逆転したりする問題が残っていた。
従来の手法は、自然言語では物理知識を十分に表現できないと考え、視覚特徴、潜在表現、数値、計画に基づく追加信号を導入してきた。研究チームはこの前提を見直し、言語そのものを最適化可能な共通表現として扱った。物理現象は、関係する対象、原因、相互作用、支配原理、時間的な推移、結果の6要素で記述される。
言語表現の品質を高めるため、評価基準PhysCapBenchも構築した。物理現象を最小単位の主張に分解し、キャプションの再現率と適合率で採点する。さらにエージェントが主張単位の誤りを分析し、キャプション生成の指示文を反復的に改善する。
学習データ選定への応用
Physis-Langは、モデルの弱点も文章に変換する。不足している物理過程を言語で記述し、その言語を手がかりに、視覚的に多様な動画を検索して学習データに加える。データの作成、モデルの学習、動画の生成という3段階を、同じ言語表現でつなぐ点が特徴である。
WanとCosmosの基盤モデルを用い、広く使われる4つの物理動画ベンチマークで検証した結果、物理的な妥当性が一貫して向上した。特に、オープンソースのCosmos3-Nanoを基にした強化モデルは、商用最上位とされるVeo 3.1を上回った。
ビジネスへの示唆
最大の意義は、巨大な商用モデルに依存せずとも、データ選定と言語表現の改善で物理的な信頼性を高められる点にある。影響を受ける領域は次のとおりである。
- 製造業の生産技術部門:工程シミュレーションや異常事象の合成映像の生成。検査工程の不良検出率や、学習データ収集コストが指標となる。
- ロボティクス・自動運転の開発部門:危険場面の合成データ作成。実機走行試験の回数削減や、稀少事象の網羅率が指標となる。
- 広告・映像制作の制作部門:物理的な違和感による再撮影や修正の工数削減。1本当たりの制作費と修正回数が指標となる。
- 教育コンテンツ部門:理科実験や安全教育の映像生成。誤った現象表示によるクレーム件数が指標となる。
オープンモデルで商用最上位を超えた点は、調達戦略にも影響する。API利用料や外部サービスへのデータ送信を避けたい企業は、自社環境で運用できるモデルを選択肢に加えやすくなる。機密性の高い工場映像や設計情報を扱う企業にとって、情報管理上の利点も大きい。
実務面では、モデルの弱点を文章で記述し、不足データを検索で補う手順が参考になる。再学習の前に、どの物理現象で失敗しているかを主張単位で可視化できれば、データ収集の優先順位を定量的に決められる。品質管理部門が評価の指標を設計し、開発部門が補強データを選ぶという分業も成立する。
今後の展望
課題も残る。評価は4つの公開ベンチマークが中心であり、特定の工場設備や医療機器など、専門性の高い領域で同等の効果が得られるかは未検証である。言語で記述できない微細な力学や、定量精度が求められる用途では、数値シミュレータとの併用が引き続き必要になる。また、エージェントによる指示文の改善には計算コストがかかるため、導入時には費用対効果の確認が欠かせない。
それでも、物理的な整合性を言語という解釈可能な形で管理できる意義は大きい。誤りの原因を人間が読み取り、修正の方針を検討できるため、監査や品質保証の説明責任にも適合しやすい。動画世界モデルの業務利用が広がるなか、評価指標とデータ選定を一体で運用する手法は、実装の標準になる可能性がある。
同セクションの記事
観測データから変数の重要度を測る新手法
実験設計なしで既存データから入力変数の影響度を推定する手法MM-GSAが提案された。二つの指標で変数の重要性を捉え、実務の要因分析や変数選択の精度向上に資する可能性がある。
AI推論の学習法、無関係な揺らぎを抑制
中国の研究チームが、問題の本質と無関係な表現変化に弱いAIの癖を抑える強化学習手法SCAPOを提案した。小型モデルでも数学推論の精度が向上し、業務AIの安定運用に道を開く。
画像と言語を一体生成する新基盤モデル登場
華中科技大学などの研究チームが、言語と画像を連続的な埋め込み空間で一体的に扱う生成モデル「Multimodal Flow」を発表した。1500億トークンの学習で競合に迫り、基盤モデル開発費の抑制につながる可能性がある。