動画内文字の編集、評価基準を整備
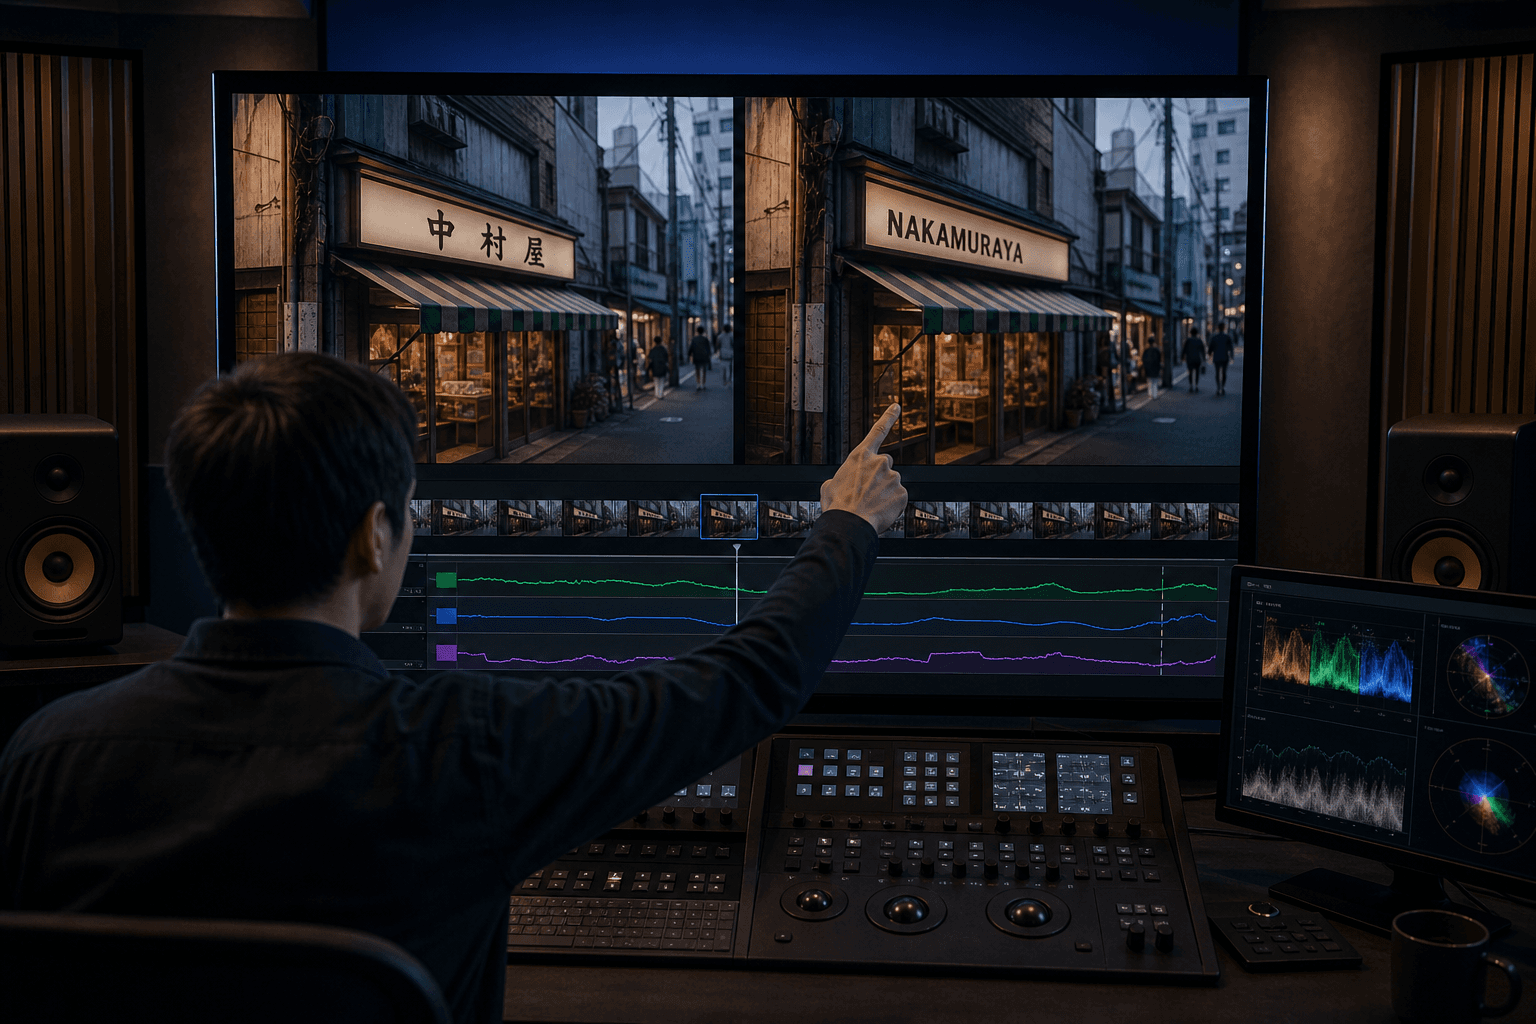
動画内の看板やラベルの文字を、背景の動きを保ったまま差し替える技術の評価基準「ViTeX-Bench」が公開された。広告やEC、多言語展開の制作工程を変え得る基盤として注目される。
研究の概要
Chen氏らの研究チームは、動画中の店舗看板、ホワイトボード、商品ラベルなどの文字を書き換える「動画シーンテキスト編集」の評価基盤「ViTeX-Bench」を公開した。動画生成の品質向上が進む一方、元の場面の動きやカメラワークを保ったまま局所的に編集する技術は未成熟である。画像では文字編集の研究が進むが、動画では十分な比較手段がなかった。
中核となるのは、実写の720p動画387本から成るデータセットである。各動画には文字領域のマスクと編集指示が付く。うち230本には、審査済みの対になる編集結果が付属し、学習に使える。残る157本は評価専用に固定された。
評価は三つの軸で行う。文字が正しく表示されているか、画質と時間方向の安定性、編集範囲が意図した箇所に収まっているかである。計13指標を使い、各軸に主指標を置いた上で、トレードオフをパレート比較で示す。OCR(文字認識)の較正や人手評価も併用し、数値の解釈を支える設計である。
主要な結果
4系統の編集手法に属する8種類の基準手法を比較した結果、正確な文字、時間的な安定性、背景の保存を同時に満たすことは依然として難しいと判明した。研究チームは参照用の編集モデル「ViTeX-Edit-14B」も公開した。動きに合わせた文字映像を条件として与える方式で追加学習したもので、文字正解率(CharAcc)は0.688と、動画ネイティブの編集手法の中で平均最高となった。生成物の文字のゆらぎを示す指標でも、編集器の生出力として最小の値を記録した。ただし文字正解率が0.7を下回る点は、実用水準にまだ距離があることも示す。
ビジネスへの示唆
最も影響を受けるのは、広告・マーケティング部門と動画制作部門である。同一の映像素材について、国や地域ごとに看板や商品パッケージの表記を差し替えられれば、再撮影のコストと期間を圧縮できる。KPIとしては、1本あたりの制作費、ローカライズのリードタイム、地域別クリエイティブの本数が挙げられる。
小売・EC業界では、商品紹介動画のラベルや価格表示を、キャンペーン単位で更新する用途が想定される。表示の誤りは景品表示法上のリスクにも直結するため、価格や成分表記の正確性という観点で、文字正解率が品質管理指標となる。
映画・配信業界では、ポストプロダクションでの字幕とは別に、画面内の看板文字を多言語化する作業が対象となる。手作業のVFX工程の削減は、納期短縮と制作原価の低減に結びつく。
導入を検討する企業にとって、今回の評価基盤は選定の物差しとして機能する。ベンダーの自己申告ではなく、文字の正確さ、安定性、編集の局所性という三軸で比較できるためである。
- 法務・コンプライアンス:改変動画の表示内容の検証と、改変の事実の開示ルール整備
- 調達・情報システム:編集ツールの比較評価と、オープンソース版の自社運用可否の検討
- ブランド管理:ロゴや商標文字の改変に関する承認フローの設計
今後の展望
現状の最良モデルでも文字の誤りが残るため、当面は人手による確認を前提とした半自動の運用が現実的である。一方で、評価基盤と学習用データが公開されたことで、各社が自社の素材で追加学習し、性能を検証する道が開けた。データ規模が387本にとどまる点は課題であり、業種固有の素材での検証が欠かせない。
編集技術の高度化は、偽情報や不正な改変への懸念も伴う。企業には、編集履歴の記録や来歴の証明といったガバナンスの整備が求められる。評価基準が共有されることで、技術の選定と統制の双方で、判断の根拠が得られる意義は大きい。
関連トピック
同セクションの記事
画素拡散AI、敵対的学習で細部を復元
米アドビなどの研究チームは、画素拡散モデルに敵対的学習を後付けし、構造を変えず画像の微細な質感を回復させる手法を示した。生成画像の品質向上を低コストで狙える点が注目される。
画像生成AI、自己修正力を強化学習で獲得
香港中文大学系などの研究チームは、画像を見て自ら描き直す統合モデルに強化学習を適用する手法を開発した。外部の検証器なしで生成品質が向上し、実務展開の負担軽減が期待される。
動画生成の高速化手法PDMDが品質劣化を抑制
動画拡散モデルを4回の推論で動かす蒸留手法に、学習の劣化を抑える新手法PDMDが登場した。コード1行の変更で品質が向上し、動画制作の生成コスト削減に寄与する可能性がある。