AI×経営戦略
PathFM、需要予測の将来経路を高速生成
AWS関連の研究チームが、時系列の将来経路を丸ごと生成する予測モデルPathFMを開発した。分位点モデル1回分に近い時間で複数経路を出せ、累積需要やピーク負荷の見積もりを変え得る。
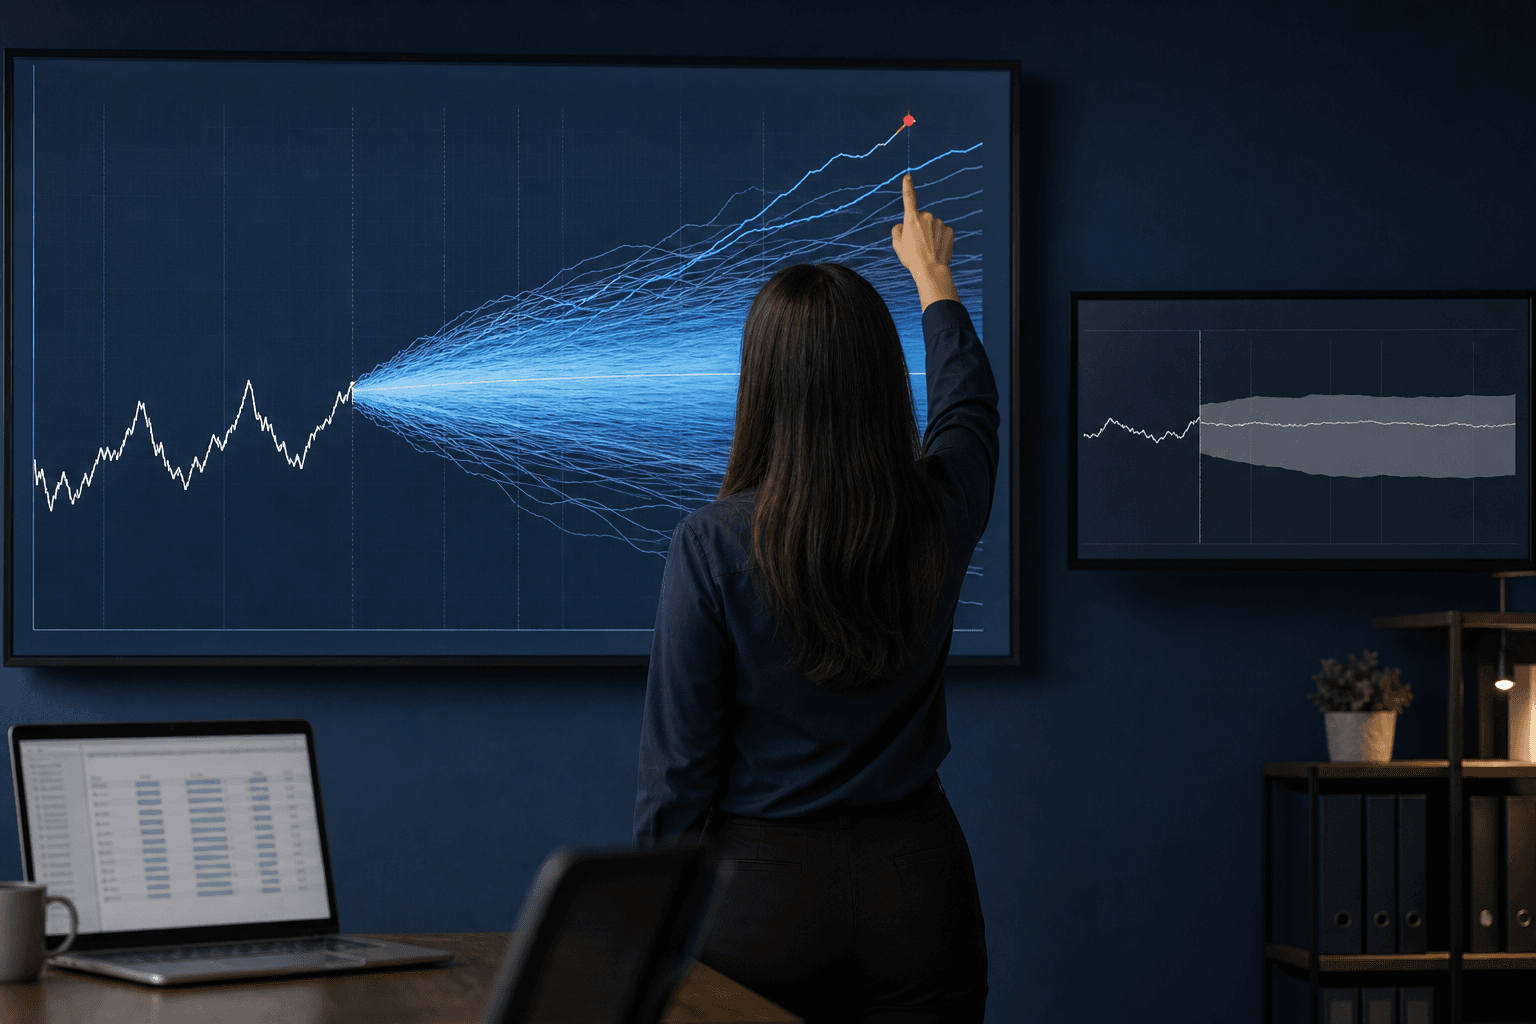
10本掲載
AWS関連の研究チームが、時系列の将来経路を丸ごと生成する予測モデルPathFMを開発した。分位点モデル1回分に近い時間で複数経路を出せ、累積需要やピーク負荷の見積もりを変え得る。
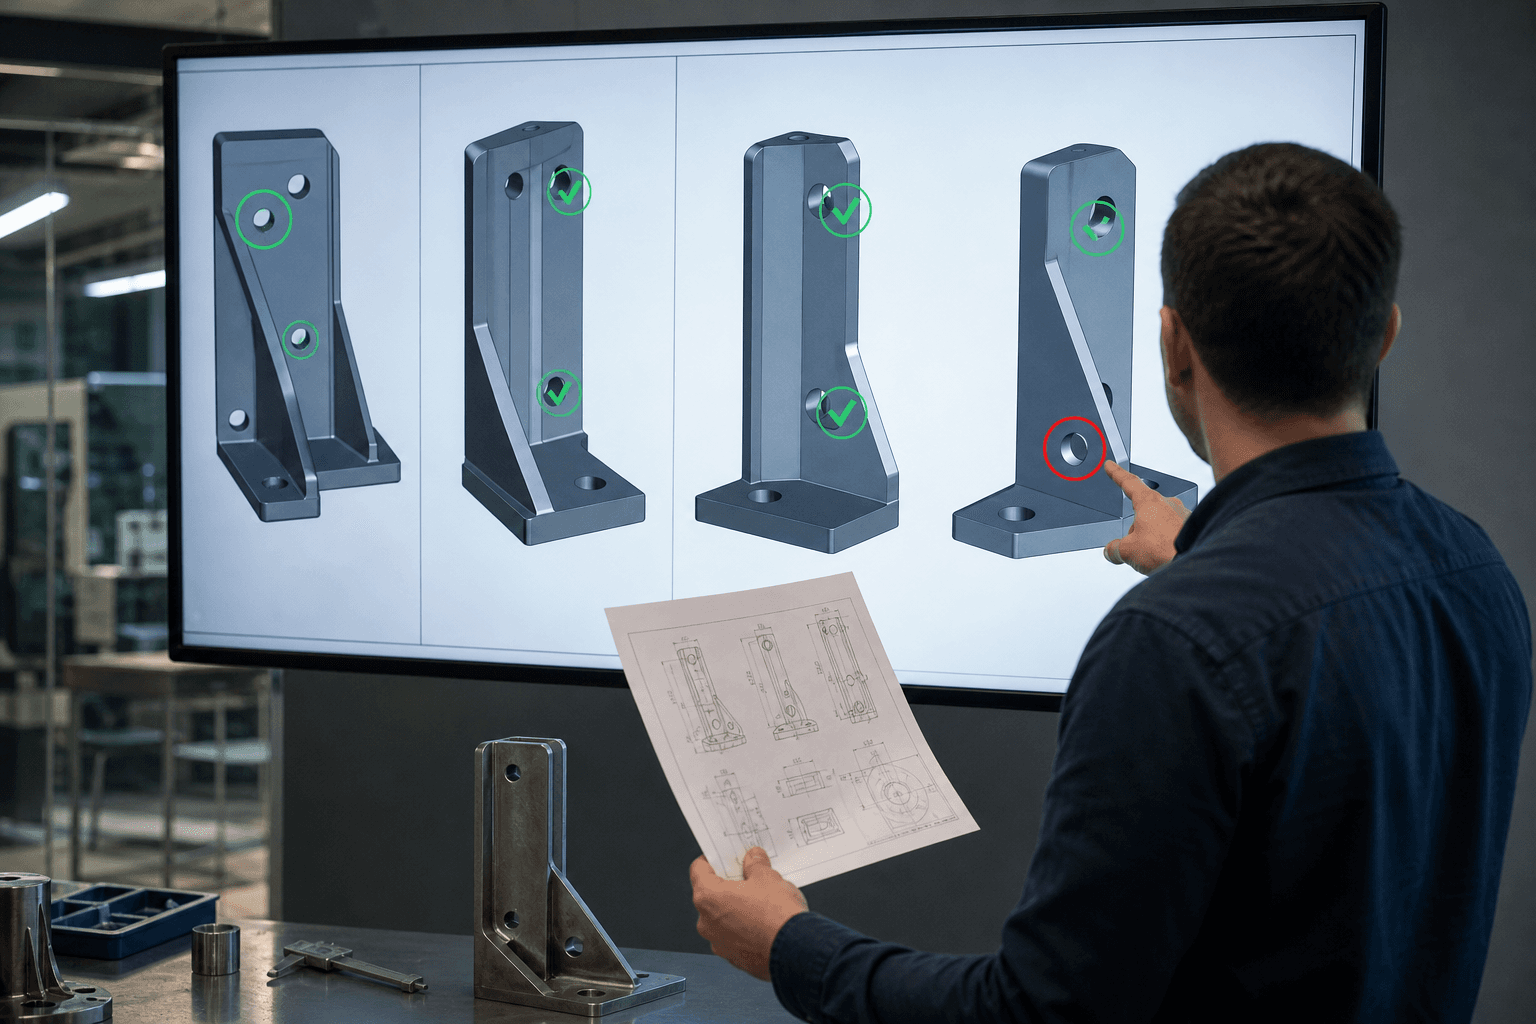
研究チームは、生成した3Dが依頼どおりかをAIが多視点で検証し、不合格の理由も説明するベンチマークとデータ工程を公開した。検証を生成に組み込むと、全要件の達成率が大きく上がることも示した。
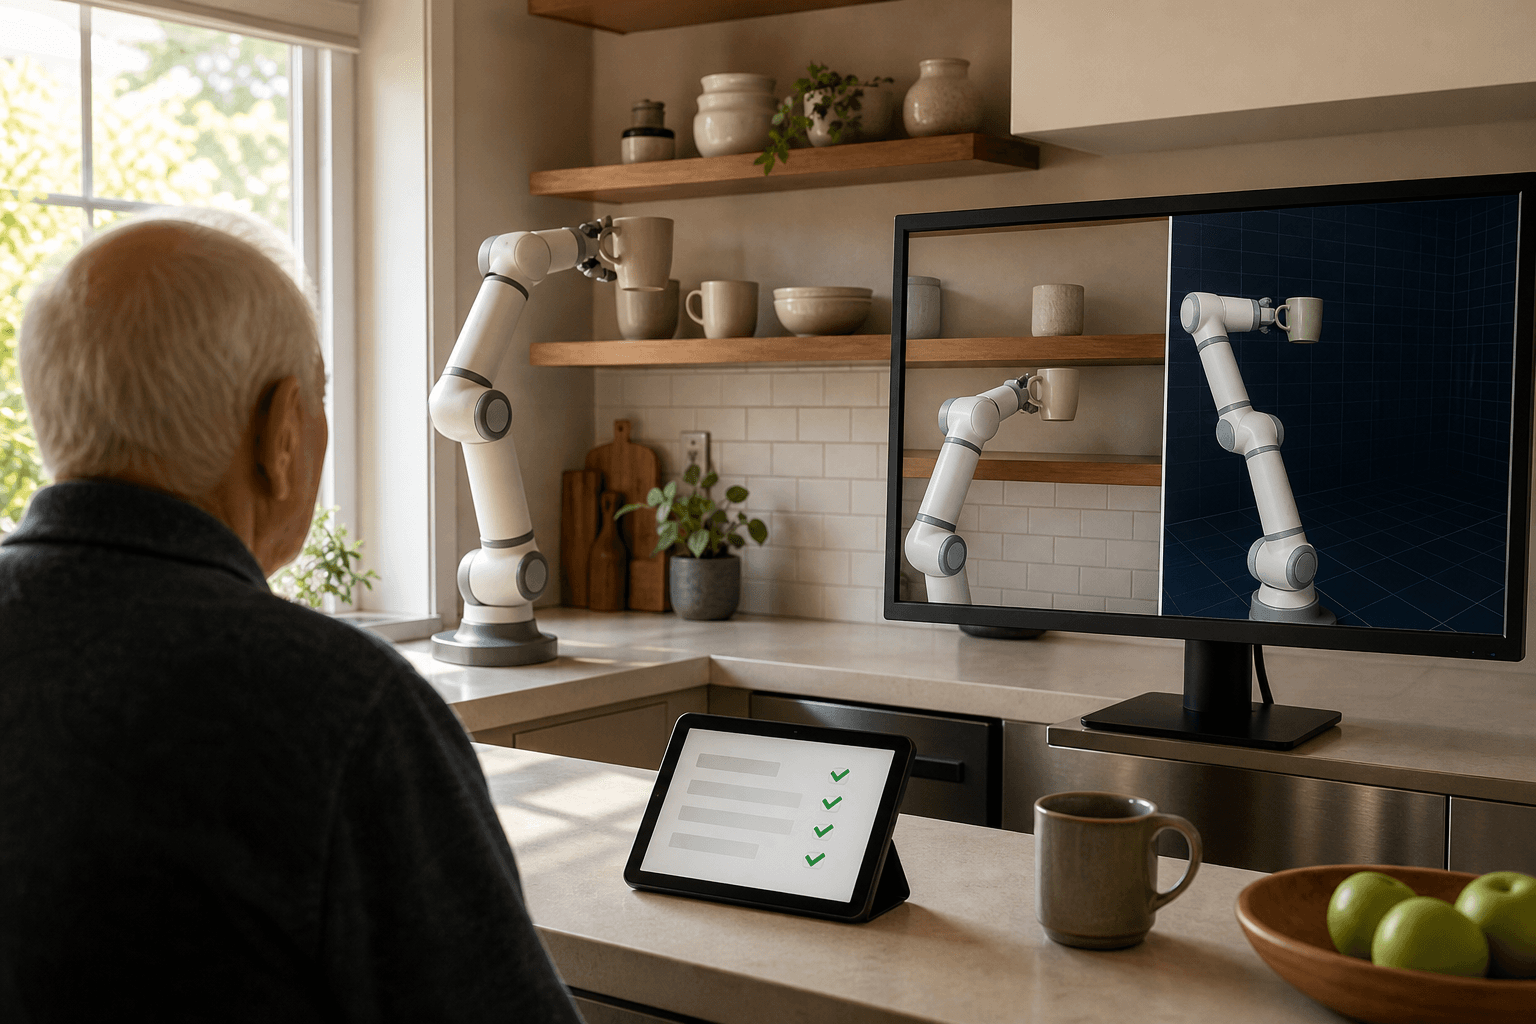
シミュレーション環境の生成とロボット方策を共に進化させる枠組みCoDAが登場した。方策の失敗を診断して訓練環境を作り、未知条件での成功率を5.3%から27.6%に高めた。
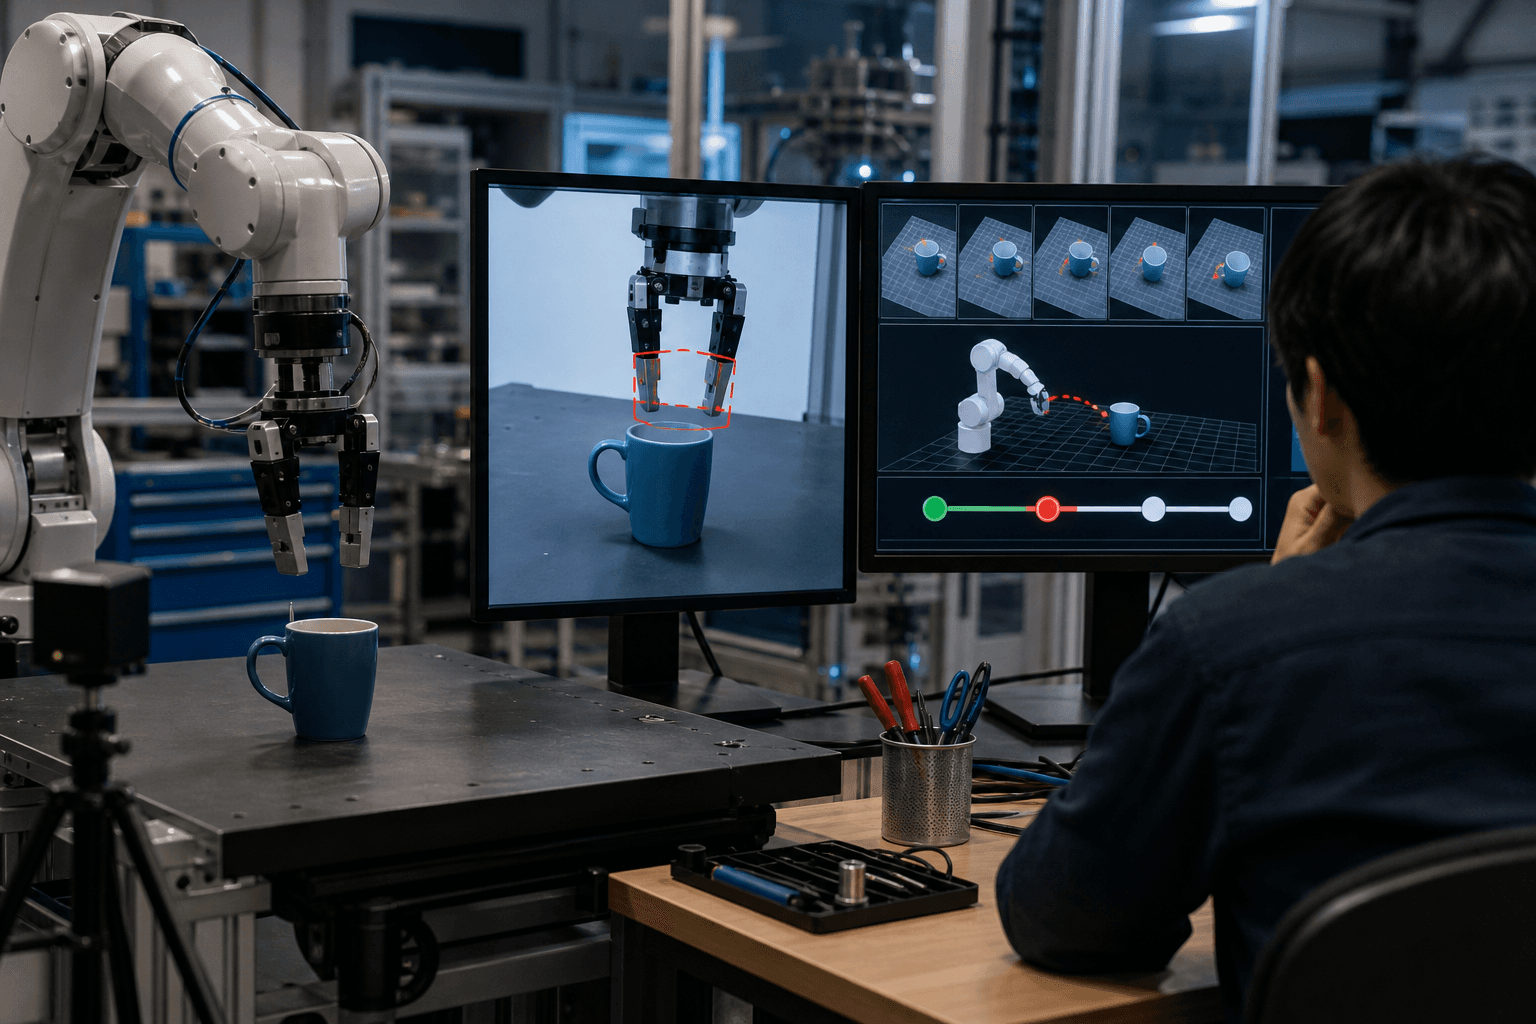
P3-WAMは手の3D動作の復元、行動に応じた映像予測、目標に向けた計画を単一モデルで担う。一括学習で3機能とも単独学習を上回り、現場動画の活用や作業自動化への道を広げる。
スタンフォード大などの研究チームは、摩擦や質量など見えない環境条件を、現場での試行から推定するロボット世界モデルT2-Zを開発した。物体予測誤差は半減し、行動成功率は約2倍となった。
ハーバード大などの研究チームが、LLMに回路を提案させ独立の評価器で検証する進化的手法を開発した。8課題中7課題で最先端よりToffoli数と量子ビット数を削減した。
画像・動画の生成AIで、計算結果の再利用量を段階的に調整する新手法SoftCacheが登場した。再学習なしで3.5〜6.9倍に高速化し、画質指標も既存手法を上回る。
韓国の研究チームが、画像生成AIの計算を間引く際に「どこを残すか」を生成過程の動きから判断する手法DaTMeを提案した。再学習なしで背景や細部の崩れを抑え、高速化と品質の両立を狙う。
動画生成AIを、映像から奥行きやカメラ動作、物体の動きを一度に読み取る「4D知覚器」へ転用する枠組みGen4Pが登場した。専用の知覚モデルを別途育てずに済む可能性を示す。
研究チームは、ロボットが利用者ごとの好みをどこまで学べるかを測るベンチマーク「LIBERO-PeRM」を公開した。現行モデルは事前学習だけでは好みに従えず、現場適応の評価基盤として重要である。