AI×経営戦略
3D空間の伝送量を大幅削減、特徴量符号化が登場
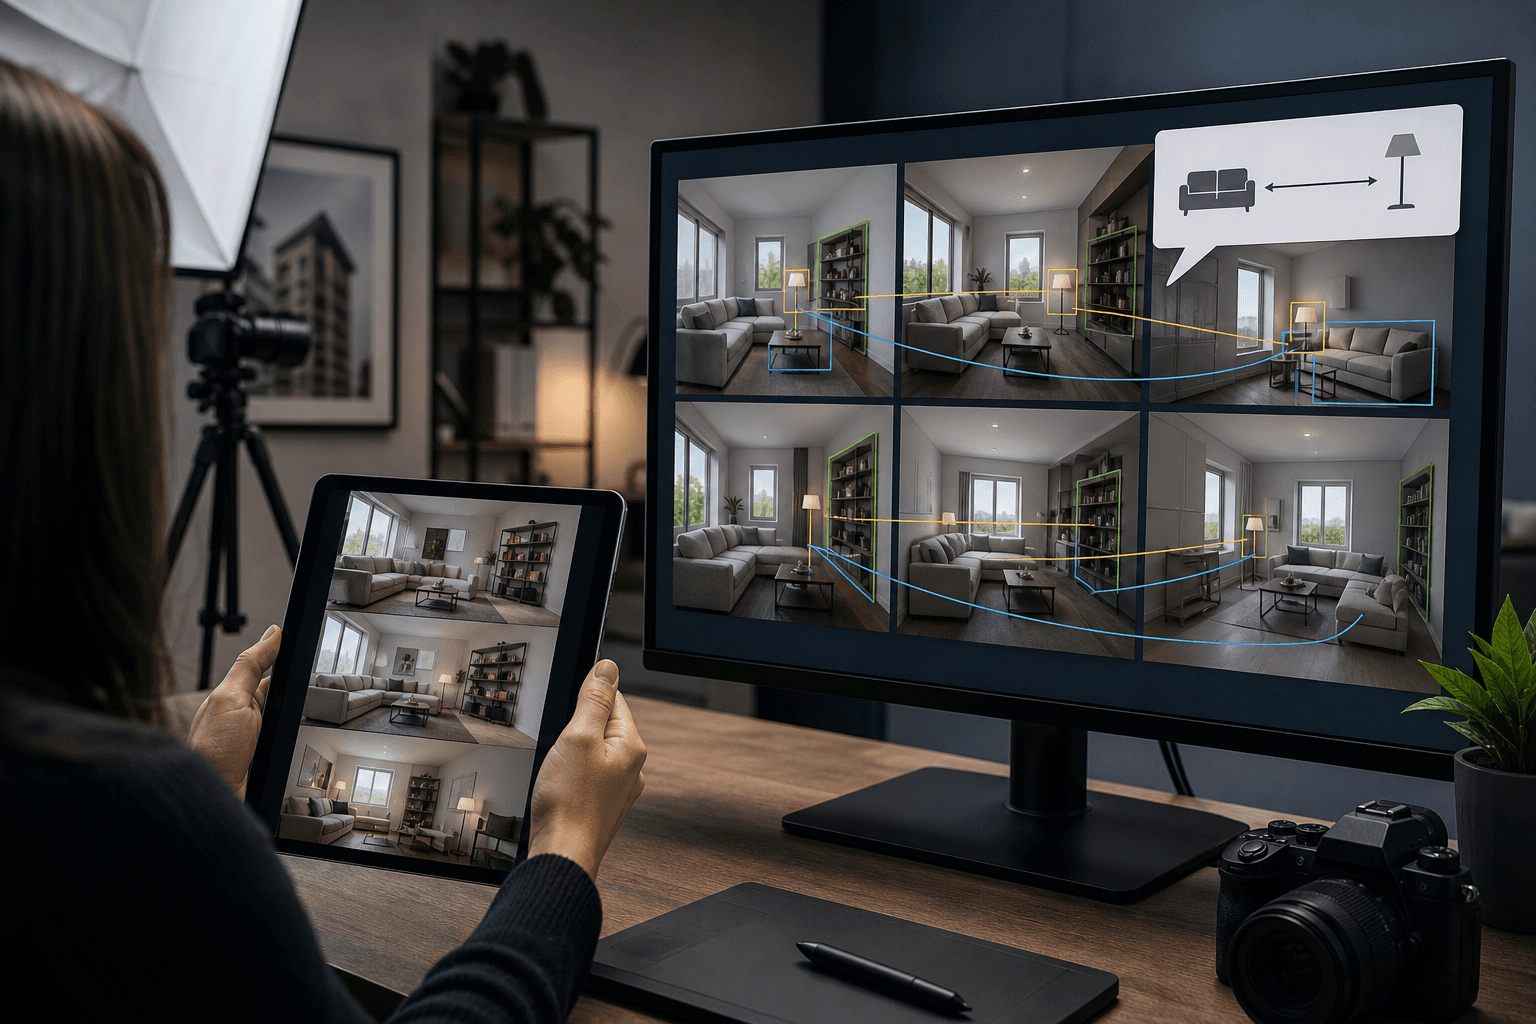
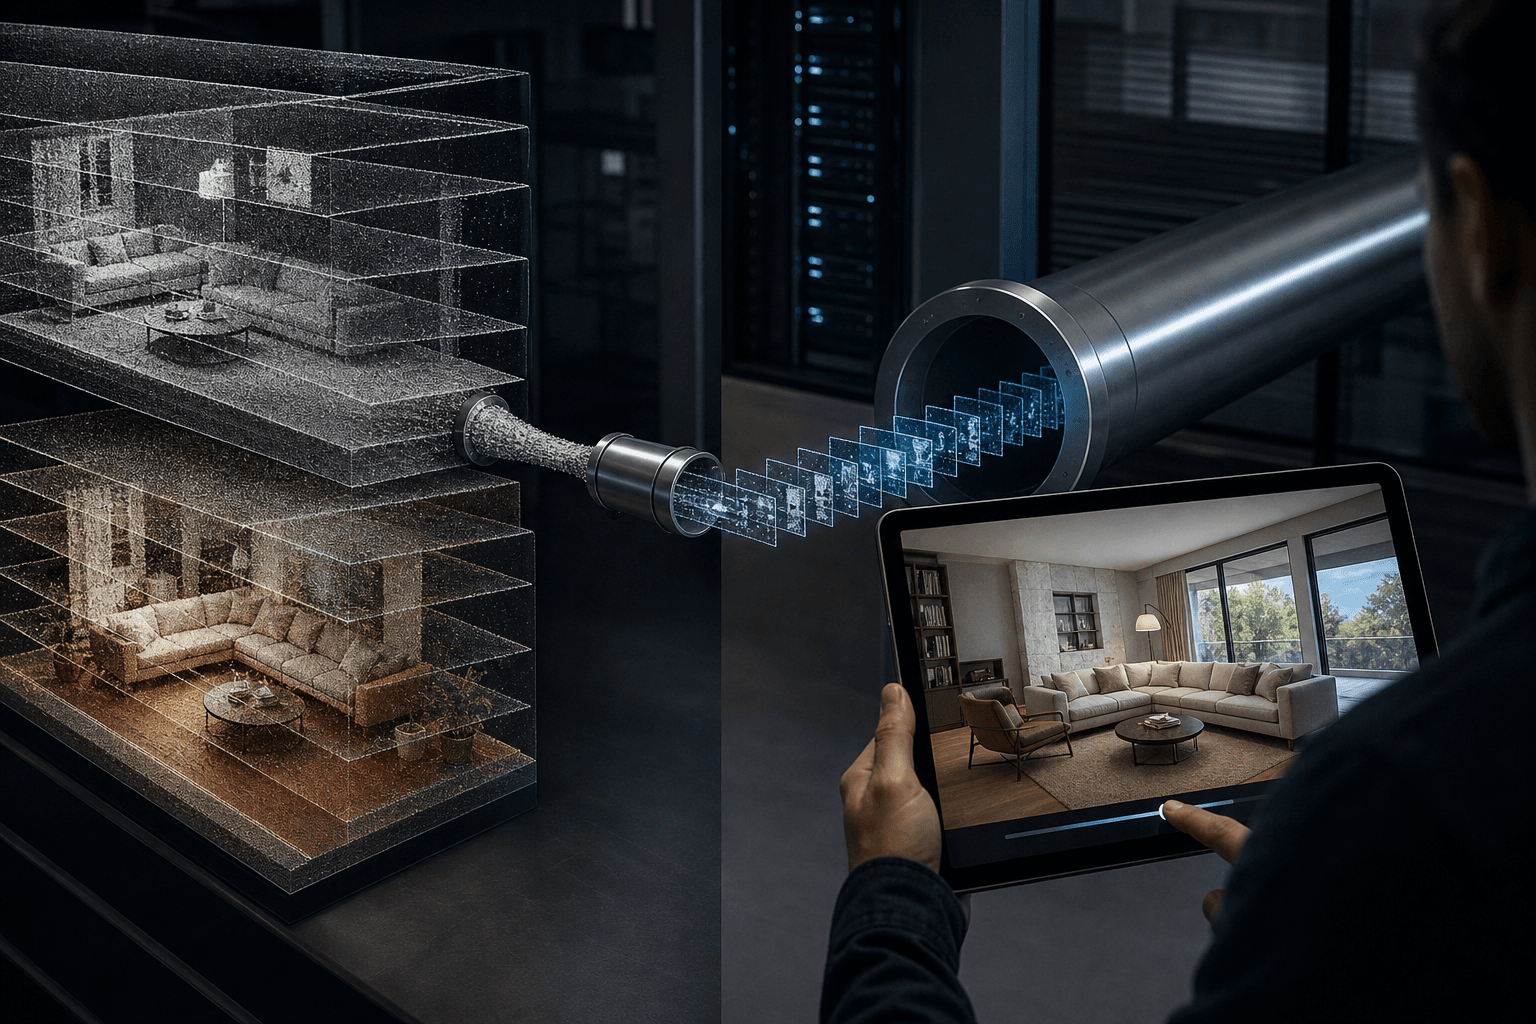
韓国の研究チームは、複数視点の画像特徴を直接圧縮して送る3D再構成手法MFGSを提案した。従来方式比で転送データ量を99%超削減し、処理も約12倍高速化した。3D配信の実用性を左右する成果である。
10本掲載
韓国の研究チームは、複数視点の画像特徴を直接圧縮して送る3D再構成手法MFGSを提案した。従来方式比で転送データ量を99%超削減し、処理も約12倍高速化した。3D配信の実用性を左右する成果である。
GeoThinker-Fは、空間理解AIが外部の3D解析器に頼らず、自らの内部情報から形状や次の場面を予測する手法である。推論遅延を1.45秒から0.40秒に縮め、現場実装の壁を下げる。
イリノイ大学の研究チームは、AIエージェントが次の行動列を先読みする力を行動学習と同時に鍛える手法CoPEを発表した。推論時の負荷を増やさず学習効率を高め、業務自動化の開発コスト低減につながる。
静止3Dと動的4Dの空間理解を一つのAIで両立させる枠組み「DynThinker」が登場した。一方を鍛えると他方が劣化する干渉を抑えており、映像解析や現場の安全管理への応用が見込まれる。
アリババ系の研究チームが、EC商品の主画像を自動生成する基盤CommerceGen-Studioを開発した。商標や文字の正確さを保ち、日産数百万枚を数秒で出力する本番運用を実現しており、制作コストと掲載スピードの再設計を迫る。
映像の動きを骨格、残った誤差を残差として行動を表現する手法VITALが登場した。1段階の推論でも高い走行性能を保ち、速度は3.29倍になる。実時間制御の現場に効く成果である。
移動しながら物をつかむロボットを、人の介入を学習の2割未満に抑え、約30分の実機学習で改善する枠組みHiRe-MoMaが登場した。現場調整の工数削減につながる。
画像生成の拡散モデルで、事前学習済みの視覚エンコーダーの意味情報を後段の層へ直接渡す手法RECONが登場した。追加パラメータなしで、SiT比63倍、REPA比25倍の収束高速化を示し、学習コストの圧縮につながる。
米カリフォルニア大バークレー校の研究チームが、人型ロボットの制御ネットワークを重みの空間で直接生成する手法を示した。実機で歩行や踊りが動作し、制御ソフトの量産や調達の考え方を変える可能性がある。
韓国の研究チームは、3D空間への質問応答を同時に学習させると新視点画像の品質と幾何的整合性が高まることを示した。少数の写真から現場を再現する業務の精度向上につながる成果である。