VITALが映像の動きから精密な運転操作を導く
映像の動きを骨格、残った誤差を残差として行動を表現する手法VITALが登場した。1段階の推論でも高い走行性能を保ち、速度は3.29倍になる。実時間制御の現場に効く成果である。
研究の概要
自動運転の研究では、将来の映像を予測する世界モデルの知見を走行判断につなげる「世界行動モデル」が注目されている。ただし従来は、行動を出力する部分が、映像の動きとは無関係に定義された軌道表現で学習されることが多かった。Ao Liang氏らの研究チームは、行動の目標値そのものを視覚的な動きから導く手法VITAL(Vision-Induced Tokens for Action Learning)を提案した。
予備検証では、記録された将来の画像から軌道を復元する簡易設定を調べた。未来予測を要さなくても、右左折や車線維持といった主要な操作は捉えられる。一方で、センチメートル規模の誤差が残ることも分かった。VITALはこの知見に基づき、映像由来の大まかな動きの「骨格」と、骨格で説明しきれない誤差を表す小さな「残差」を組み合わせて行動を符号化する。
評価では、自動運転の標準ベンチマークNAVSIM v1 navtestで、ノイズ除去を1段階に絞った設定でも90.8 PDMSを記録した。10段階の場合との差は0.13点以内で、エンドツーエンドの推論速度は3.29倍である。再学習なしでNAVSIM v2 navtestでは91.1 EPDMS、より難しいnavhardでは38.6を得ている。
しくみをやさしく
地図アプリの経路案内に例えると分かりやすい。まず「次の交差点を右折して直進」という大まかな経路(骨格)を決め、次に「車線の中央から少し左に寄せる」といった微調整(残差)を別に決める。VITALは前者を映像の動きから、後者を別の正規化した尺度で学習する。大きな値と小さな値を同じ物差しで扱うと、小さな補正が学習の中で埋もれてしまうためである。
生成にはフローマッチングを用いる。ノイズから目的の値へ少しずつ変換していく生成手法で、通常は何段階も繰り返す。VITALは現在の画像、自車の状態、ナビゲーション指示から骨格と残差を同時に予測し、推論時には将来の画像を生成しない。骨格が精度の高い出発点を与えるため、少ない段階でも結果が崩れにくいと解釈できる。
さらに、骨格を固定したまま残差の座標だけを範囲内で動かす強化学習(事後訓練)により、実行の精度を磨く。調整できる幅に上限があるため、大きく逸脱しにくい点が特徴である。
ビジネスへの示唆
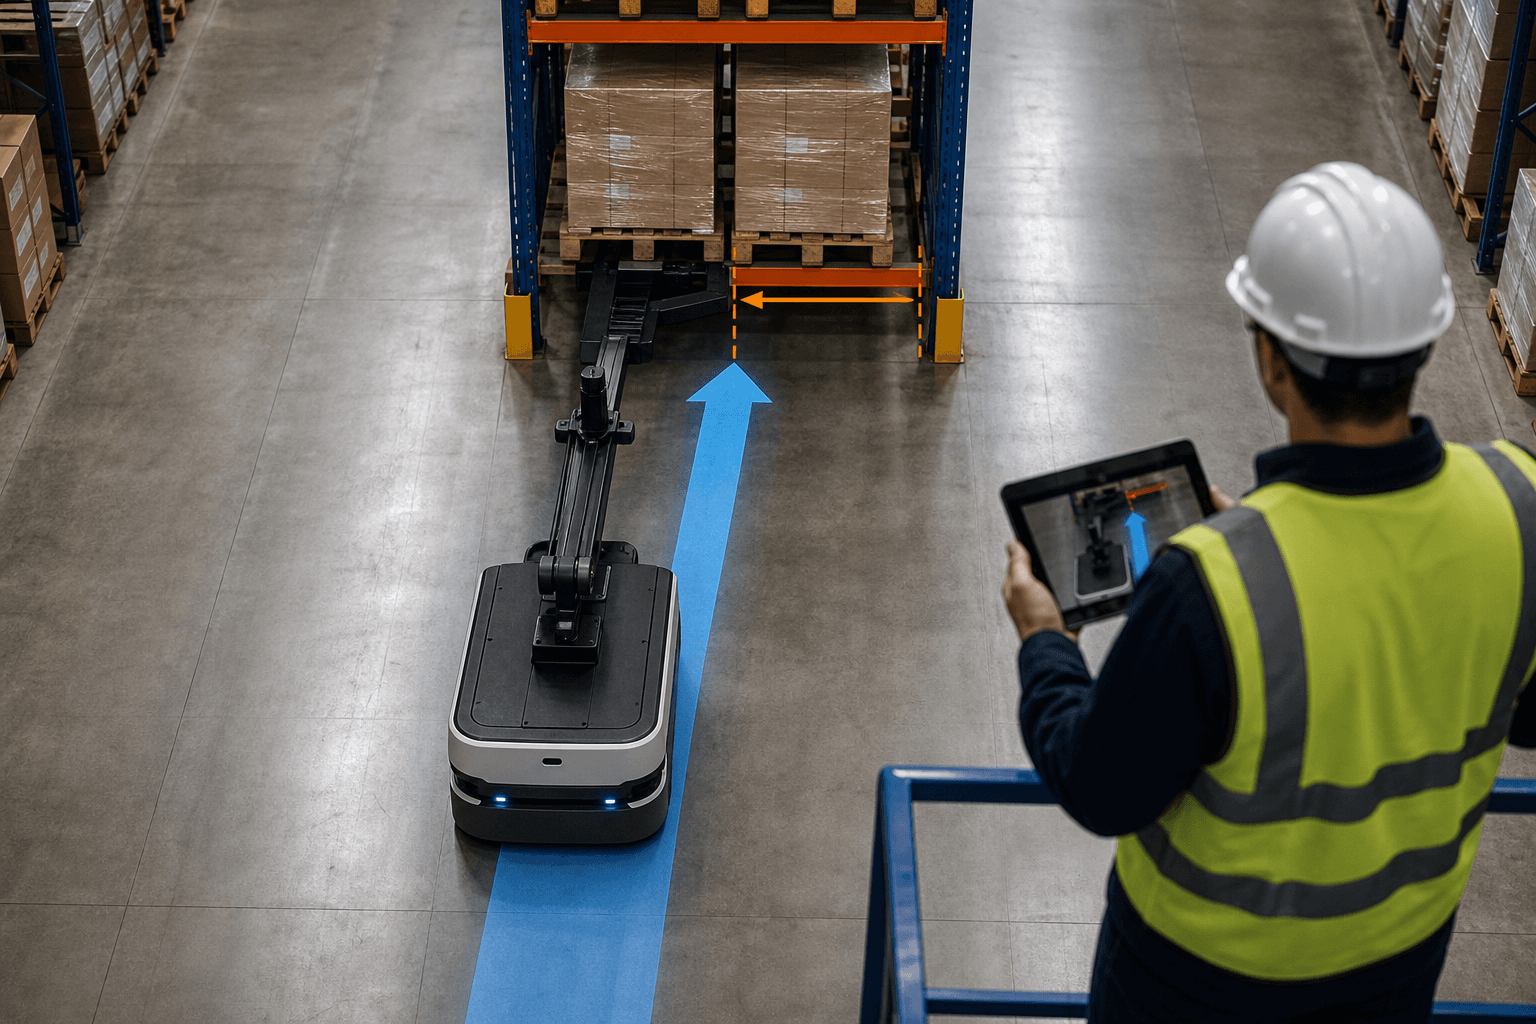
中心となる発想は「大枠は合っているが、最後の数センチがずれる」問題への対処である。この種の業務は自動車に限らない。例えば物流センターの自律搬送ロボットは、経路は正しくても棚前での位置ずれで停止や再試行を起こすことがある。建設機械や農機の自動化でも、作業位置の微差が品質に直結する。
ここで読者に問いたいのは、自部署で「大枠は自動化できたが、最後の精度を人が補っている工程」は何か、そこにいま誰がどれだけ手をかけているか、である。影響が想定される部門とKPIは次のとおりである。
- 自動運転・ロボット開発部門:推論遅延、車載計算機の負荷、人の介入頻度
- 物流・生産技術部門:停止や再試行の回数、位置決めの手戻り
- 安全評価・品質保証部門:検証サイクルの所要時間、逸脱時の挙動の説明しやすさ
推論が軽くなれば、高価な計算機に頼らずに済む可能性があり、機器コストの面でも利点となり得る。ただし結果はシミュレーション系のベンチマークでの評価であり、実車や実機での性能は別途検証を要する。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
- 棚卸し:自動化済みの工程のうち、人が最後に補正している箇所、再試行が多い箇所を一覧にする。到達点は、「大枠は良いが精度で詰まる業務」を共通の言葉で可視化することである。
- 差し込み先の設計:新しい制御系を増やさず、既存の行動予測モジュールの出力表現を「骨格+残差」に置き換える形を優先する。到達点は、既存の知覚や走行計画を残したまま、行動生成部だけを差し替えられる構成である。
- 小さく試す(PoC):一つの拠点、一つの工程に限り、数週間で現場担当者の実感を確かめる。到達点は、再試行の減り方や応答の速さが担当者の体感として確認され、継続可否を判断できる状態である。
- 運用と横展開:残差の調整幅や逸脱時の停止条件を基準として文書化し、他の拠点や機種へ広げる。到達点は、安全基準と性能指標が部署を越えて共有される状態である。
目指す姿は、人の手による最後の補正を減らし、軽い推論で安定して動く自動化を、小さく安く始めて広げていくことである。
今後の展望
本研究は、視覚的な動きを予測の主役に据え、小さな補正を別に扱うという設計の有効性を示した。今後は実車での検証や、倉庫、工場といった他領域への適用が焦点となる。速度と精度の両立が実証されれば、自動化の費用対効果を見直す契機になるであろう。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
空間理解AI、外部3D機能なしで3.6倍高速化
GeoThinker-Fは、空間理解AIが外部の3D解析器に頼らず、自らの内部情報から形状や次の場面を予測する手法である。推論遅延を1.45秒から0.40秒に縮め、現場実装の壁を下げる。
人の助言わずかで移動ロボ、30分で現場適応
移動しながら物をつかむロボットを、人の介入を学習の2割未満に抑え、約30分の実機学習で改善する枠組みHiRe-MoMaが登場した。現場調整の工数削減につながる。
人型ロボの制御網を拡散モデルで生成
米カリフォルニア大バークレー校の研究チームが、人型ロボットの制御ネットワークを重みの空間で直接生成する手法を示した。実機で歩行や踊りが動作し、制御ソフトの量産や調達の考え方を変える可能性がある。