画像生成AIの学習、既存部品で大幅短縮
画像生成の拡散モデルで、事前学習済みの視覚エンコーダーの意味情報を後段の層へ直接渡す手法RECONが登場した。追加パラメータなしで、SiT比63倍、REPA比25倍の収束高速化を示し、学習コストの圧縮につながる。
研究の概要
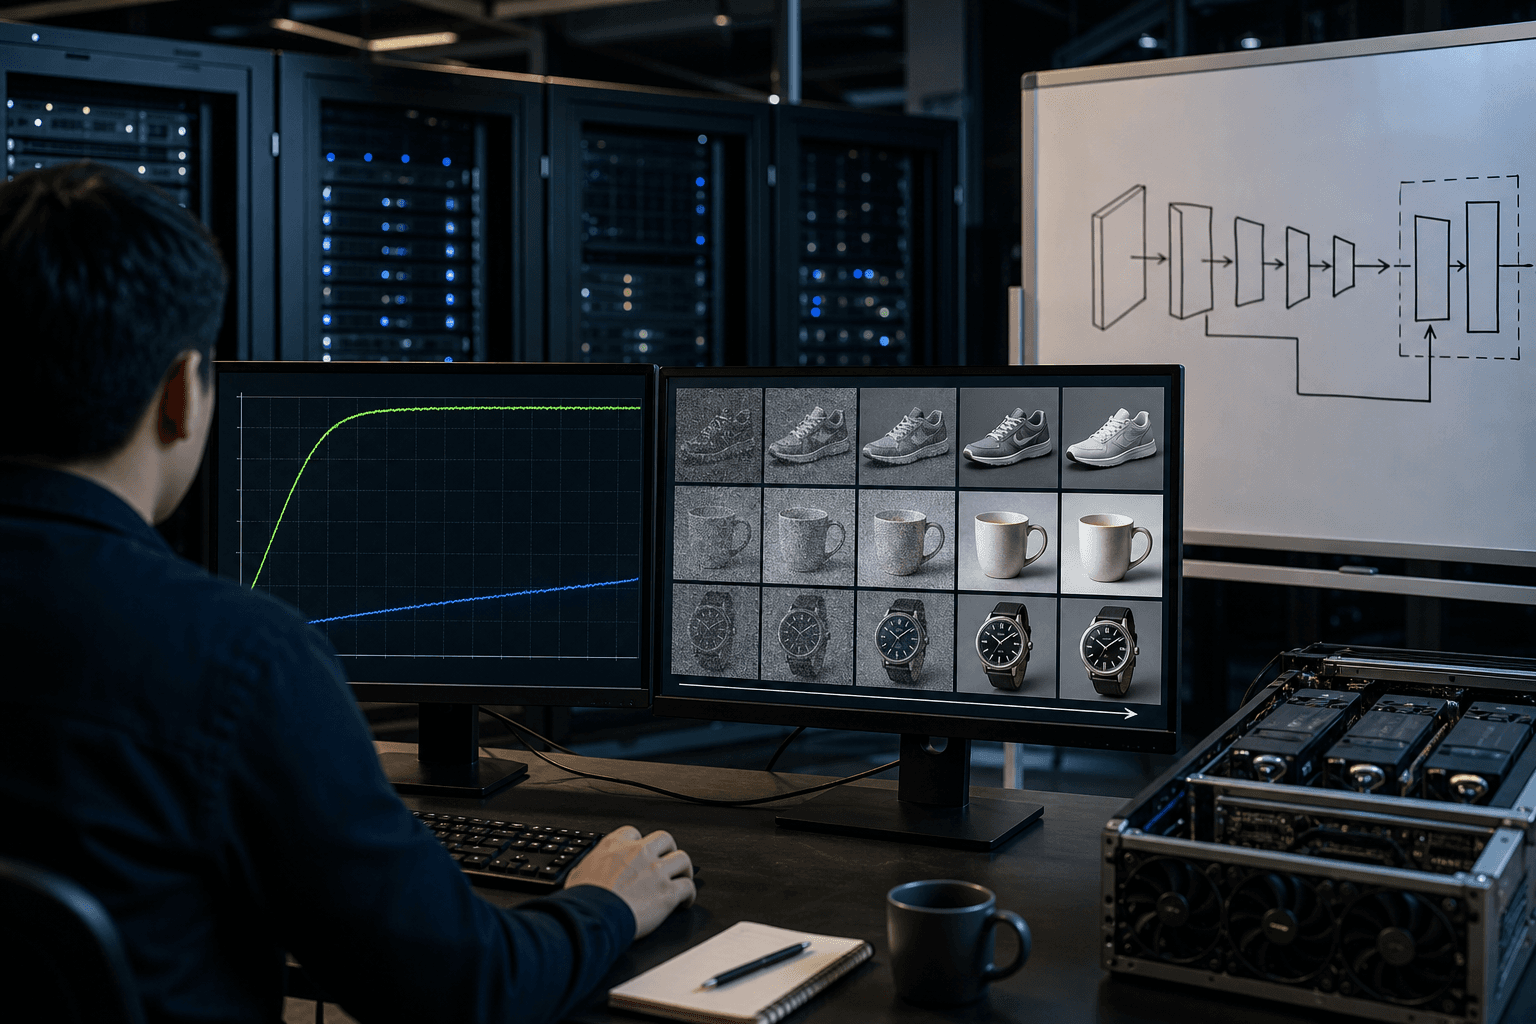
Saeed Razavi氏らの研究チームは、画像生成AIの学習を速める新手法RECON(Representation Conditioning)を発表した。対象は、近年の画像生成の主流である拡散Transformerである。論文によれば、RECONは同種の基本モデルSiTより63倍、既存の高速化手法REPAより25倍速く収束する。しかも追加のパラメータを必要としない。
背景には、REPAに代表される表現整合(representation alignment)手法がある。REPAは、画像認識で十分に学習済みの視覚エンコーダーを「教師」とする。拡散モデルの中間層の出力を、小さなMLP(多層パーセプトロン)の射影ヘッドを介して教師の出力に近づける。これにより、物体の意味や構造といった情報が拡散モデルへ移され、学習が加速する。射影ヘッドは学習後に捨てられる。
研究チームは、この方式に弱点があると指摘する。整合の損失が逆伝播で直接効くのは初期の層だけである。後段の層は、ノイズ除去の方向を予測する速度予測損失のみで訓練される。そのため、後段の層が移された意味情報を十分に使える保証はない。
しくみをやさしく
RECONの発想は、教師の出力を「採点基準」として使うだけでなく、後段の層への「入力」としても使う、というものである。
学習時には、元のきれいな画像が手元にある。そこで、事前学習済みの視覚エンコーダーが出力するトークン(画像を小片に分けた特徴量)を、後段の層に条件として直接与える。後段の層は、意味情報を手がかりにノイズ除去を学べる。
問題は推論時である。画像を生成する段階では、きれいな元画像は存在せず、視覚エンコーダーに通せない。そこで研究チームは、学習で使い続けたMLPヘッドを代役(プロキシ)に据えた。中間層の出力をこのヘッドに通し、教師のトークンに近い予測を作る。それを後段の層へ渡すのである。ヘッドはREPAでは捨てていた部品であり、新たなモジュールは増えない。
料理にたとえると、完成写真を見て味を整える職人に、完成品の味の記憶を調理の後半でも参照させる仕組みである。本番では完成品がないため、前半の工程で得た見立てを代わりに使う。
ビジネスへの示唆
画像生成モデルを自社で育てる、あるいは自社データで追加学習させる企業にとって、学習時間は最大のコスト項目である。論文の主張どおりなら、同じ品質に達するまでの計算資源と待ち時間を、大きく減らせる可能性がある。
具体的に恩恵が見込まれるのは次の部門である。
- EC・小売のクリエイティブ部門:商品画像や背景差し替えの生成。モデル更新の頻度と制作リードタイム
- 製造業の設計・品質保証部門:外観検査用の疑似不良品画像の合成。データ拡張にかかる準備期間
- 広告・マーケティング部門:ブランド固有の画風を学ばせた生成モデルの調整。試作と修正の回数
- 研究開発・AI基盤部門:GPU利用時間とクラウド費用、実験サイクルの速さ
読者が自らに問うべきは、自社で「画像を作る、または作らせる」業務がどこにあるか、である。そのモデルは誰が、どれだけの待ち時間とGPU費用をかけて学習させているのか。試作のたびに数日待つ現場なら、収束の速さは動く指標に直結する。
なお、論文が示すのは学習の収束速度であり、自社業務での費用削減額を保証するものではない。効果の大きさは、データやモデル規模によって変わる点に留意が必要である。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
- 棚卸し:画像生成を使う業務と、モデルの学習・調整にかかる時間と費用を洗い出す。学習待ちが制作や検査の進行を止めている箇所を可視化する。到達点は、「どの業務で学習時間が足かせか」を担当者が説明できる状態である。
- 差し込み先の設計:新しい生成基盤を導入せず、現在使っているREPA系やSiT系の学習コードに、RECONを差し込む方針を優先する。公開コードがあり、追加パラメータも不要なため、改修は小さく収まる見込みである。到達点は、既存の学習パイプラインを大きく変えずに試せる設計である。
- 小さく試す(PoC):一つの部署、数週間の範囲で、現行手法とRECONを同じ条件で比べる。指標は、一定品質に達するまでの時間と、担当者が見て実用に耐えるかという実感である。到達点は、自社データで効果の有無を判断できる状態である。
- 運用と横展開:採用の基準、たとえば品質の確認方法や再学習の頻度を文書化する。そのうえで、他部署の生成モデルへ広げる。到達点は、モデル更新が「重い作業」から「日常的な改善」に変わることである。
全体として目指すのは、画像生成モデルの改良を、小さく・安く繰り返せる体制である。
今後の展望
本手法は、視覚エンコーダーという既存の資産を、学習の教師から生成時の補助へ広げた点に特徴がある。同様の発想は、動画や3Dなど他の生成領域にも応用される可能性がある。一方、推論時にヘッドの予測が教師の出力とどこまで一致するかは、生成品質を左右する。実運用では、自社の画像領域での検証が欠かせない。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
3D空間の伝送量を大幅削減、特徴量符号化が登場
韓国の研究チームは、複数視点の画像特徴を直接圧縮して送る3D再構成手法MFGSを提案した。従来方式比で転送データ量を99%超削減し、処理も約12倍高速化した。3D配信の実用性を左右する成果である。
AIエージェント、行動と先読みを同時に学習
イリノイ大学の研究チームは、AIエージェントが次の行動列を先読みする力を行動学習と同時に鍛える手法CoPEを発表した。推論時の負荷を増やさず学習効率を高め、業務自動化の開発コスト低減につながる。
DynThinker、静止と動的の空間推論を統合
静止3Dと動的4Dの空間理解を一つのAIで両立させる枠組み「DynThinker」が登場した。一方を鍛えると他方が劣化する干渉を抑えており、映像解析や現場の安全管理への応用が見込まれる。