空間の問いへの学習が新視点生成を高める
韓国の研究チームは、3D空間への質問応答を同時に学習させると新視点画像の品質と幾何的整合性が高まることを示した。少数の写真から現場を再現する業務の精度向上につながる成果である。
研究の概要
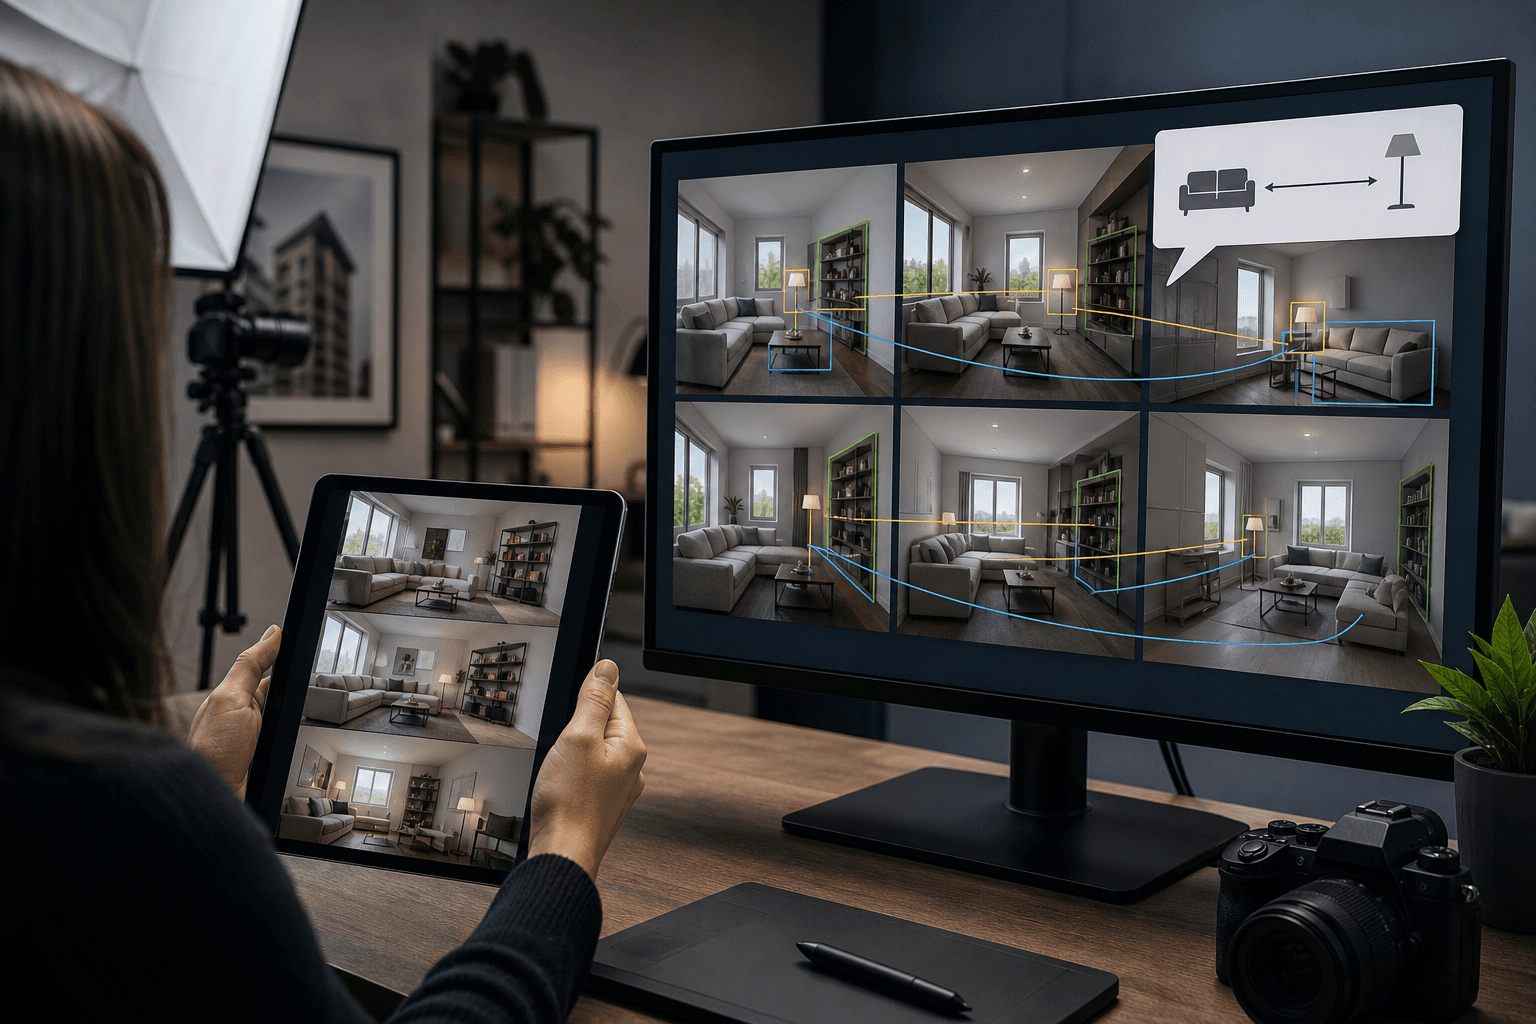
少数の写真から、別の角度から見た画像を生成する「新視点生成」は、物体の見た目と空間の構造を同時に保つ必要がある。従来の手法は奥行きやカメラの位置関係といった細かな幾何情報を活用してきたが、「これは何の物体か」「どんな属性を持つか」「隣の物体とどう並ぶか」といった高次の意味情報と空間関係は、明示的に扱われてこなかった。
韓国の研究チーム(Jahyeok Koo氏、Seungryong Kim氏ら)は、3D言語理解、すなわち空間に関する質問への回答能力が、新視点生成の補助的な教師信号になるかを検証した。その結果を「Ask4NV」として発表している。実験では、画像品質と幾何的整合性で高い性能を示しつつ、3D言語理解でも競争力のある水準を保った。
しくみをやさしく
Ask4NVは、画像の理解と生成の両方を一つで担う事前学習済みの統合マルチモーダルモデルを土台にしている。内部は Mixture-of-Transformers(MoT) という構造で、理解用と生成用の処理系統を分けつつ、必要に応じて情報をやり取りできる。
第一の工夫は、カメラの幾何情報を二種類の画像表現に組み込む点である。一つは画像を圧縮して生成に使うVAE表現、もう一つは画像の意味を捉えるViT表現であり、どちらにも「どの位置・向きから撮ったか」が反映される。
第二の工夫は、生成の最中に理解側の特徴を使う点である。両者を同じ注意機構(joint self-attention)で結び、さらにモダリティを考慮した注意マスクで、どの情報がどの情報を参照してよいかを制御する。たとえるなら、図面を描く担当者が、隣で現場を説明する担当者の言葉を聞きながら描く仕組みである。
分析では、共同学習によって、VAE表現における視点間の対応関係と、3Dを意識した特徴空間での類似性が改善されることが確認された。つまり、空間の問いに答える訓練が、別視点でも同じ物体を同じ物体として扱う力を育てたと解釈できる。
ビジネスへの示唆
恩恵が大きいのは、少数の写真から「見えていない角度」を補う業務である。たとえば不動産・住宅業界の販売部門では、物件の数枚の写真から内覧用の別アングル画像を用意する作業が日常的に発生する。EC・小売のマーケティング部門では、商品の正面写真しかない場合に、斜めや背面のカットを撮影し直す手間がある。建設・製造の保全部門でも、点検時に撮れた限られた画像から、死角の状態を確認したい場面がある。
読者が自らに問うべきは、「自部署で、写真や図面が足りないために撮り直し・再訪問・外注が発生している業務は何か」「それにいま誰がどれだけ手をかけているか」である。
動くKPIとしては、次のものが考えられる。
- 撮影・再撮影にかかる工数とコスト(EC、不動産)
- 現場再訪問の回数(保全、点検)
- 掲載までのリードタイム(マーケティング)
- 生成画像の修正・差し戻し率(制作部門)
特に、物体の同一性や配置関係が崩れにくいことは、「生成画像が実物と違う」という品質上の問題を減らせる可能性がある。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
- 棚卸し:撮り直し、再訪問、外注が発生している業務を洗い出し、手間と待ち時間を可視化する。目指す到達点は、「どの業務で別視点画像が足りないのか」を部署全員が共通認識として持つことである。
- 差し込み先の設計:新しいツールを増やさず、既存の画像管理システムや商品情報登録の流れ、現場報告のワークフローに、視点補完の工程を一つ加える形で設計する。目指す到達点は、担当者がいつもの画面から追加の操作なしに補完画像を受け取れる状態である。
- 小さく試す(PoC):一部署・数週間に限り、実際の写真で補完画像を作り、担当者が「実物と矛盾しないか」を目視で確かめる。目指す到達点は、数値ではなく現場の実感として、使える場面と使えない場面の線引きが言語化されることである。
- 運用と横展開:実物との整合を確認するチェック基準と、生成画像である旨の表示ルールを整え、他部署へ広げる。目指す到達点は、品質基準が属人化せず、部署をまたいで再現できる状態である。
全体として目指すのは、撮影や再訪問への依存を減らしつつ、実物との整合が担保された画像を、小さく安く手元で用意できる業務体制である。
今後の展望
本研究は、「理解」と「生成」を別々の技術と見なさず、理解を生成の教師として使う方向の有効性を示した。今後は、ロボットや自動運転のシミュレーション、AR・VRの空間コンテンツ制作など、空間の意味と見た目の両方が要る領域への応用が見込まれる。
一方で、生成画像は実在しない情報を含みうる。点検や契約に関わる用途では、人による確認を前提にする必要がある。論文は技術検証の段階であり、実業務での効果は、各社の画像条件での検証を要する。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
3D空間の伝送量を大幅削減、特徴量符号化が登場
韓国の研究チームは、複数視点の画像特徴を直接圧縮して送る3D再構成手法MFGSを提案した。従来方式比で転送データ量を99%超削減し、処理も約12倍高速化した。3D配信の実用性を左右する成果である。
AIエージェント、行動と先読みを同時に学習
イリノイ大学の研究チームは、AIエージェントが次の行動列を先読みする力を行動学習と同時に鍛える手法CoPEを発表した。推論時の負荷を増やさず学習効率を高め、業務自動化の開発コスト低減につながる。
DynThinker、静止と動的の空間推論を統合
静止3Dと動的4Dの空間理解を一つのAIで両立させる枠組み「DynThinker」が登場した。一方を鍛えると他方が劣化する干渉を抑えており、映像解析や現場の安全管理への応用が見込まれる。