AI×製造
人間視点映像でロボット学習、効く条件を解明
中国の研究チームが、人間の一人称視点データがロボット学習に効く条件を検証した。データ量より動作の整合性や多様性が重要と判明し、ロボット導入費用の抑制につながる。
10本掲載
中国の研究チームが、人間の一人称視点データがロボット学習に効く条件を検証した。データ量より動作の整合性や多様性が重要と判明し、ロボット導入費用の抑制につながる。
実験設計なしで既存データから入力変数の影響度を推定する手法MM-GSAが提案された。二つの指標で変数の重要性を捉え、実務の要因分析や変数選択の精度向上に資する可能性がある。
画像用ViTを転用し、ラベルなし動画から特徴を学ぶ手法VideoMSNが登場した。事前学習の回数を最大160分の1に抑えつつ主要ベンチマークで最高性能を達成し、動画AIの開発コストを下げる可能性がある。
汎用AIエージェントに視覚操作で3D部品を組み立てさせる評価環境が公開された。最良系統でも部品単位の正答率は80.9%、完成品の成功率は59.4%にとどまり、製造現場への適用には精度面の課題が残る。
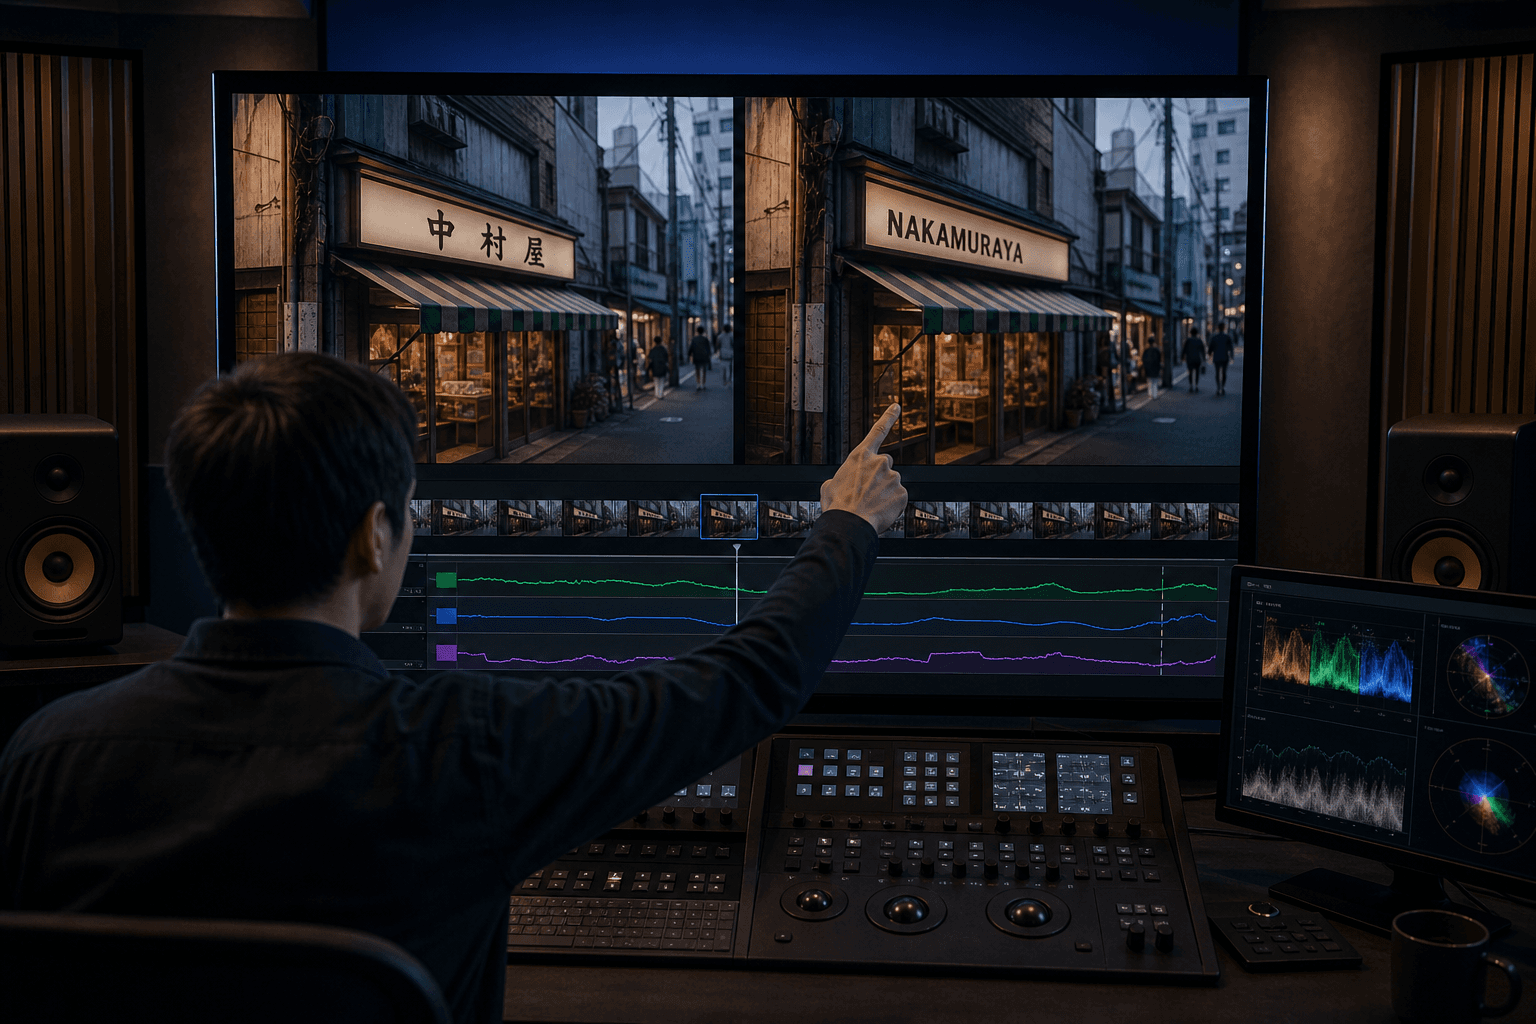
動画内の看板やラベルの文字を、背景の動きを保ったまま差し替える技術の評価基準「ViTeX-Bench」が公開された。広告やEC、多言語展開の制作工程を変え得る基盤として注目される。
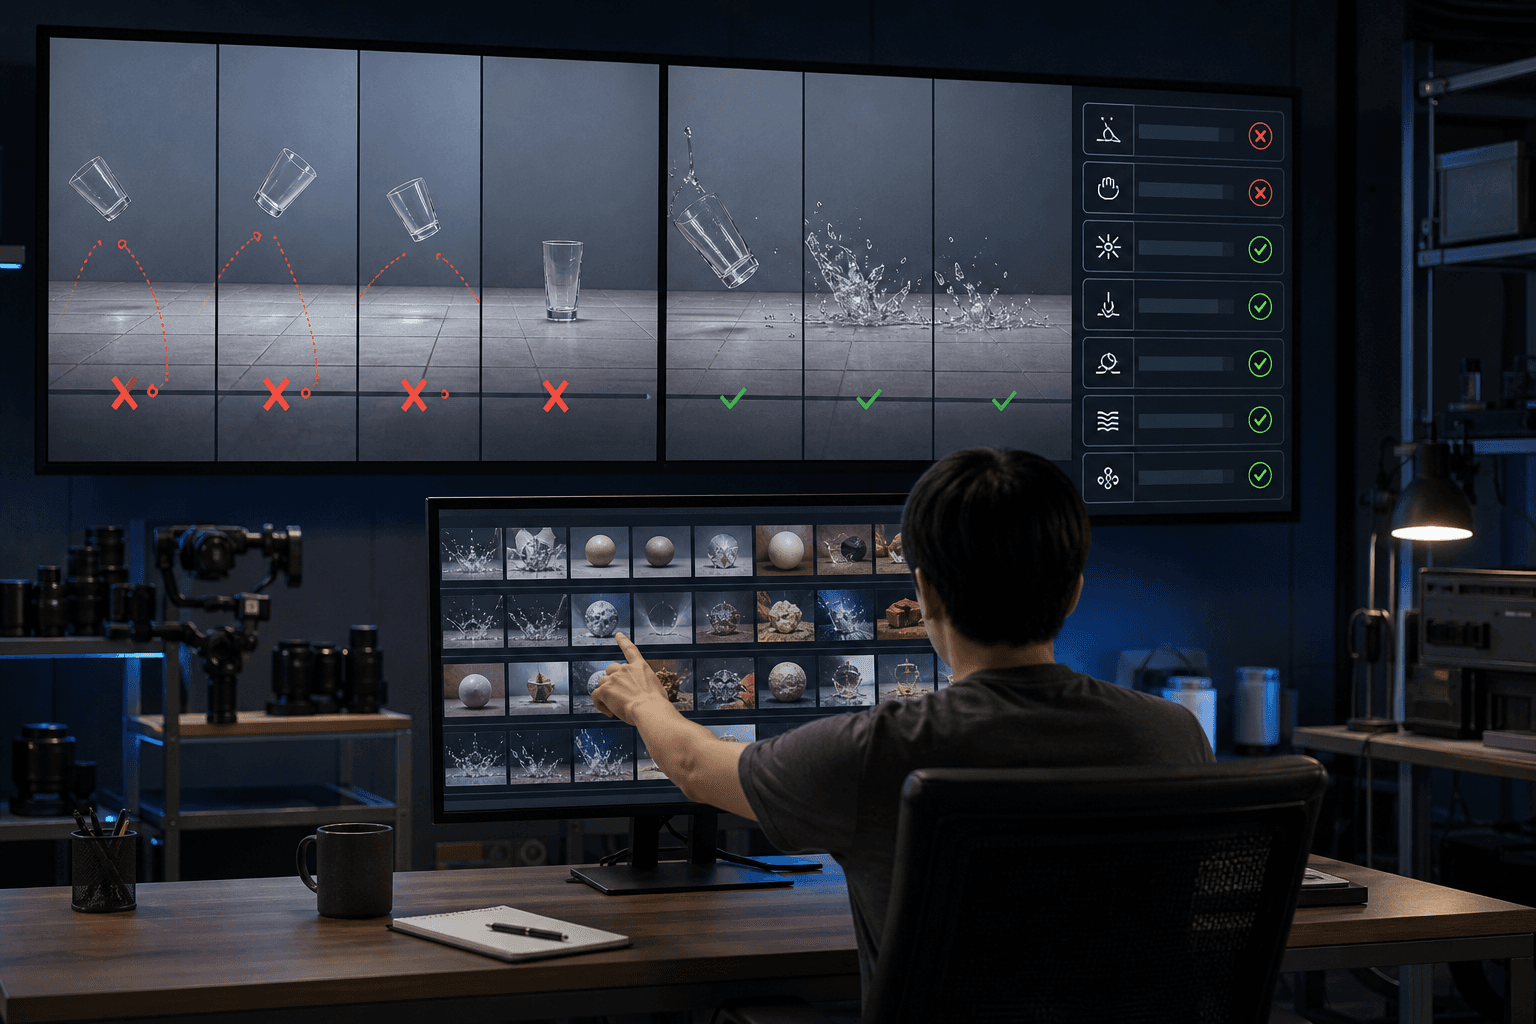
動画生成AIの物理的な不整合を、物理現象を記述する言語表現の自己改善で抑える枠組みPhysis-Langが提案された。オープンモデルが商用最上位のVeo 3.1を上回り、製造やロボティクスの合成データ活用に影響する。
非侵襲の脳波などから単語を復元する有力手法の精度向上は、脳データなしでもほぼ再現できることが判明した。研究チームは近道を除く簡素な改良で、単語誤り率36.6%を達成した。
中国の研究チームが、問題の本質と無関係な表現変化に弱いAIの癖を抑える強化学習手法SCAPOを提案した。小型モデルでも数学推論の精度が向上し、業務AIの安定運用に道を開く。
医療向けマルチモーダルAIのプロンプト改善で、正解率ではなくAUROCを最適化する手法Ranking-PEが提案された。不均衡な臨床データで診断の順位付け精度を最大16.2ポイント高めた。
華中科技大学などの研究チームが、言語と画像を連続的な埋め込み空間で一体的に扱う生成モデル「Multimodal Flow」を発表した。1500億トークンの学習で競合に迫り、基盤モデル開発費の抑制につながる可能性がある。