AI×経営戦略
操作信号で動画生成を高速化、新手法
対話型の動画世界モデルで、ユーザー操作の変化に応じ計算を使い分ける手法CtrlCacheが提案された。再学習なしでDiT部の処理を1.21〜1.41倍に高速化し、品質評価も上回った。
10本掲載
対話型の動画世界モデルで、ユーザー操作の変化に応じ計算を使い分ける手法CtrlCacheが提案された。再学習なしでDiT部の処理を1.21〜1.41倍に高速化し、品質評価も上回った。
学習者の成績向上を報酬に強化学習で訓練したAI講師「Sherpa」が、生徒タイプ別の指導を使い分け、全タイプで平均20.5ポイントの成績向上を示した。AI研修の個別最適化に道を開く成果である。
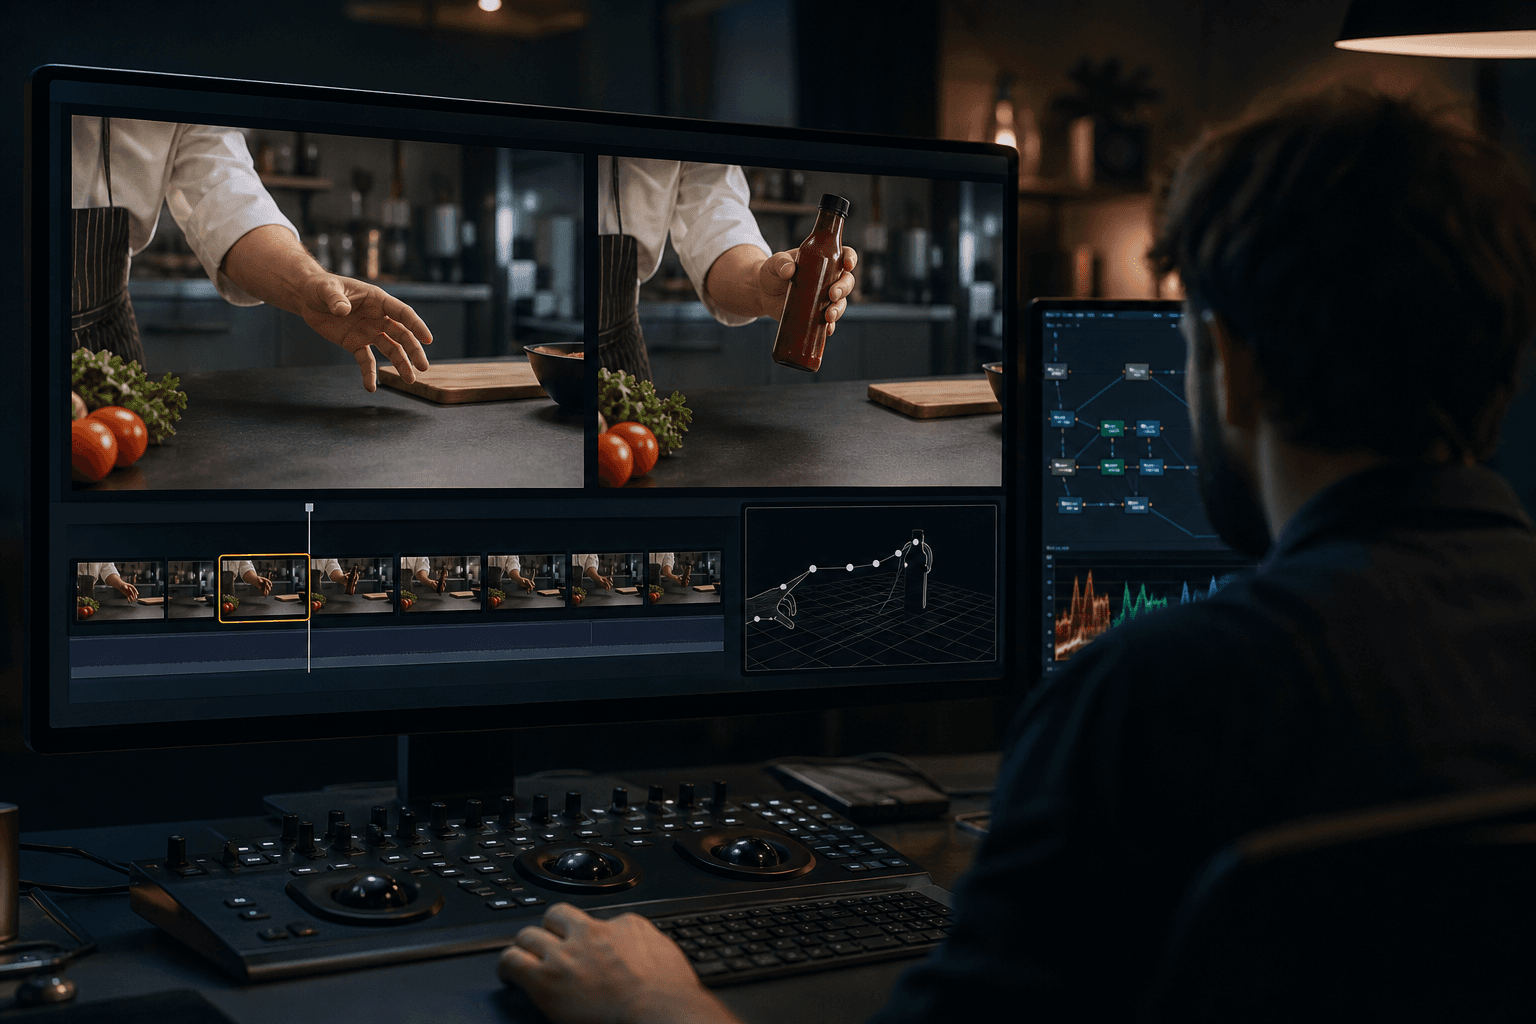
動画に後から加えた物体が、持ち上げられるなど元映像の動作と噛み合うよう編集するAI「ALIVE」が登場した。撮り直しに頼ってきた広告・研修動画の制作工程を変える可能性がある。
ロボット操作の予測映像に奥行き情報を加えた世界モデル「DepthWorld」が発表された。奥行きの学習が映像予測自体も改善し、実機を使わない動作評価の信頼性を高める可能性がある。
複数の先行論文を統合して新しい研究アイデアを出すLLMの訓練法「IdeaAnchor」が登場した。各論文の役割と合成基準を設計図として学習に使う。R&Dや企画の起案業務を変え得る手法である。
4D-HOFは、基盤モデルの粗い推定を生成モデルで補正し、手と物体の相互作用を単一パスで復元する。物理制約も組み込み、個別最適化を不要にする点が注目される。
コンフォーマル予測の「予測集合の縮み幅」が、情報理論上の情報量として理論的に裏付けられた。特徴量選定やデータ投資の判断基準を、保証付きで見直す契機となる。
米国の研究チームが、フローポリシーを高速に強化学習するQF3を開発した。人型ロボットの歩行を白紙から学習し実機へ直接移植でき、学習時間は従来手法の約10分の1になった。
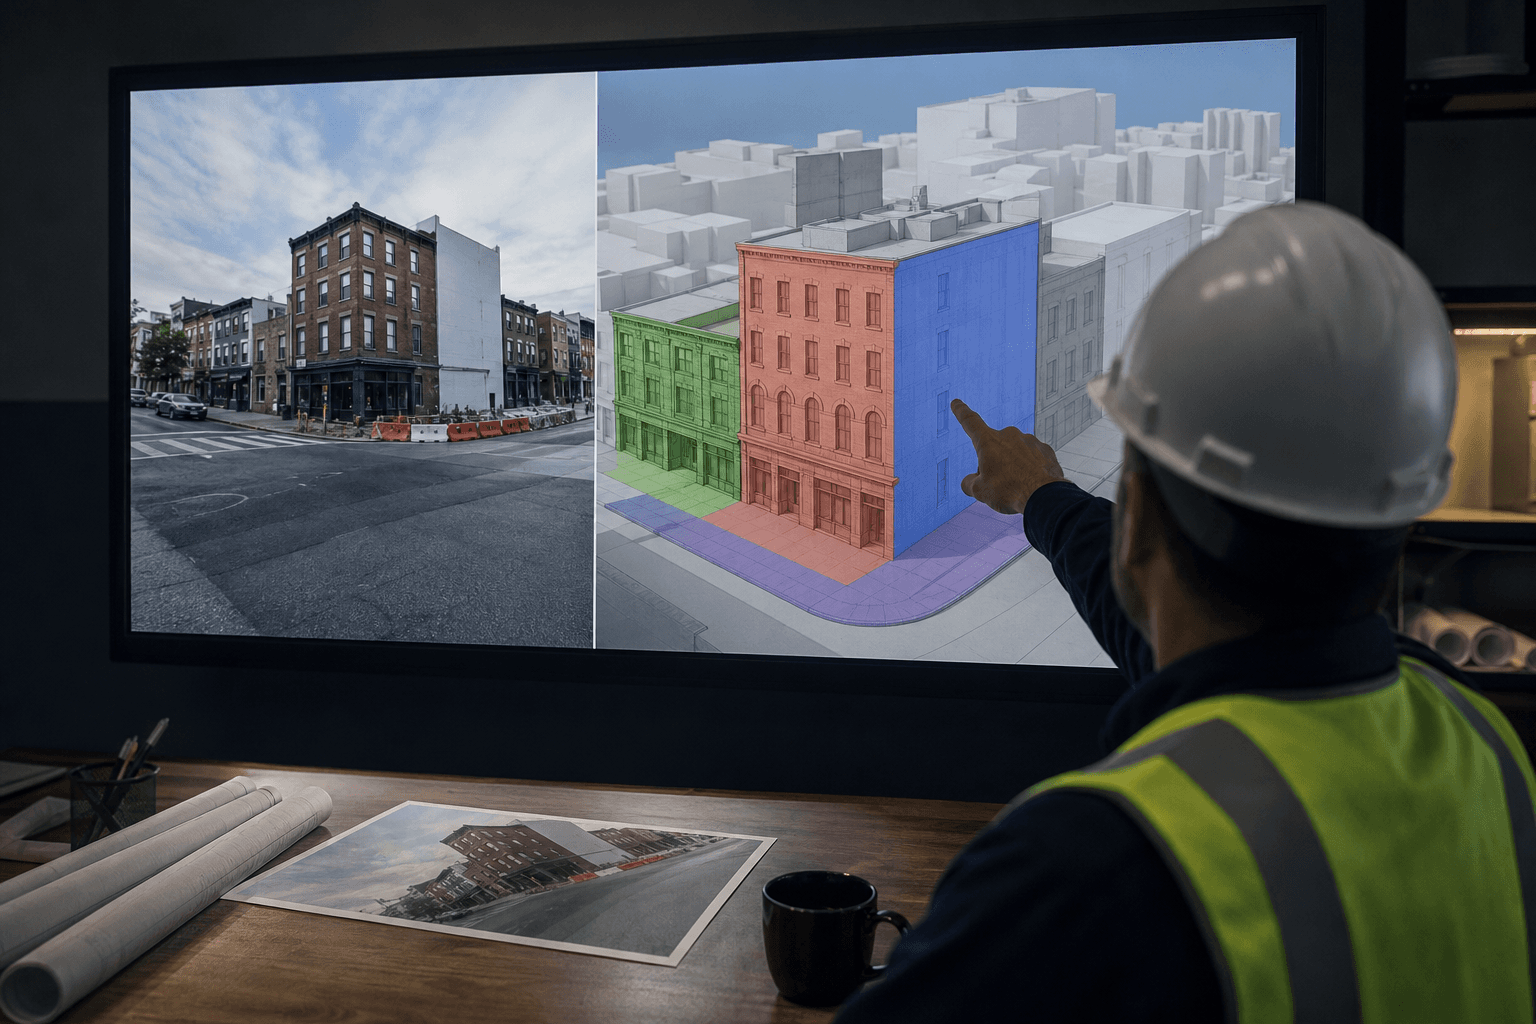
米国などの研究チームが、1枚の画像から未撮影の裏側まで含む3Dシーンを屋内外とも生成する手法を発表した。現場写真を3D資産へ変える初期コストを下げ、建設や不動産、小売の業務を変える可能性がある。
動画生成AIの物理的な正しさを、光学や流体など40課題で定量測定するベンチマークが提案された。最高モデルでも100点中57.76点にとどまり、実務利用前の検証の必要性が浮かんだ。