AI×製造
疎な動きから全体の動きを復元する新手法
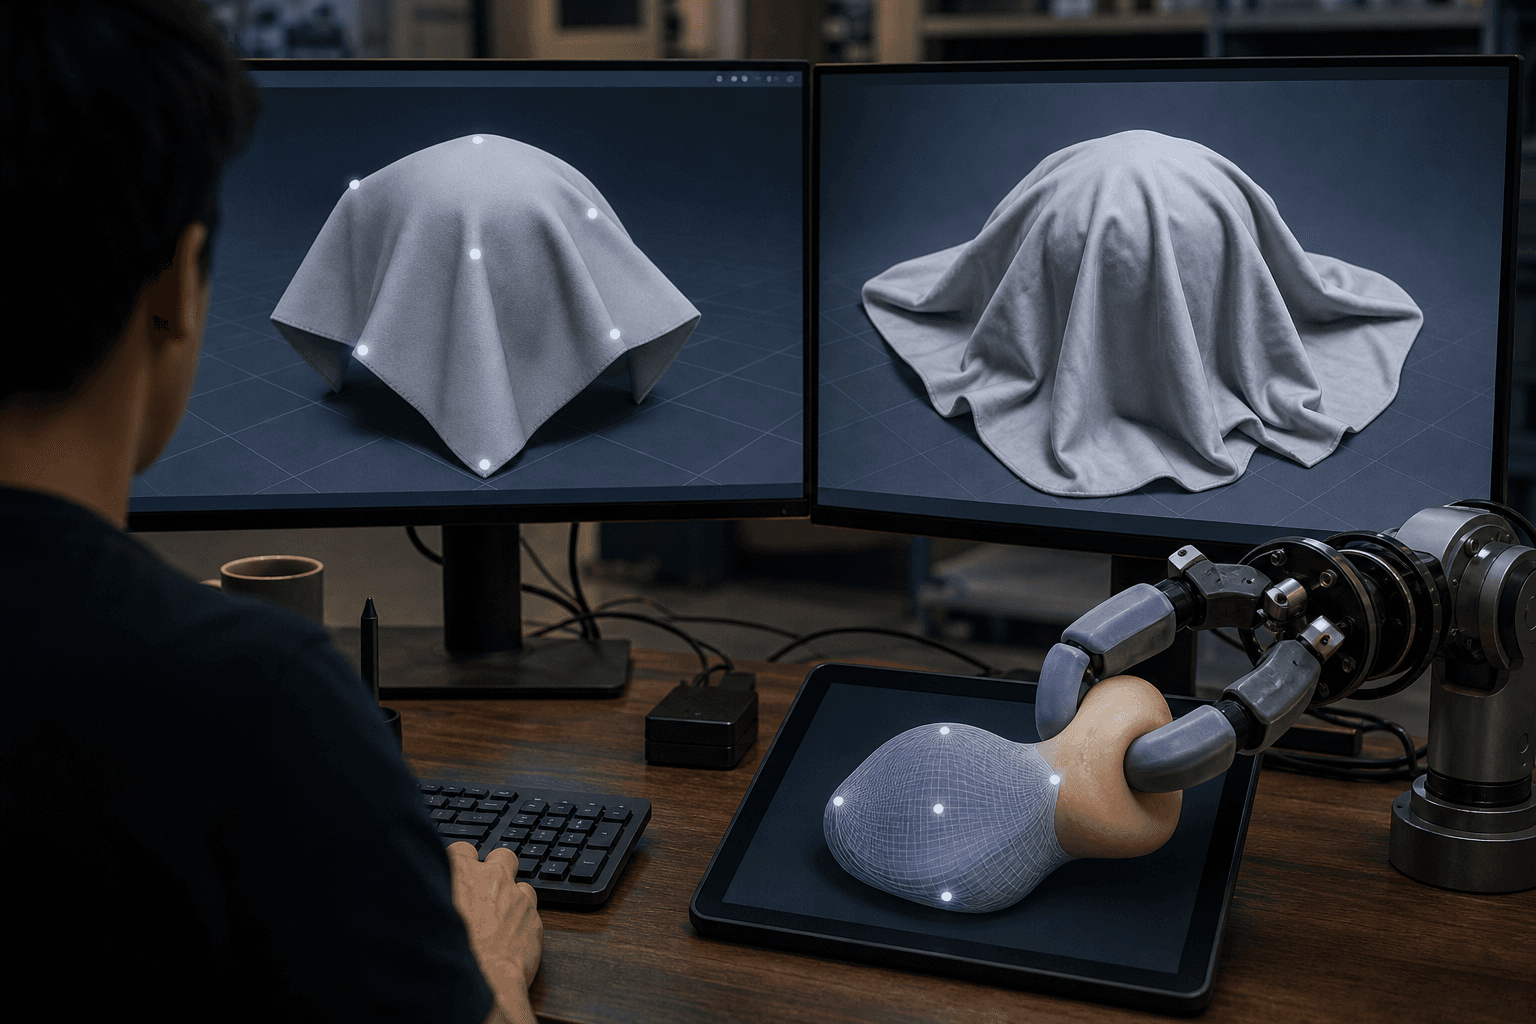
疎な頂点の動きから全体のメッシュ運動を復元する際、幾何の種類ごとに異なる振幅の壁を「無次元の事前知識」で解く手法Cepheidが登場した。骨格や対応付けなしで布や脚式ロボットにも適用できる。
291 件
疎な頂点の動きから全体のメッシュ運動を復元する際、幾何の種類ごとに異なる振幅の壁を「無次元の事前知識」で解く手法Cepheidが登場した。骨格や対応付けなしで布や脚式ロボットにも適用できる。
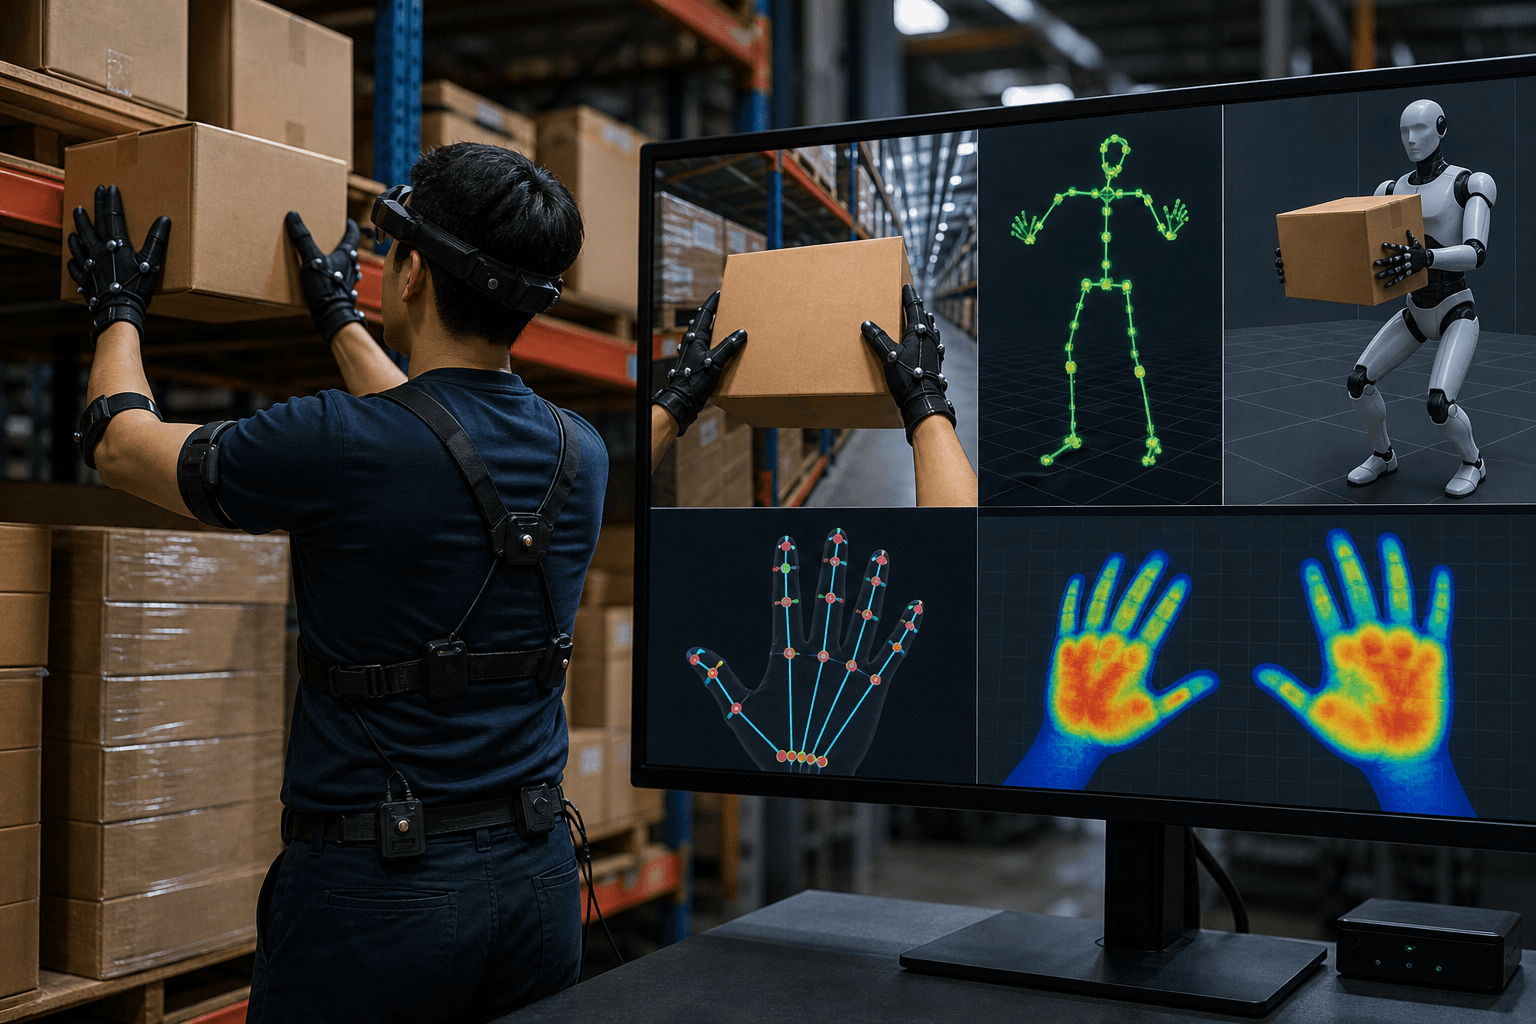
視線映像・全身動作・指の動き・触覚を同時に記録した100時間のデータセット「EgoExplorer」が公開された。人型ロボットに現場作業を教えるための基盤となり得る。
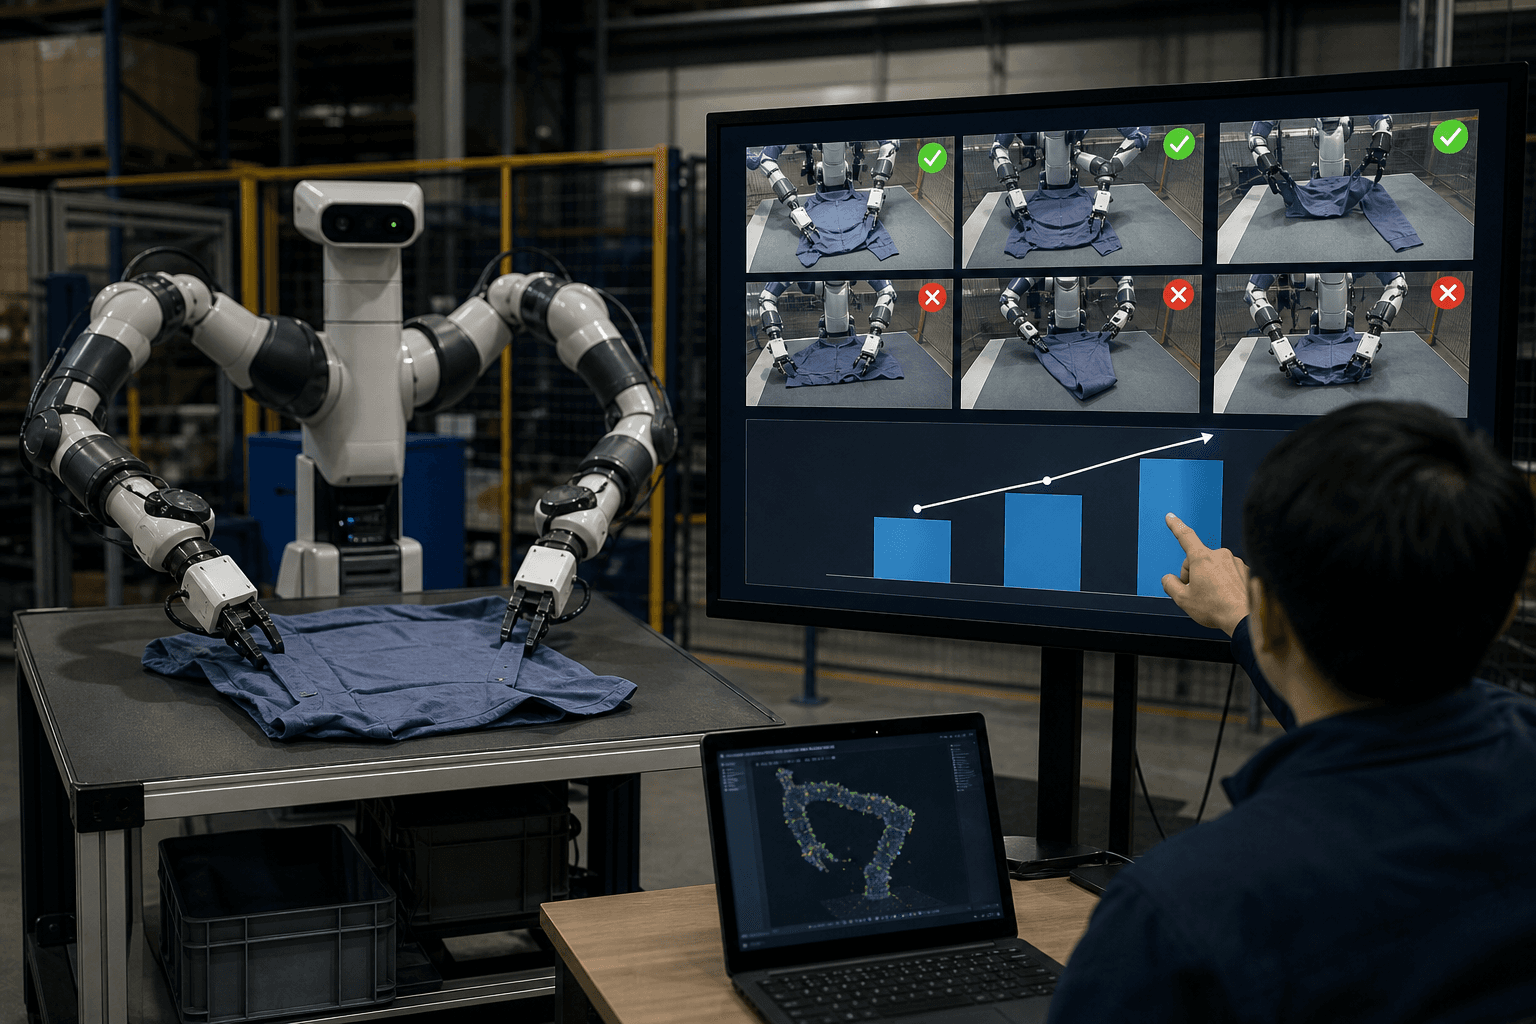
清華大学などの研究チームは、成功も失敗も含む実稼働の記録から学び、ロボットの作業成功率を段階的に高める手法LoopWAMを発表した。現場データの活用法を変える可能性がある。
LLMがロボットを操る「エージェント型ロボティクス」で、動作を連鎖実行の塊に束ねる手法ChunkActが登場した。LLM呼び出しを2.9分の1に抑え、成功率も5.0ポイント改善した。
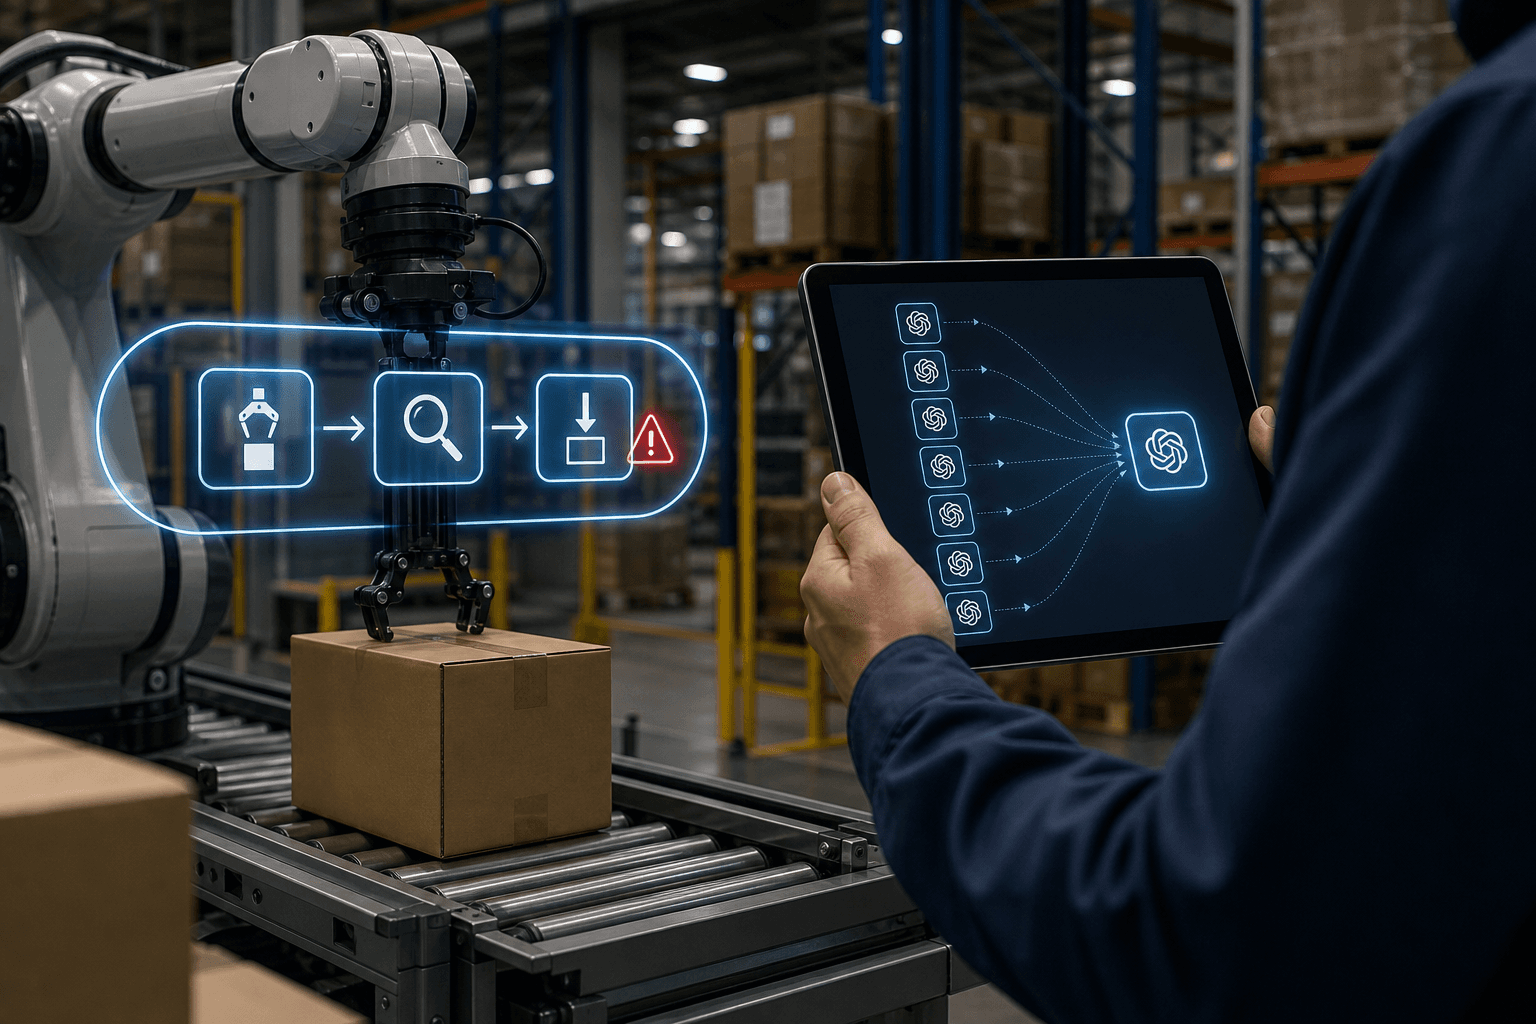
Chronos Policyは、観測の取得時刻と行動の実行時刻をロボット方策に明示的に与える手法である。センサーや推論の遅延が揺れる現場でも、動作の安定性を保てる可能性を示した。
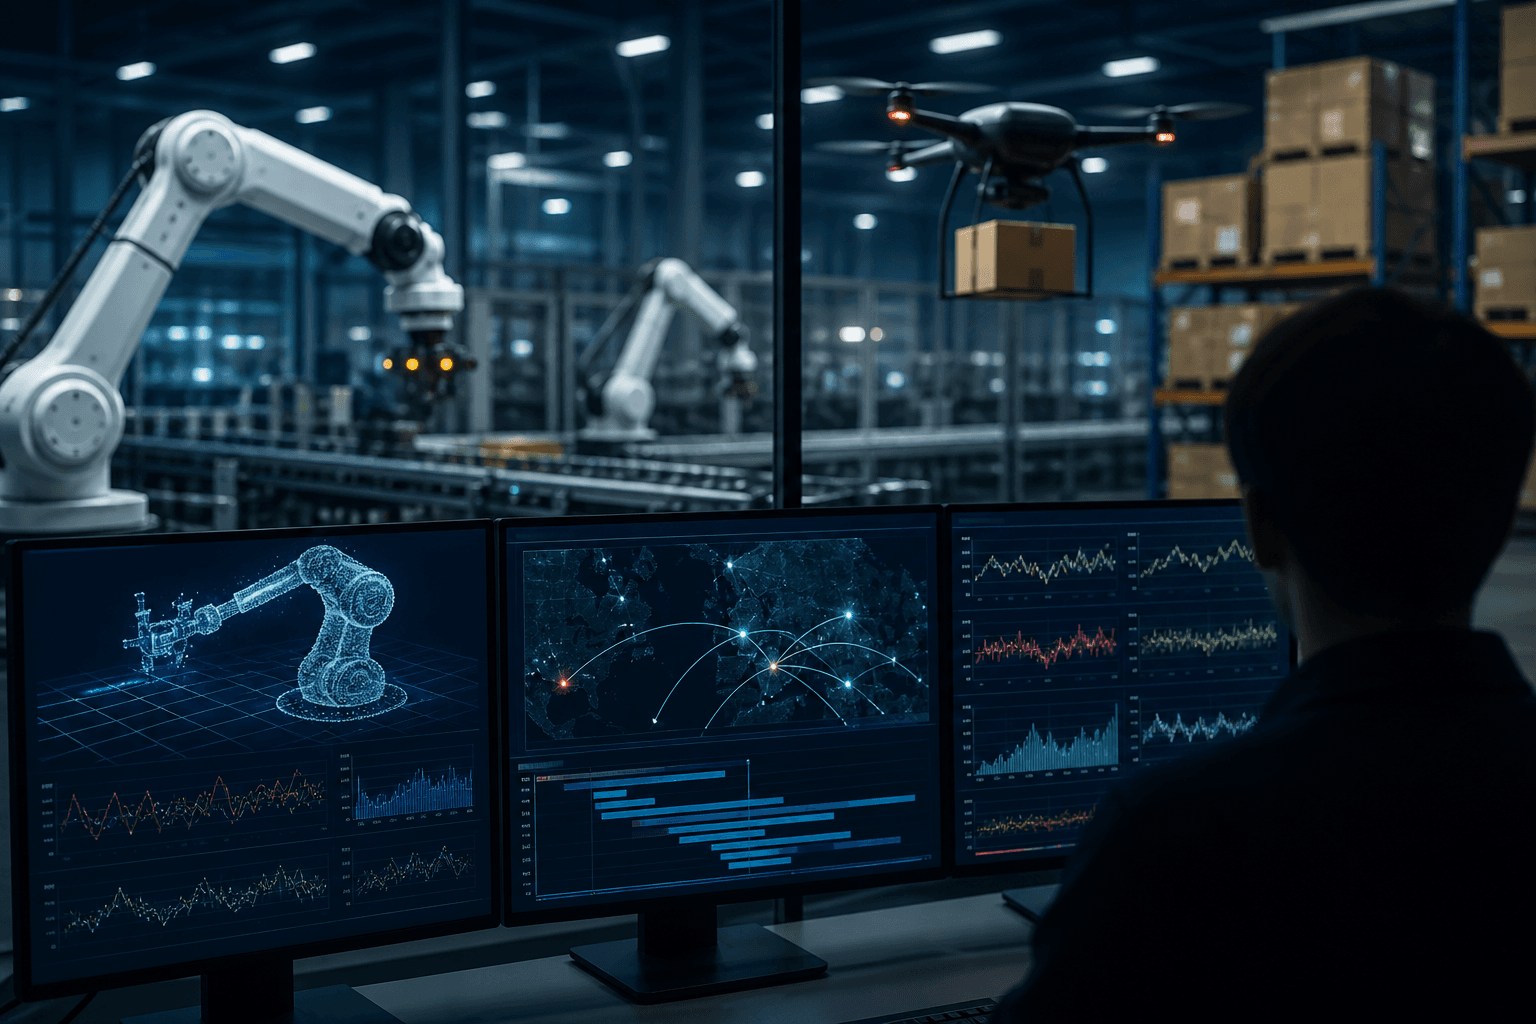
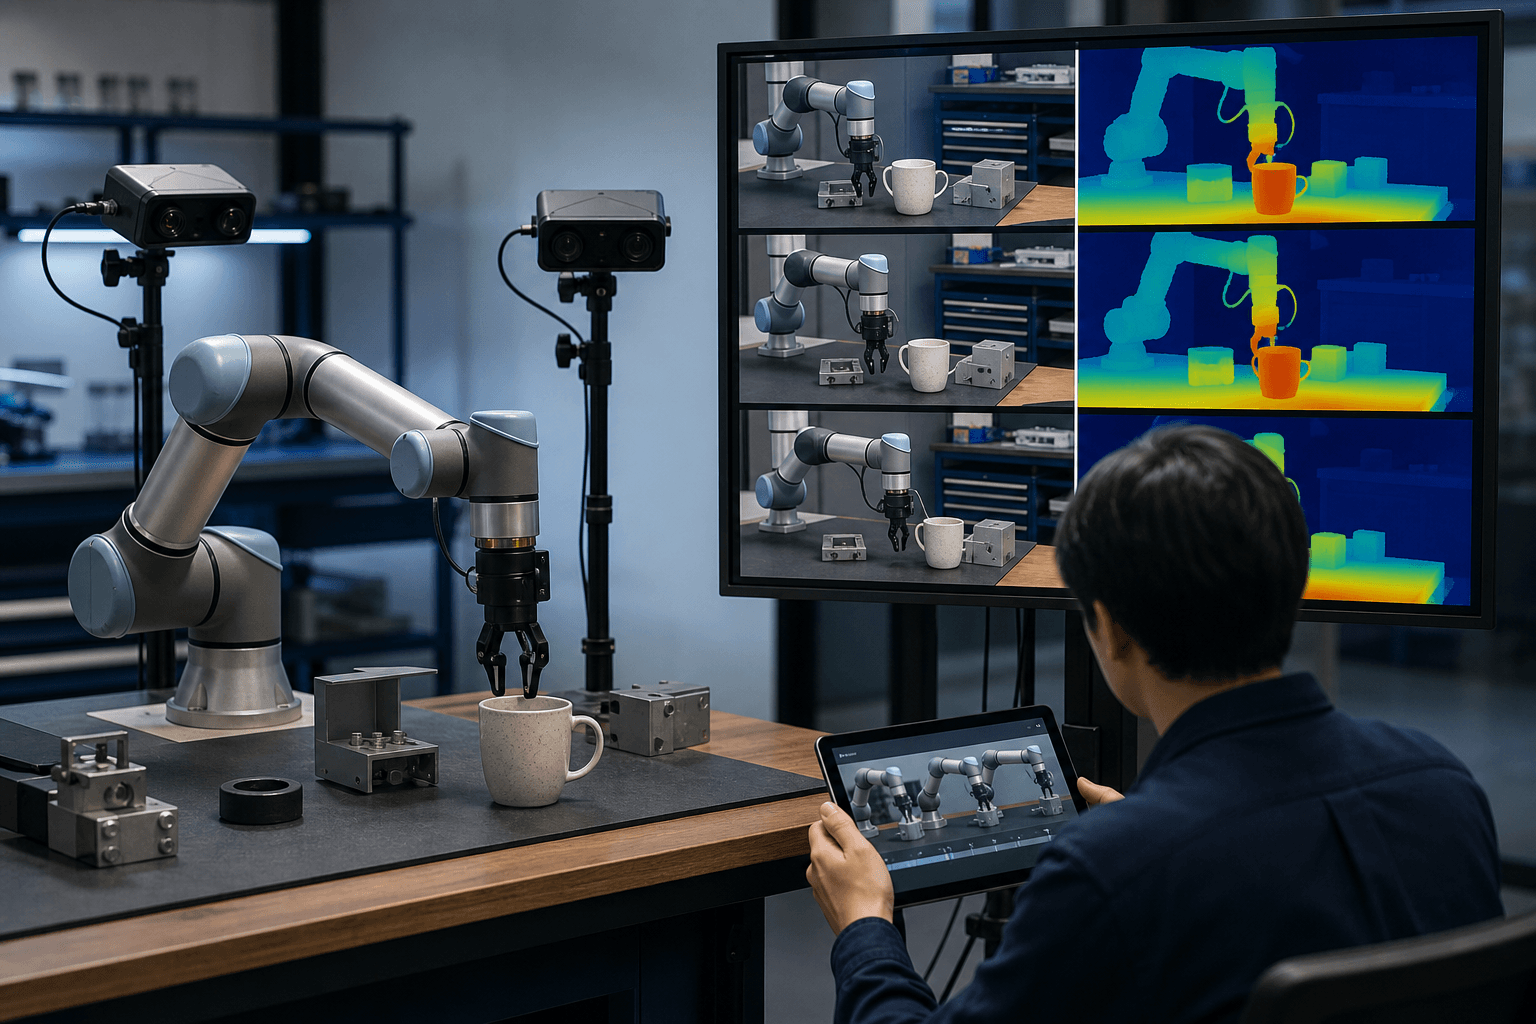
スマートフォンによる室内スキャンだけで、汎用ロボット制御AIを個別の現場に適応させる手法が登場した。実機での把持成功率は63.9%に達し、現場ごとの実演収集コストを抑える道を開く。
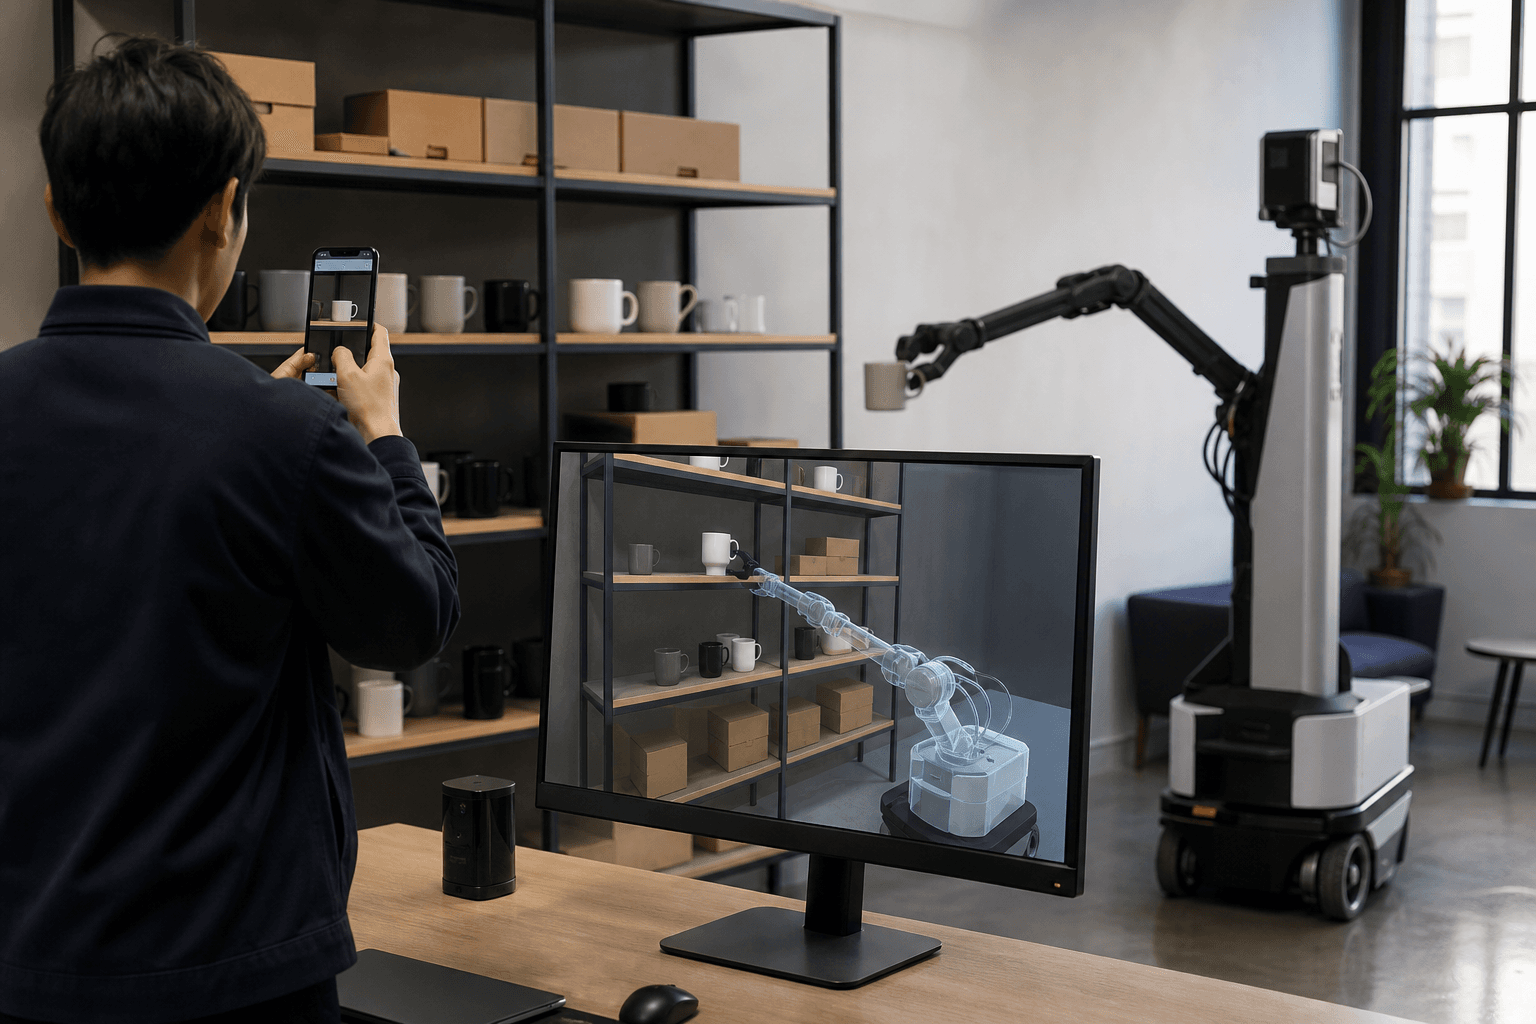
オックスフォード大などの研究チームが、重力下での安定性や衝突のない動きを備えた可動3D資産を自動生成する多エージェント方式「Artisan」と評価基準を公開した。見た目中心の3D生成が、実用段階へ進む。
外部カメラの映像から作業者の一人称視点を生成する新手法LEGOが登場した。深度推定や点群化を省き、構造を担う変換器と細部を担う拡散モデルを分担させ、従来法を上回る精度を示した。
独Bi-FORKは、座屈など一つの入力から複数の解が生じる分岐現象を、生成モデルで一度に復元する。最大26万点の高次元系にも対応し、シミュレーション代替の適用範囲を広げる。
単一のTransformerブロックを繰り返し使う画像認識モデル「reViT」が、全層モデルと同等の精度を保ちつつ保存パラメータを約70%減らした。端末搭載や配布のコストを下げる道を開く成果である。
カメラの台数や位置が変わっても動作するロボット操作AI「VersaCamVLA」が提案された。現場ごとの再学習を減らせる可能性があり、導入コストの抑制に資する。
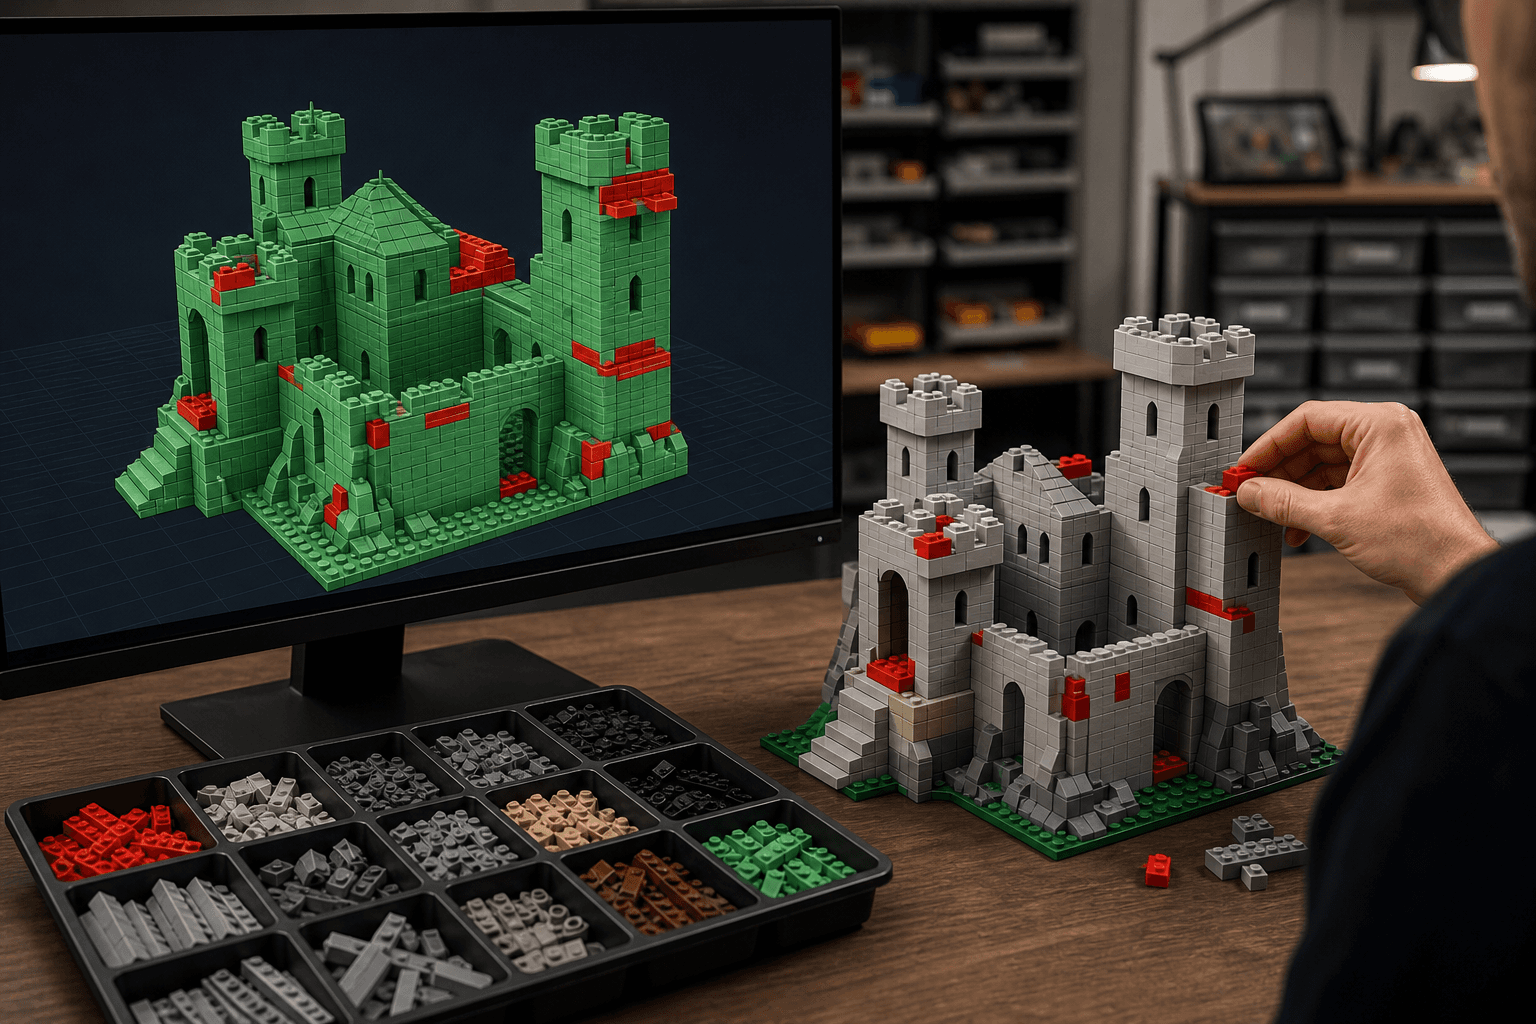
スタンフォード大などがレゴ設計をAIに課す評価基準BrickBenchを公開した。最新エージェントは物理的な組み立て可能性を概ね満たすが、人間の設計には及ばず、製造設計での実用性を測る物差しとなる。
研究チームが、初期画像と目標だけから次の行動を決めて動画化し、結果を見て完了まで進める世界モデル「WorldGuide」を発表した。手順書や研修動画の制作を変える可能性がある。
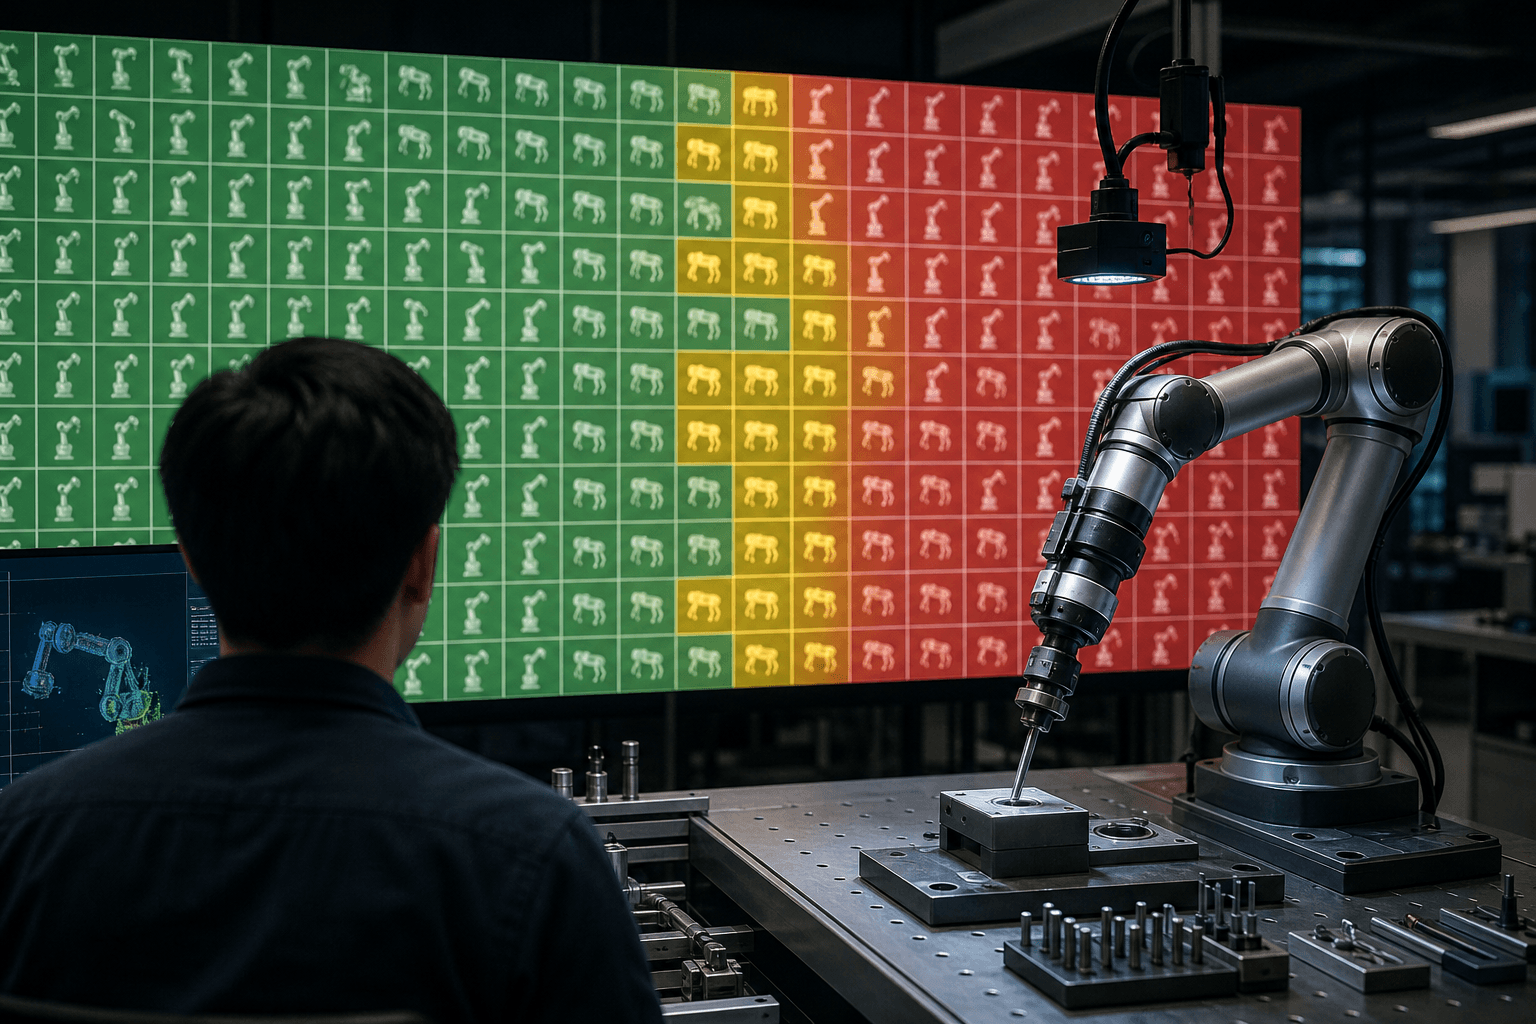
米研究チームは、ロボットの強化学習で習熟度の「境界」にある課題へ学習を集中させる手法SGSを開発した。100万超の並列環境でも効果が出て、組立や脚式移動の自動化に道を開く。
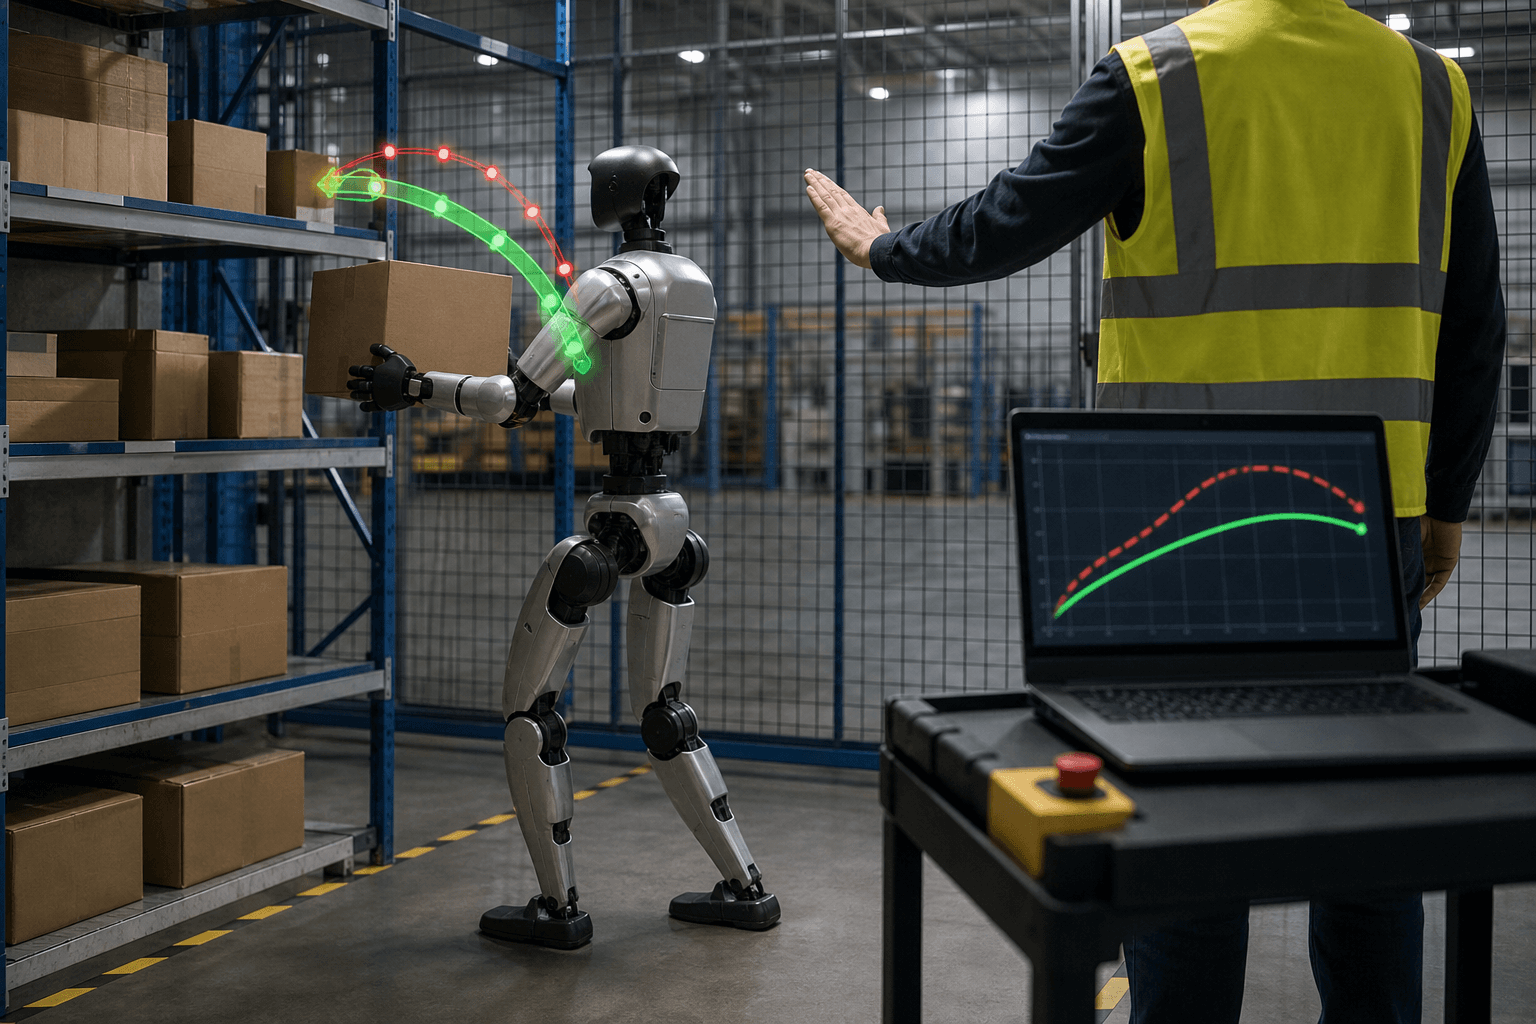
米研究チームは、人型ロボットの動作生成AIに追加学習なしで後付けできる安全フィルタ「CSF」を発表した。状況次第で意味が変わる動作の危険を、自然言語の規則から抑える。
ロボットの動作から未来の映像を予測する世界モデル「DreamTrue」が、人手評価の相互作用の欠陥率を48.12%から6.25%へ下げた。実機で試す前に映像で動作を検証できる可能性を示す。
動画1本から多指ロボットハンドの操作方針を学ぶ枠組み「Dex-One2Many」が登場した。映像を場面グラフに抽象化して強化学習を導き、未知の配置でも既存手法を71%上回った。
視覚言語行動モデルは指示の一語の違いで成功率が大きく変わる。米研究者らは方策を改変せず、指示を事前に言い換える規則で未知タスクの成功率を高める手法を示した。
Long-WAMは最大19.2秒の映像履歴を使い、ロボットの操作成功率を63.3%から78.7%へ高めた。履歴の長さより事前学習の方式が効果を左右する点が、現場導入の鍵となる。
ロボット操作の予測映像に奥行き情報を加えた世界モデル「DepthWorld」が発表された。奥行きの学習が映像予測自体も改善し、実機を使わない動作評価の信頼性を高める可能性がある。