拡散言語モデル、構造改良で生成品質が向上
連続拡散言語モデル向けに設計したTransformer「LangDiT」が、学習目的や推論手法を変えずに生成品質の指標を大幅に改善した。並列生成型AIの実用化に向けた設計指針となる。
研究の概要
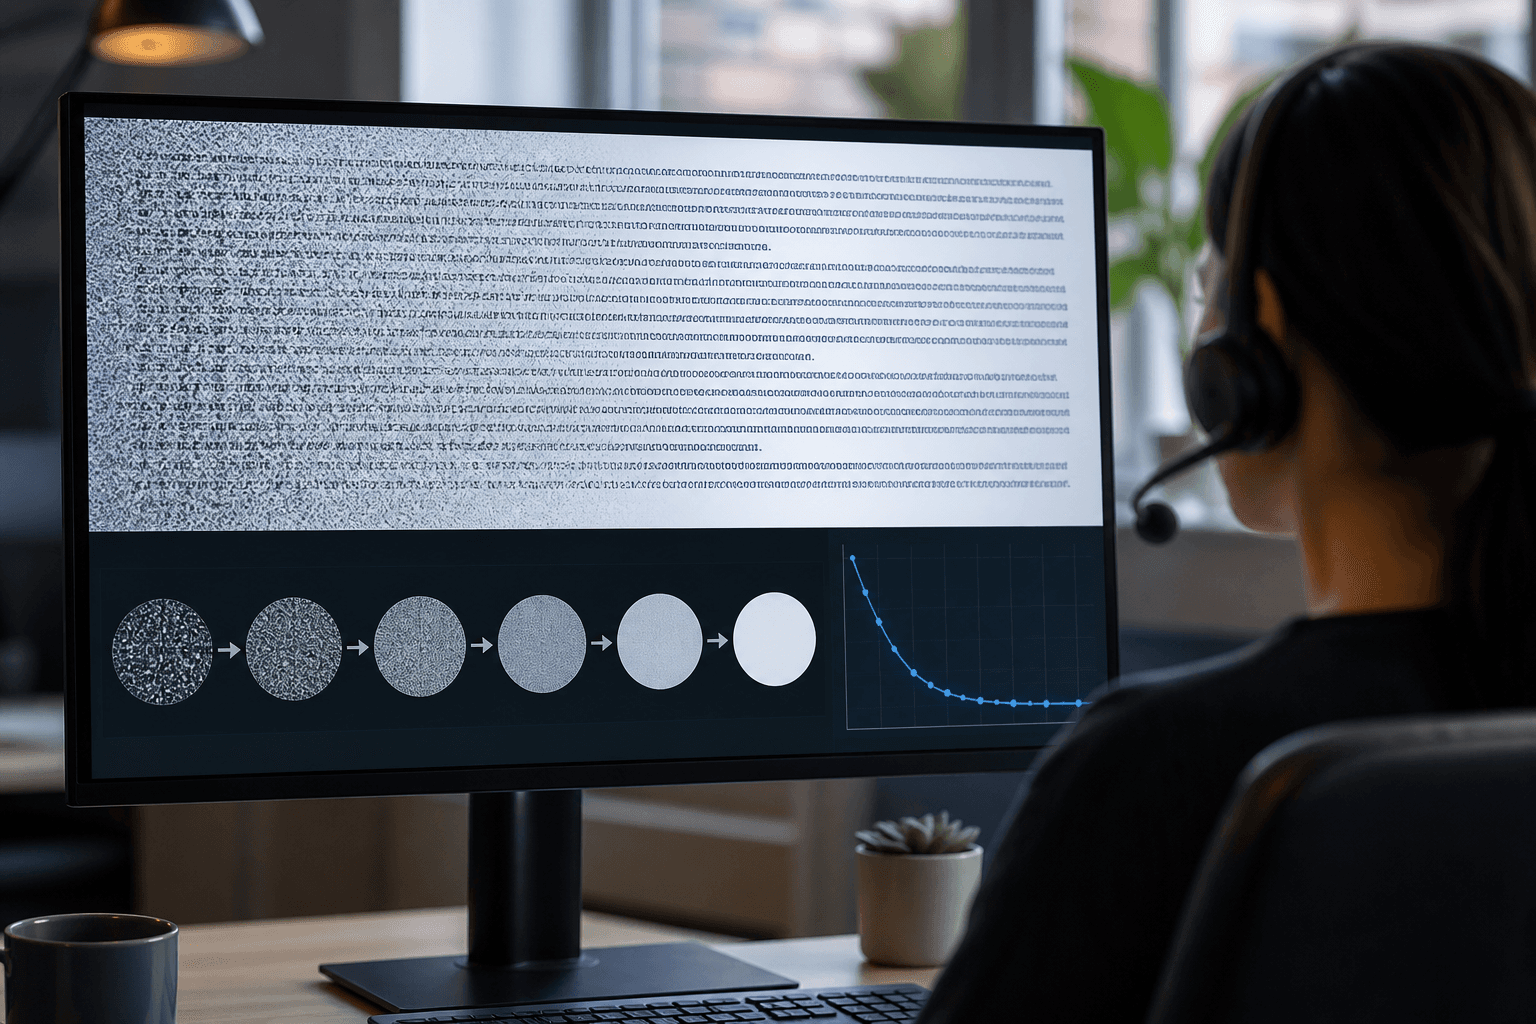
Weijian Luo氏らの研究チームは、連続拡散言語モデル(CDLM)に適したTransformer構造「Language Diffusion Transformer(LangDiT)」を提案した。CDLMは、文章を一語ずつ順番に作る一般的な大規模言語モデル(LLM)と異なり、ノイズを含んだ状態から複数回の除去処理を重ね、文章全体を並列に仕上げていく方式である。
これまでのCDLM研究の多くは、一語ずつ生成するLLM向けの構造、または画像生成用のDiffusion Transformer(DiT)をそのまま流用してきた。本研究は、どちらもCDLM向けに最適化されたものではないという問題意識に立つ。
評価指標は生成文の自然さを測る生成パープレキシティ(GenPPL)で、値が小さいほど良い。OpenWebTextによる1024トークンの無条件生成で、代表的なCDLMであるLangFlowにLangDiTを組み込むと、1024回のノイズ除去(NFE)で21.72、128回で44.72となり、同方式として最高水準を更新した。Plaid型の定式化に適用した場合は、1024回で11.33、128回で27.51に達した。
重要なのは、各モデルが持つ表現方法、学習目的、推論時のサンプラーを変えていない点である。改善がTransformer構造そのものに由来することを切り分けて示した。
しくみをやさしく
LangDiTは四つの工夫を組み合わせている。第一は、特徴量とクエリ・キーの正規化である。内部の数値が極端に大きくなったり偏ったりするのを抑え、学習を安定させる。
第二は、ノイズ条件付けの拡張である。モデルは今どの程度ノイズが残っているかを知る必要があり、その情報をより幅広く各層に伝えることで、段階ごとに適した処理をしやすくする。
第三は、尤度ショートカットの勾配ルーティングと較正である。学習時の誤差信号をどの経路で流すかを整理し、出力の確からしさの見積もりを補正する。
第四は、確信度で制御する学習時の自己条件付けである。モデルが自分の前段階の予測を手がかりに使う仕組みで、予測に自信がある場合だけ活用することで、誤った予測に引きずられるのを防ぐ。
たとえば下書きを何度も推敲する作業にたとえれば、推敲の段階を把握し、自信のある箇所だけを手がかりに直す仕組みである。
ビジネスへの示唆
並列生成の利点は、文章全体を一度に磨ける点にある。たとえば営業部門が日々作成する提案書の定型文、カスタマーサポートの返信文案、コンプライアンス部門の規程文書の下書きなど、一定の長さの文章を大量に作る業務で、応答速度と品質の両立が課題になる。
自部署で毎日繰り返し作られる文章は何か、それを誰がどれだけの時間をかけて直しているか、まず問い直す必要がある。
影響が見込まれる部門と指標は次のとおりである。
- カスタマーサポート:初回応答時間、一次解決率、オペレーターの修正工数
- 営業・マーケティング:資料作成のリードタイム、文面の修正回数
- 法務・総務:下書き作成から承認までの所要日数
ただし本論文は無条件生成での評価であり、実業務での指示追従や事実の正確さを直接検証したものではない。品質が上がっても、業務での有用性は別途確認が要る点に留意したい。
現場での導入イメージ
仮に導入支援に入るなら、次の流れで進める。
- 棚卸し:文章作成業務のうち、件数が多く、定型性が高く、修正に手間がかかるものを洗い出す。到達点は、どの業務で待ち時間や修正が詰まっているかを担当者と共有できる状態である。
- 差し込み先の設計:新しいツールを増やさず、既存の文書作成システムや社内の検索拡張生成(RAG)の生成部分に、拡散型モデルを選択肢として載せられるかを検討する。到達点は、現行の業務画面のまま下書きだけが差し替わる状態である。
- 小さく試す(PoC):一つの部署で数週間、現行方式と並べて担当者の実感を比較する。到達点は、修正の手間が減ったかを現場の言葉で判断できる状態である。
- 運用と横展開:品質確認の基準と人による最終確認の手順を整え、近い業務を持つ他部署へ広げる。到達点は、基準に沿って安定的に使い回せる状態である。
全体として目指すのは、文章作成の待ち時間と修正負担を、小さく・安く始めながら着実に減らせる運用体制である。
今後の展望
構造改良だけで品質が伸びた事実は、モデルの大型化に頼らない改善余地が残ることを示す。今後は指示に従う条件付き生成や、長文・多言語での検証が実用化の焦点となる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
エージェント群が入札で役割分担を学ぶ
複数のAIエージェントが「入札」で担当を決め、行動と役割分担を同時に学ぶ手法MPTが発表された。司令塔なしで、再利用・増員・欠員に強い自律的な業務分担を実現する。
着想の多様性を学ぶAI、大型モデルを上回る
米研究チームは、先行論文から互いに異なる研究案を一度に出す80億パラメータのAIを開発した。質と多様性を合わせた指標で大型の商用モデルを上回り、企画・研究開発の案出しを変える可能性がある。
KnowGPOが検索AIの調査工程を知識で採点
検索AIが多段階の調査を進める際、各手順の貢献を「獲得した知識」で測る学習法KnowGPOが提案された。8Bの小型モデルで多くの32B級を上回り、調査業務の自動化を現実的な費用で進める可能性がある。