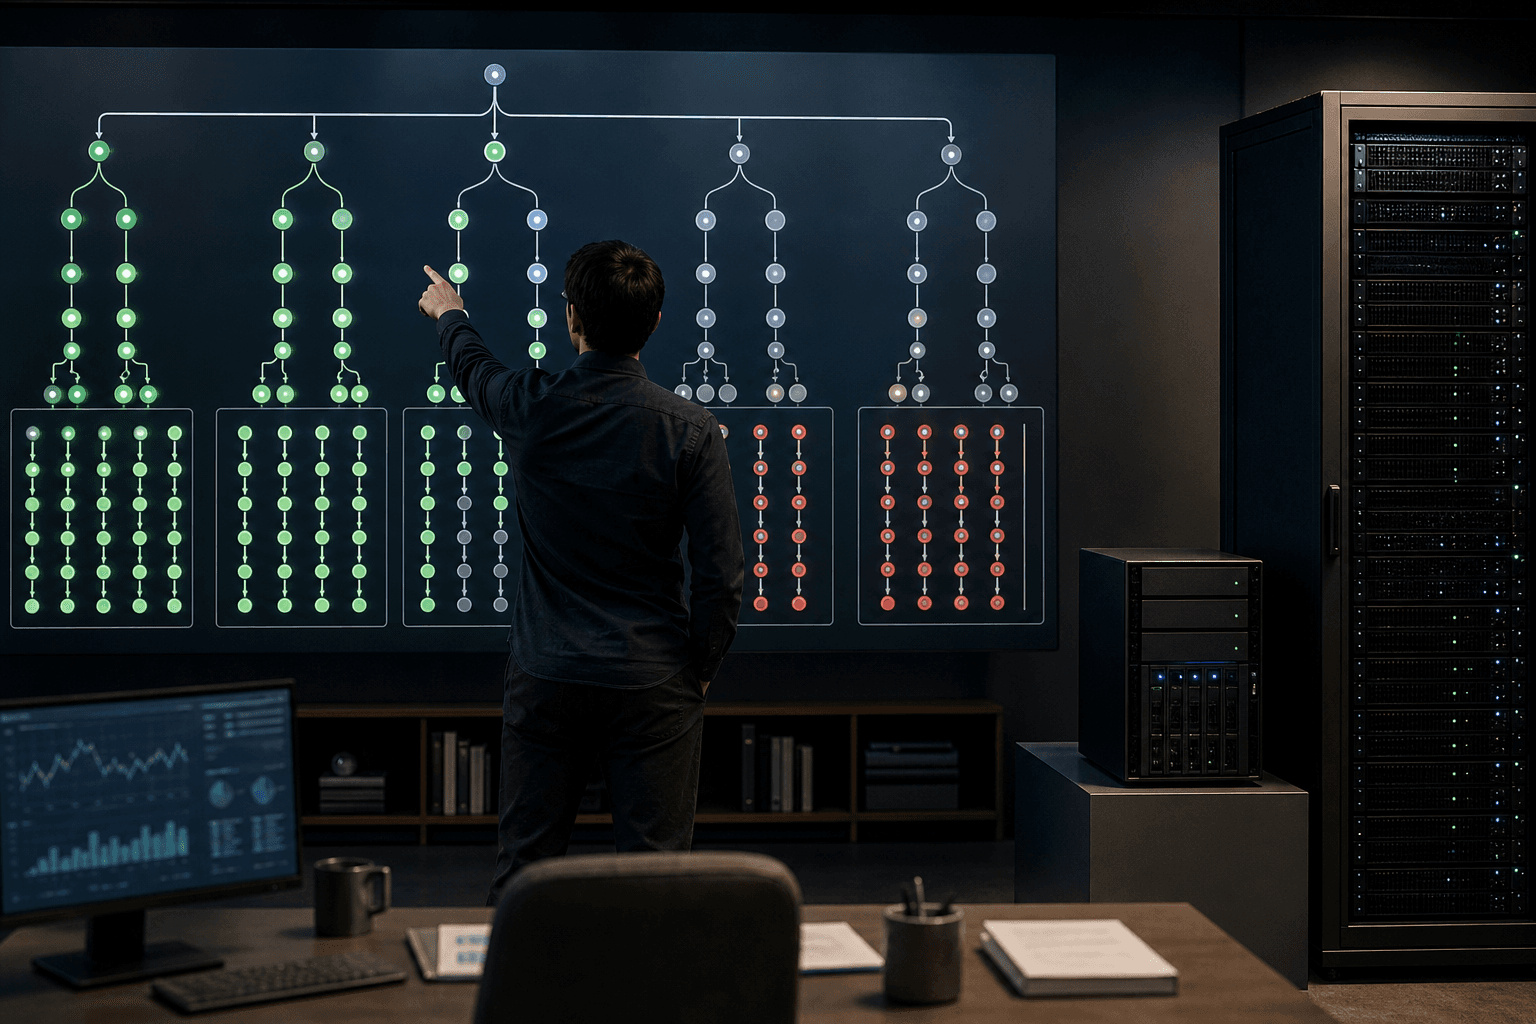
エージェント群が入札で役割分担を学ぶ
複数のAIエージェントが「入札」で担当を決め、行動と役割分担を同時に学ぶ手法MPTが発表された。司令塔なしで、再利用・増員・欠員に強い自律的な業務分担を実現する。
研究の概要
複数のAIエージェントに仕事を任せる際、成果は個々のエージェントの能力と、その連携の仕方の双方で決まる。ところが従来のマルチエージェントシステムは、あらかじめ固定した指揮構造の中で各エージェントを訓練することが多かった。個の能力の学習と、集団としての組織化が切り離されていたのである。
今回の研究は、この分断を解く市場型ポストトレーニング(MPT)を提案した。各エージェントが「いまの局面で自分が動きたい度合い」を入札として表明し、その結果で誰が行動するかが決まる。行動方針と入札行動の両方を学習するため、中央の司令役エージェントを置かずに、個の能力と参加の仕方が一緒に育つ。
評価は、仮想環境での道具づくり(クラフト)、ロボットのナビゲーション、そして複数の情報源を調べて回答をまとめるディープリサーチの3領域で行われた。単一モデルをまとめて訓練する従来方式を上回り、学習が進むにつれて各エージェントの参加の仕方が実際に変化することも確認されている。
しくみをやさしく
仕組みは、社内の案件を担当者が「手を挙げて」引き受ける場面に似ている。案件が出るたびに各エージェントが入札し、最も意欲の高い者が実行する。
学習で重要なのは、成果の配分である。チーム全体の結果は、実際に行動したエージェントへ局所的な訓練の手がかり(クレジット)として返される。入札そのものも成果に応じて磨かれるため、得意な局面では積極的に、不得意な局面では控えるという自己判断が身につく。
論文の分析では、同じ行動方針を使っても、学習済みの入札による自己組織化が他の協調方式を上回った。さらに、行動と入札のどちらも学習する意義があること、学習された入札のほうが行動の訓練信号として有効であることが、要素を一つずつ外す実験で示されている。
ビジネスへの示唆
注目すべきは、訓練時の目的を超えた三つの性質である。関連する新タスクへの適応が速いこと、推論時にエージェントを増やすほど性能が上がること、一部が脱落しても人数が多い群ほど性能低下が小さいことである。再利用、拡張、頑健性という、運用で最も費用のかさむ課題に対応する。
想定される業務は、たとえば調査部門や経営企画部門の競合・市場リサーチである。業界動向、規制、財務情報を複数の観点から調べ、一本のレポートにまとめる作業は、毎週のように発生する。カスタマーサポートの問い合わせ振り分け、物流・工場での搬送ロボットの経路分担も、同じ構造をもつ。
読者が自問すべきは、自部署でその種の「分担して調べ、突き合わせる」業務は何か、いま誰がどれだけ手をかけているか、という点である。動くKPIは、調査・回答のリードタイム、担当者の工数、手戻り率、そして一部の担当や機器が止まったときの業務継続性である。
- 調査・企画部門:レポート作成の所要時間、情報の抜け漏れ
- サポート部門:一次回答までの時間、エスカレーション率
- 製造・物流部門:搬送の滞留、設備停止時の影響範囲
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。ただし本論文は研究段階の成果であり、実業務での効果は個別の検証が前提となる。
-
棚卸し:複数人で分担し、後で突き合わせている業務を洗い出し、どこで待ちや重複が起きているかを可視化する。目指す到達点は、分担の自動化に向く業務の候補が、担当者の実感と一致する形で絞られている状態である。
-
差し込み先の設計:新しいツールを増やさず、既存の社内検索(RAG)や問い合わせ管理、ロボット運用基盤の上に、役割の異なる複数エージェントを載せる。目指す到達点は、現場の操作手順を変えずに分担ロジックだけが裏側で動く状態である。
-
小さく試す(PoC):一部署、数週間の範囲で、固定の分担方式と並べて比較する。評価は数値だけでなく、担当者が「重複が減った」「抜けが減った」と実感できるかで確かめる。目指す到達点は、小さく安く始めても効果の有無を判断できる状態である。
-
運用と横展開:参加の偏りやエージェントの欠員時の挙動を点検する基準を整え、関連業務へ広げる。論文が示す再利用性と増員時の性能向上は、この段階の追加コストを抑える可能性がある。目指す到達点は、他部署が同じ仕組みを自分の業務へ転用できる状態である。
全体として目指すのは、人が分担表を作り続けなくても、状況に応じて役割が自然に決まり、欠員が出ても業務が止まりにくい組織的なAI運用である。
今後の展望
実験は仮想環境とベンチマークが中心であり、企業の機密情報や承認フローを伴う業務での検証は今後の課題である。入札の偏りが特定エージェントへの集中を招かないかなど、運用上の監視も欠かせない。コードと学習済みモデルは公開されており、自社業務への当てはめを早期に試す環境は整っている。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
着想の多様性を学ぶAI、大型モデルを上回る
米研究チームは、先行論文から互いに異なる研究案を一度に出す80億パラメータのAIを開発した。質と多様性を合わせた指標で大型の商用モデルを上回り、企画・研究開発の案出しを変える可能性がある。
拡散言語モデル、構造改良で生成品質が向上
連続拡散言語モデル向けに設計したTransformer「LangDiT」が、学習目的や推論手法を変えずに生成品質の指標を大幅に改善した。並列生成型AIの実用化に向けた設計指針となる。
KnowGPOが検索AIの調査工程を知識で採点
検索AIが多段階の調査を進める際、各手順の貢献を「獲得した知識」で測る学習法KnowGPOが提案された。8Bの小型モデルで多くの32B級を上回り、調査業務の自動化を現実的な費用で進める可能性がある。