KnowGPOが検索AIの調査工程を知識で採点
検索AIが多段階の調査を進める際、各手順の貢献を「獲得した知識」で測る学習法KnowGPOが提案された。8Bの小型モデルで多くの32B級を上回り、調査業務の自動化を現実的な費用で進める可能性がある。
研究の概要
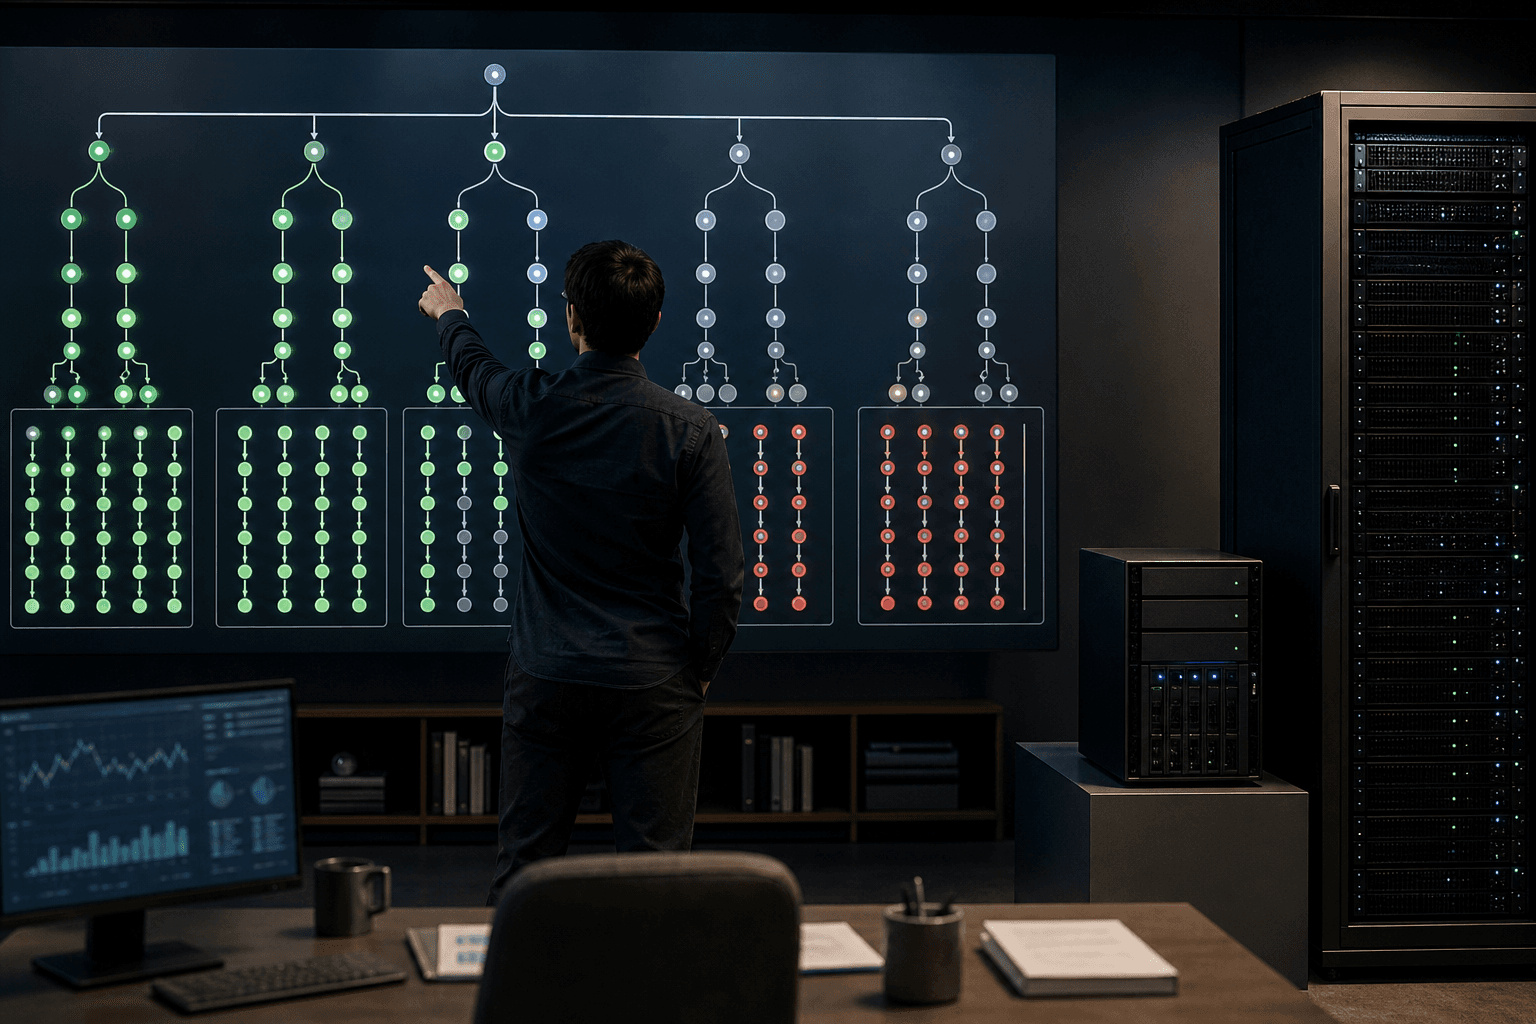
複数回の検索と閲覧を重ねて答えを導く「ディープサーチ型エージェント」の学習手法として、研究チームはKnowGPOを提案した。この種のAIは、最終的に答えが合っていたかどうかという結果報酬だけで強化学習を行うと、数十回に及ぶ検索のうちどの判断が良かったのかを判別できない。これを信用割当の難しさという。
既存の工程評価手法も、画面や検索結果といった表面的な状態、あるいはモデル内部の信号を手がかりにしている。しかし検索結果は種類が雑多で長くノイズも多く、これらの手がかりは信頼しにくい。
実験はXbench、BrowseComp-ZH、GAIAの3種類のベンチマークで行われた。KnowGPOは結果のみで学習するGRPO、工程評価を取り入れたGiGPOとIGPOを、いずれも3.8〜4.2ポイント上回った。8Bモデルが、多くの32Bオープンソース系システムに並ぶか上回ったと報告されている。
しくみをやさしく
中核は、軌跡を表面の見え方ではなく「どの知識を得たか」で揃えるという発想である。まず質問ごとに、答えを導くのに必要な情報を原子的な知識条件に分解する。たとえば「ある企業の創業者の出身校の設立年」であれば、創業者は誰か、出身校はどこか、設立年はいつか、といった具合である。
次に各ステップで、その時点までに満たした条件の部分集合を軌跡の「知識状態」とする。同じ知識状態にある軌跡どうしをグループにして比較すれば、検索結果の文面が違っていても、同じ進捗の中でどの打ち手が良かったかを公平に比べられる。
さらに、連続するステップの間で増えた知識を工程報酬とする。これは外部の検索結果から確認できる事実に基づくため、モデル自身の自信度のような内部信号より頼りやすい。営業で言えば、成約という結果だけでなく、商談ごとに「決裁者の特定」「予算感の把握」といった中間成果を採点する仕組みに近い。
ビジネスへの示唆
この手法が効くのは、複数の情報源をたどって結論を出す、調べものの業務である。たとえば法務部門の取引先の与信・反社チェック、経営企画部門の競合動向調査、調達部門の新規サプライヤー探索が該当する。いずれも、1回の検索では答えが出ず、調べた事実をつなぐ作業である。
読者はまず、自部署で該当する業務は何か、いま誰がどれだけ手をかけているかを考えてほしい。担当者が検索と確認を繰り返し、半日を費やしている調査があるなら、候補になる。
動く可能性のある指標は次のとおりである。
- 調査リードタイム(依頼から報告までの所要時間)
- 調査の抜け漏れ率と再調査の件数
- 担当者の調査工数と、外部調査会社への委託費
また8Bモデルで大型モデルに迫れる点は、自社環境で運用しやすい規模であることを意味し、機密情報を社外に出しにくい部門にも向く。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:調査系業務を洗い出し、依頼件数、所要時間、やり直しの頻度を記録する。到達点は、AIに任せる価値の高い調査業務を2〜3種類に絞り込むことである。
-
差し込み先の設計:新しい専用ツールを増やさず、既存の社内検索や文書基盤、チャットの依頼窓口にエージェントを載せる。あわせて、各業務の「答えに必要な条件」をチェックリスト化する。これはKnowGPOの知識条件に相当し、到達点は、担当者が普段使う画面から調査を依頼できる状態である。
-
小さく試す:一部署、数週間の範囲で、過去に人が行った調査をAIに再現させ、担当者の実感で確かめる。見るのは、条件の充足状況と根拠の提示である。到達点は、使える・使えないの判断材料を現場の言葉で得ることである。
-
運用と横展開:チェックリストと合否の基準を整え、うまくいった型を他部署へ広げる。到達点は、調査の質が個人の腕前に依存せず、基準で担保される状態である。
全体として目指すのは、調査の進捗が「どの事実まで判明したか」で見える化され、人は最終判断に集中できる職場である。
今後の展望
課題は、知識条件を自動で分解する精度が、業務領域ごとにどこまで保てるかである。社内文書や専門分野では、条件の定義に専門家の確認が要る場面も出てくるだろう。ただ、結果だけを見て学習させる方式より、途中経過を事実で採点する方式のほうが、AIの調査プロセスを監査しやすい利点がある。説明責任が重い金融、法務、医療の分野で、調査エージェントの採用を後押しする可能性がある。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
エージェント群が入札で役割分担を学ぶ
複数のAIエージェントが「入札」で担当を決め、行動と役割分担を同時に学ぶ手法MPTが発表された。司令塔なしで、再利用・増員・欠員に強い自律的な業務分担を実現する。
着想の多様性を学ぶAI、大型モデルを上回る
米研究チームは、先行論文から互いに異なる研究案を一度に出す80億パラメータのAIを開発した。質と多様性を合わせた指標で大型の商用モデルを上回り、企画・研究開発の案出しを変える可能性がある。
拡散言語モデル、構造改良で生成品質が向上
連続拡散言語モデル向けに設計したTransformer「LangDiT」が、学習目的や推論手法を変えずに生成品質の指標を大幅に改善した。並列生成型AIの実用化に向けた設計指針となる。