ロボットAI、動作を束ねLLM呼出を3分の1に
LLMがロボットを操る「エージェント型ロボティクス」で、動作を連鎖実行の塊に束ねる手法ChunkActが登場した。LLM呼び出しを2.9分の1に抑え、成功率も5.0ポイント改善した。
研究の概要
Bingxin Xu氏らの研究チームは、大規模言語モデル(LLM)をロボット制御の中枢に置く「エージェント型ロボティクス」の効率問題に取り組む論文「ChunkAct」を公開した。
エージェント型ロボティクスでは、LLMが知覚、移動、視覚言語行動モデル(VLA)といった道具を組み合わせ、過去の経験を蓄えた記憶を参照しながらタスクを遂行する。再学習なしに新しい作業へ対応できる汎用性が利点である。
その代償が効率の悪さである。従来方式では、動作の最小単位であるプリミティブを一つ実行するたびに、LLMが全対話履歴を読み直して推論する。このため一回の作業にかかる費用は、プリミティブの数に比例して膨らむ。
研究チームはこの推論の多くが冗長だと指摘する。サブゴールが決まれば、その後のプリミティブの並びは記憶にすでに書かれた定型手順に沿うからである。
ベンチマーク「LIBERO-Pro」での評価では、ChunkActは従来の最高水準を上回り、タスク成功率を5.0ポイント改善した。同時にLLM呼び出し回数は2.9分の1、入力トークンは4.4分の1、出力トークンは2.3分の1に減った。
しくみをやさしく
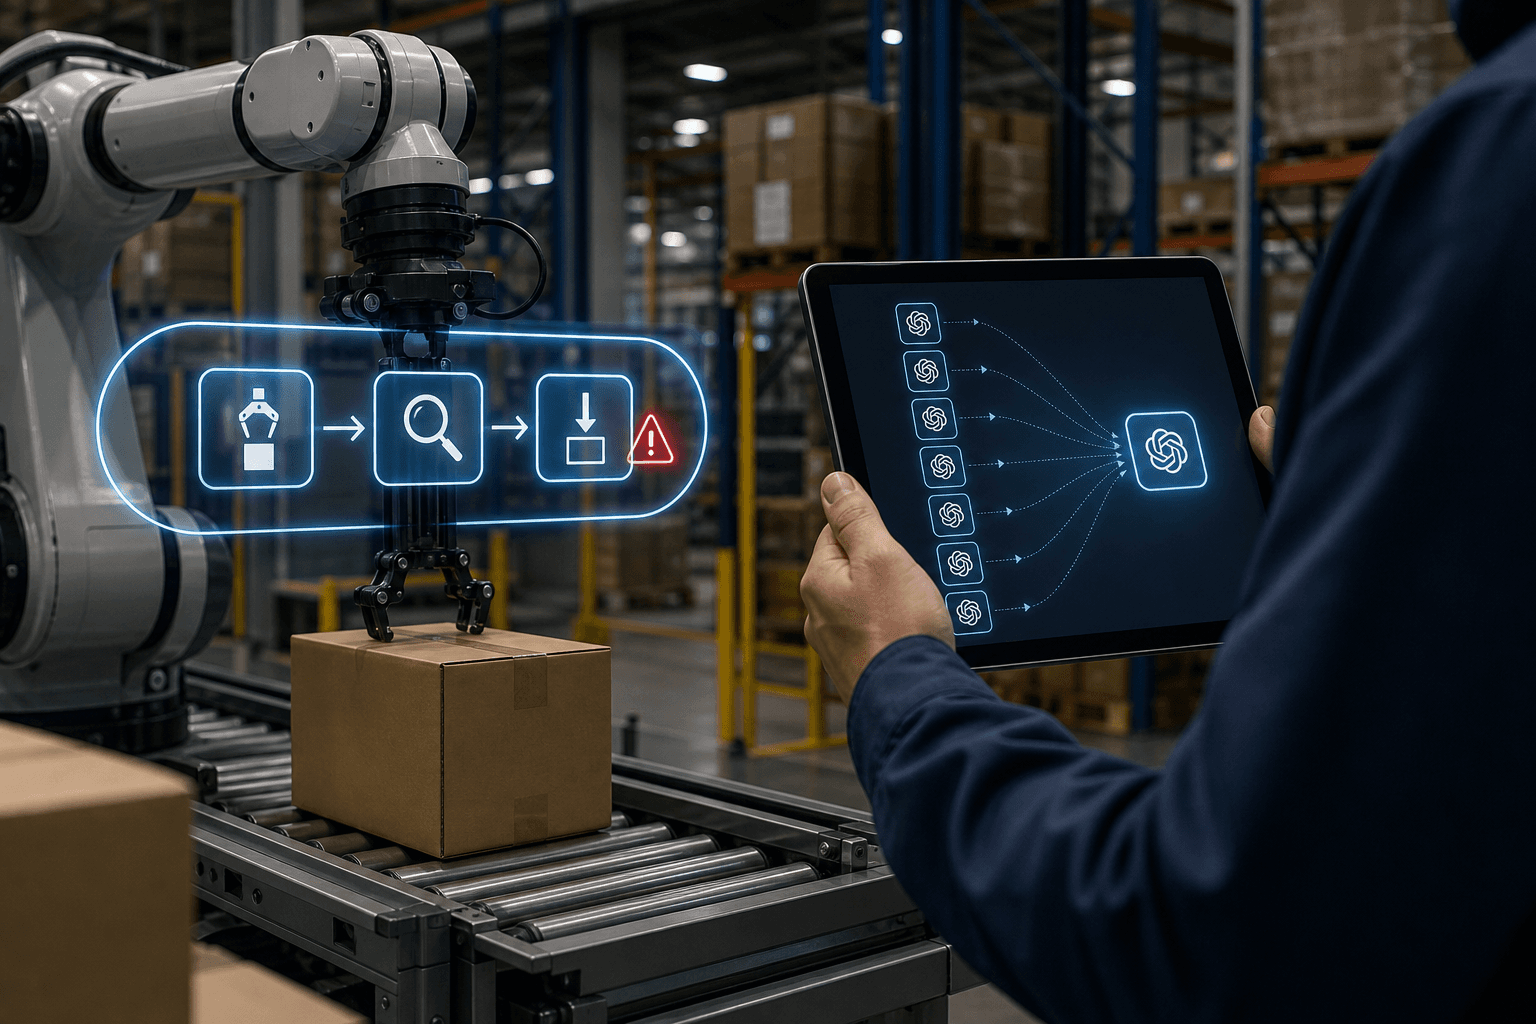
ChunkActの核心は、ロボット制御に「アクションチャンキング」を持ち込んだ点にある。チャンクとは、連続して実行する複数のプリミティブをひとまとめにした塊である。
オンライン実行では、LLMが一回呼び出されるだけで、チャンク内の連鎖したプリミティブが自律的に走る。途中で失敗が起きたときにだけ、制御がLLMへ戻される。
人の仕事に例えれば、新人が一動作ごとに上司へ確認する状態から、「この工程は手順書どおり進め、異常時だけ報告せよ」と任せる状態への移行である。
オフライン段階では、ChunkActが記憶をあらかじめチャンクへ「コンパイル」する。その結果、実行時には記憶を参照する必要がなくなる。LLMには、状況判断や方針選択といった本当に推論が必要な場面だけを担当させる。
これにより、LLMの計算量はプリミティブの数ではなく、判断の数に比例する構造になる。入力トークンの削減幅が大きいのは、毎回の全履歴の読み込みが不要になるためである。
ビジネスへの示唆
この成果は、ロボットを使う現場の運用費に直結する。ただしロボットに限った話ではない。「LLMが毎回全履歴を読み直して次の一手を決める」構造は、業務エージェント全般に共通するためである。
物流倉庫のピッキング工程を例に取る。棚から取り出し、検品し、箱へ詰める一連の動作は、毎回ほぼ同じ手順である。この定型部分まで逐一LLMに判断させれば、API利用料と待ち時間が積み上がる。
コールセンターの問い合わせ処理、経理の請求書照合、情シスの定型オペレーションにも同じ構図がある。定型手順は束ねて自動実行し、例外判断だけをLLMに回す設計である。
影響を受けやすい部門と、動く可能性のあるKPIは次のとおりである。
- 製造・物流の現場部門:サイクルタイム、タスク成功率、稼働率
- 情報システム部門:LLM利用料、応答遅延
- 経理・バックオフィス:一件あたりの処理時間、例外対応の比率
自部署に当てはめるなら、次の問いが出発点になる。毎日繰り返す業務のうち、手順がほぼ決まっているのに、人またはAIが一手ごとに確認している箇所はどこか。その確認に、いま誰がどれだけ手をかけているか。
現場での導入イメージ
仮に導入支援に入るなら、次の四段階で進める。
-
棚卸し:現場の作業やAIエージェントの動きを洗い出し、手順が毎回ほぼ同じ区間と、状況に応じた判断が要る区間を分ける。到達点は、「定型の塊」と「判断の分岐点」が一枚の図で見える状態である。
-
差し込み先の設計:新しいツールを増やさず、既存のエージェント基盤やRAG、手順書、業務マニュアルの上に載せる。過去の成功手順の記録を、塊として呼び出せる形に整理する。到達点は、既存の仕組みを変えずに「束ねて実行し、失敗時だけ戻る」経路が通る状態である。
-
小さく試す(PoC):一部署、一工程に絞り、数週間で試す。評価は担当者の実感を軸にし、待ち時間が減ったか、確認の手間が減ったか、例外時に正しく人へ戻ったかを確かめる。到達点は、現場が「これなら任せられる」と判断できる根拠が得られた状態である。
-
運用と横展開:どの塊を自動で任せ、どの場面で人やLLMに戻すかという基準を文書化する。失敗の記録を定期的に塊へ反映する仕組みも整える。到達点は、他部署が同じ型で導入できる状態である。
全体として目指すのは、判断が必要な場面にだけLLMと人の注意を集中させる運用である。定型作業に費やしていた手間と費用を、小さく・安く始めながら減らせる可能性がある。
今後の展望
本研究の評価はLIBERO-Proというシミュレーション系のベンチマークである。実環境のロボットや、手順が頻繁に変わる業務で同様の効果が出るかは、今後の検証課題である。
また、塊が長くなるほど、途中の異常をどこまで早く検知できるかが安全面の鍵になる。失敗検知の精度と、人への引き継ぎ設計が実用化の分かれ目になる。
それでも、「推論の回数を判断の数に比例させる」という発想は、ロボットに限らず、AIエージェントを業務へ組み込む際の設計原則として参考になる。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
ロボットAI、デモの質を学習時に明示し精度向上
ロボット用AIの事前学習で、人間デモの品質をタグとして与える条件付けが単純な模倣より成功率を高めると判明した。質の不揃いなデータを捨てずに活用する道筋を示す成果である。
疎な動きから全体の動きを復元する新手法
疎な頂点の動きから全体のメッシュ運動を復元する際、幾何の種類ごとに異なる振幅の壁を「無次元の事前知識」で解く手法Cepheidが登場した。骨格や対応付けなしで布や脚式ロボットにも適用できる。
装着型機器で人の作業100時間を記録
視線映像・全身動作・指の動き・触覚を同時に記録した100時間のデータセット「EgoExplorer」が公開された。人型ロボットに現場作業を教えるための基盤となり得る。