ロボットAI、デモの質を学習時に明示し精度向上
ロボット用AIの事前学習で、人間デモの品質をタグとして与える条件付けが単純な模倣より成功率を高めると判明した。質の不揃いなデータを捨てずに活用する道筋を示す成果である。
研究の概要
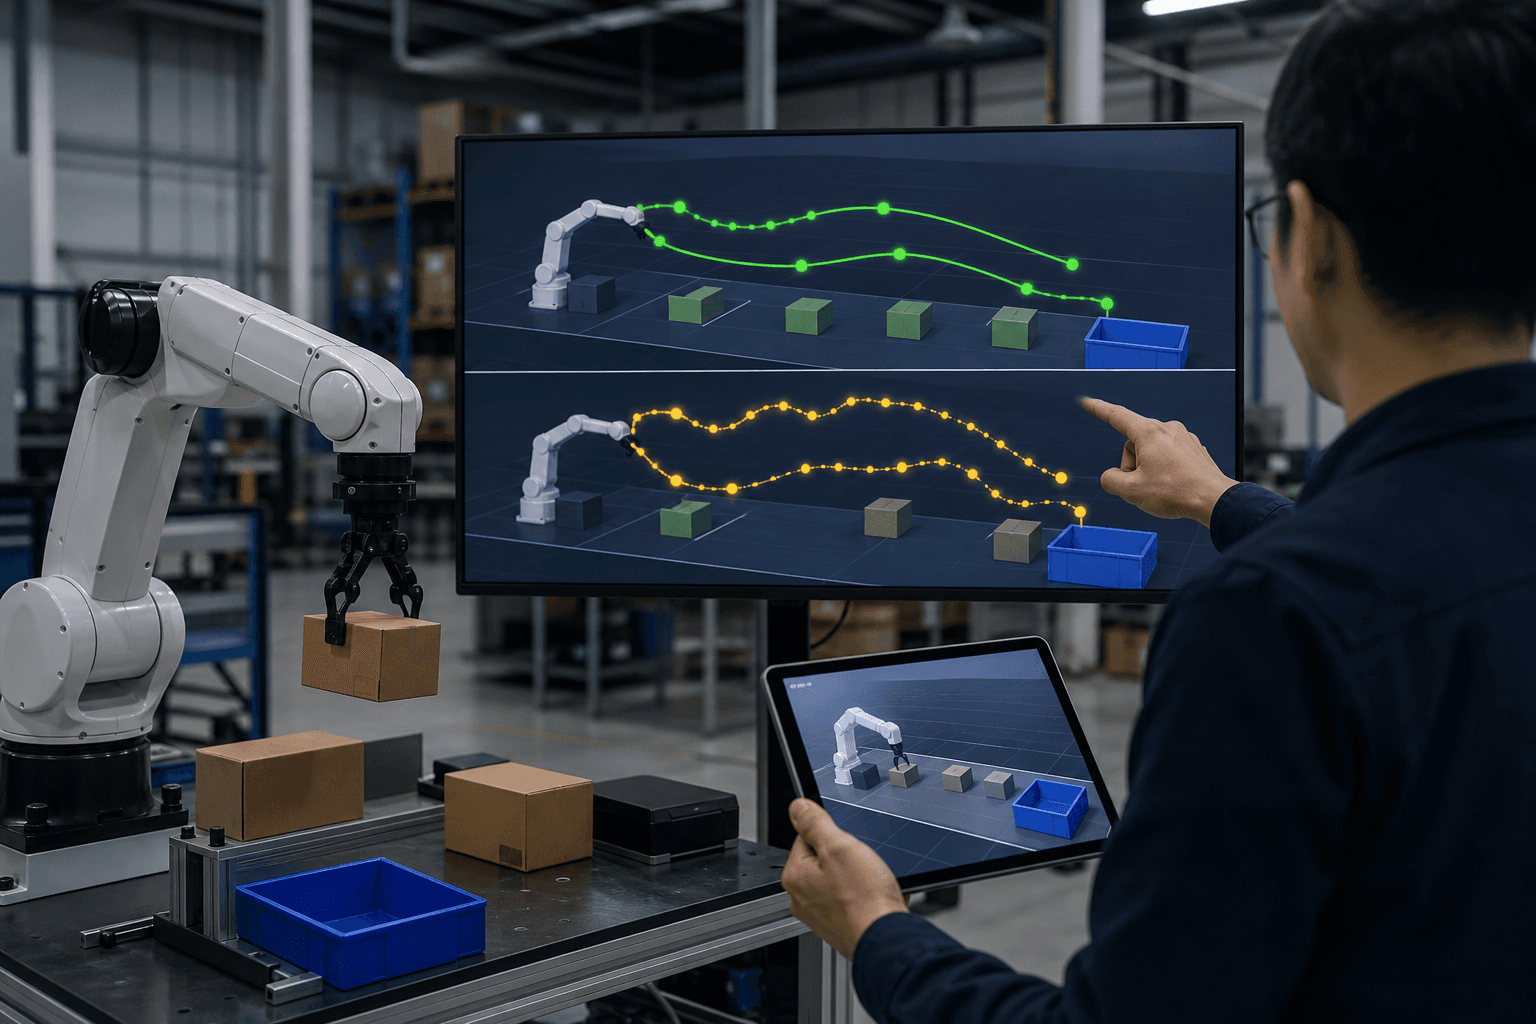
カメラ映像と言葉の指示から動作を出力するロボット用AI「視覚・言語・行動モデル(VLA)」は、大量の人間の操作デモで事前学習し、個別の作業向けに微調整して使う。ただし現実のデモには、手際のよい操作も無駄の多い操作も混在する。この品質のばらつきを事前学習でどう扱うべきかが、本研究の問いである。
研究チームは、質が自然にばらついた人間のデモ5,000件と24の目標タスクを用い、「重み付け」「フィルタリング」「条件付け」の三方式を比較した。報酬の定義やラベルの粒度も変え、各モデルでデモ量と学習予算をそろえている。3種のVLAを通じ、次の三点が確認された。
- 手法に応じたエピソード単位の条件付けは、単純な模倣学習(行動クローニング)より平均成功率が高い。
- 条件付けはエピソード単位、フィルタリングはチャンク単位のラベルが平均的に有利だが、モデルにより逆転も生じる。
- 条件付け事前学習の後、品質タグを一定値に固定して微調整すると、推論時にタグの有無を問わず平均成功率が改善する。
併せて比較基盤AXIS-Benchを公開した。クラウドソーシングで集めたシミュレーション上のデモに物体と接触の状態を記録しており、同じ軌跡に対して品質ラベルを何度でも再計算できる。実機実験では、シミュレーションでの事前学習により成功率が9.6%から31.7%へ上がった。
しくみをやさしく
従来の模倣学習は、すべてのデモを「お手本」として同じ重さで学ぶ。そのため、遠回りな操作や不安定な把持まで平等に吸収してしまう。
条件付けは、各デモに「この操作は質が高い/低い」というタグを添えて学ばせる方式である。AIは質の違いを区別したうえで動作を覚えるため、悪い例を悪い例として理解できる。フィルタリングは低品質デモを学習から外す方式、重み付けは質に応じて学習への影響度を変える方式である。
タグは、一連の作業全体に付ける「エピソード単位」と、短い動作区間ごとに付ける「チャンク単位」がある。調理で言えば、料理全体に点数を付けるか、包丁の入れ方など工程ごとに点数を付けるかの違いである。
微調整では、タグを常に「高品質」の一定値に固定する。これにより、実際に動かす段階でタグを用意できなくても、質の高い振る舞いを引き出しやすくなる。現場での扱いやすさに直結する知見である。
ビジネスへの示唆
恩恵が大きいのは、人が操作したデータが日々蓄積される現場である。たとえば物流倉庫のピッキング担当、工場の組立・検査ライン、食品工場の盛り付け工程では、熟練者と新人の操作記録が混在している。この記録を「質の低いものは捨てる」のではなく、タグを付けて丸ごと学習に使える可能性が示された。
読者が自問すべきは、自部署で遠隔操作や手本の記録が残っている業務は何か、そのデータの選別に誰がどれだけ手をかけているか、である。選別が人手の目視に頼っているなら、改善余地は大きい。
影響を受ける部署と動きうるKPIは次のとおりである。
- 生産技術・ロボット導入部門:新規作業の立ち上げ期間、教示データの収集・整備の工数
- 物流・製造の現場部門:自動化工程の成功率、手直し・再作業の発生率
- データ管理・品質保証部門:データ選別の人的負担、学習データの再利用率
シミュレーションでの事前学習が実機の成功率を押し上げた点も重要である。実機での試行は設備停止や破損のリスクを伴うため、仮想空間で先に学ばせる設計は、安全性と費用の両面で小さく始める後押しとなる。
現場での導入イメージ
仮に導入支援に入るなら、次の流れを提案する。
-
棚卸し:ロボット化したい作業と、すでに残っている操作記録を洗い出す。誰が、どの作業で、どの程度の質の記録を持つかを可視化する。目指す到達点は、データの質のばらつきが成果を妨げている工程を特定し、担当者が共通認識を持つ状態である。
-
差し込み先の設計:新しいツールを増やさず、既存の記録システムや作業ログに「成功・失敗」「所要時間」「接触の有無」といった品質の手がかりを添える。これを品質タグへ変換する。目指す到達点は、現場の負担を増やさずにタグが自動で付く仕組みである。
-
小さく試す(PoC):一つの工程、一つの部署に限り、数週間で比較する。タグなしの学習とタグ付き条件付けの学習を並べ、現場担当者の実感で差を確かめる。目指す到達点は、「手直しが減りそうか」を現場が自分の言葉で判断できる状態である。
-
運用と横展開:タグの付け方と、微調整時にタグを固定する運用基準を文書化し、他の工程へ広げる。目指す到達点は、新しい作業を追加するたびにデータ整備をやり直さずに済む状態である。
全体として目指すのは、質の不揃いな現場データを「捨てる対象」から「資産」へ変えることである。
今後の展望
手法の優劣はモデルによって逆転する場合があり、万能の最適解は示されていない。自社の機種と作業で比較する工程を省くべきではない。一方、AXIS-Benchは利用者が独自の実機タスクを定義でき、公開された土台を使って自社条件を検証しやすい。品質を意識したデータ戦略が、ロボット導入の競争力を左右する局面が近づいている。
関連トピック
この記事のアイデアを、あなたの現場で試してみませんか。 どのくらいのコストで作れて、どのくらい手間やコストが減るかを一緒に試算し、試作から導入まで伴走します。
導入を相談する →同セクションの記事
空間理解AI、外部3D機能なしで3.6倍高速化
GeoThinker-Fは、空間理解AIが外部の3D解析器に頼らず、自らの内部情報から形状や次の場面を予測する手法である。推論遅延を1.45秒から0.40秒に縮め、現場実装の壁を下げる。
VITALが映像の動きから精密な運転操作を導く
映像の動きを骨格、残った誤差を残差として行動を表現する手法VITALが登場した。1段階の推論でも高い走行性能を保ち、速度は3.29倍になる。実時間制御の現場に効く成果である。
人の助言わずかで移動ロボ、30分で現場適応
移動しながら物をつかむロボットを、人の介入を学習の2割未満に抑え、約30分の実機学習で改善する枠組みHiRe-MoMaが登場した。現場調整の工数削減につながる。